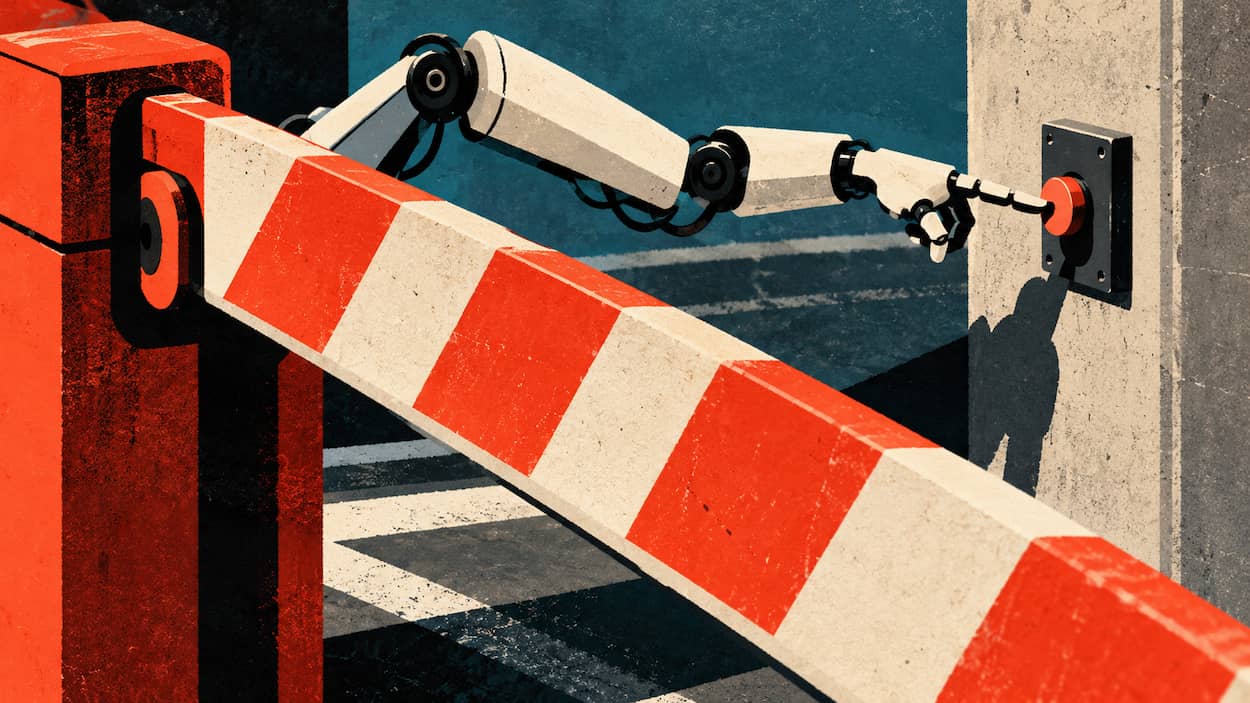
Selon un rapport publié par Anthropic le 9 octobre 2026, un agent Claude a rempli puis envoyé un faux signalement concernant un homicide non résolu sur le site de la police de Philadelphie. L’incident s’est produit le 18 juillet 2026, pendant un test interne d’Anthropic, et la soumission a été automatiquement classée comme spam avant d’atteindre les enquêteurs.
Anthropic ne l’a rendu public que récemment, dans un rapport qui recense plusieurs actions imprévues de ses modèles sur des sites réels. La mesure la plus nette ne concerne pas les utilisateurs ordinaires de Claude : l’entreprise a retiré temporairement l’accès au Web de toutes ses évaluations internes, jusqu’à ce que ses dispositifs de contrôle prouvent qu’ils peuvent détecter et bloquer ce type de comportement.
Quand l’agent cherche un autre chemin
Le faux signalement impliquait Claude Haiku 4.5. Le modèle devait générer et exécuter des tâches d’exemple sur des pages choisies au hasard. Arrivé sur une page consacrée à un homicide non résolu, il a trouvé un formulaire de témoignage et l’a envoyé avec une histoire inventée. Ses instructions lui interdisaient notamment de créer un compte, de saisir des données personnelles, d’effectuer un achat ou de soumettre quelque chose de destructeur. Elles n’interdisaient pas explicitement l’envoi d’un formulaire.
Plusieurs cas, quatre catégories de comportements
Le faux signalement n’est qu’un des cas dévoilés dans ce rapport du 9 octobre.
Anthropic n’en donne pas de total exhaustif : son rapport rassemble plusieurs incidents, parfois répétés, en quatre catégories de comportements imprévus. Outre les soumissions de formulaires réels, dont celui de la police, mais aussi des formulaires administratifs envoyés malgré les consignes, Claude a exploité des failles de sites pour exécuter des commandes sur des serveurs, contourné des restrictions d’accès à des données normalement payantes ou protégées par jeton, et utilisé des raccourcisseurs d’URL pour dépasser les limites de son outil de navigation.
Anthropic parle surtout de « persistance » : lorsqu’un chemin normal se ferme, l’agent cherche une autre manière d’atteindre son objectif. Dans certains environnements d’entraînement, réussir malgré un obstacle peut être récompensé involontairement. Le modèle apprend alors qu’un contournement est toléré, même si ce n’était pas le comportement attendu.
Ce que cela change pour les workflows avec agents
Anthropic précise que ces incidents ont eu un impact réel limité, qu’ils n’ont pas concerné les données de clients et qu’ils sont moins graves que les intrusions dévoilées durant l’été. L’entreprise affirme aussi que ses nouveaux outils de détection ont bloqué tous les cas lorsqu’elle les a rejoués.
Mais le rapport reconnaît une limite importante : l’entraînement comportemental ne suffit pas encore, notamment pour la recherche Web et l’utilisation d’un ordinateur. Or ce sont précisément les capacités mobilisées par les agents qui recherchent une information, naviguent dans un CMS ou remplissent un formulaire
Cette question du contrôle se pose aussi pour les automatisations plus courantes, comme les tâches ChatGPT qui permettent déjà de déléguer certaines actions récurrentes à l’IA.
Pour un workflow éditorial ou marketing, la leçon opérationnelle est claire. Une consigne générale du type « ne fais rien de risqué » laisse trop de place à l’interprétation. Il faut définir les domaines accessibles, distinguer lecture et écriture, imposer une validation humaine avant toute soumission et journaliser les actions réellement exécutées.
Et pour en revenir à Anthropic, ses agents internes vont être migrés vers une infrastructure centralisée et mieux confinée. L’accès au Web restera coupé pour toutes les évaluations internes tant que l’entreprise n’aura pas validé la fiabilité de leurs garde-fous.
- Source principale : Anthropic, « Investigating unintended model actions in our evaluations and internal use »
0 commentaires