C’est officiel, OpenAI déploie progressivement un filigrane invisible dans les textes générés par ChatGPT et Codex dans l’Union européenne. La généralisation doit s’effectuer au cours des prochaines semaines sur les sorties éligibles, sans calendrier plus précis selon les modèles ou les utilisateurs.
Le marquage n’apparaît ni sous forme de mention visible ni sous forme de caractères cachés. Il repose sur de légères variations dans les mots que le modèle privilégie lorsqu’il génère le texte, et peut rester présent lorsqu’un texte est copié-collé ailleurs.
Mais les propres tests d’OpenAI montrent aussi sa fragilité : sur des passages de 400 tokens testés par l’entreprise, le fait de remplacer une partie des mots par des synonymes suffit à faire chuter fortement le taux de détection.
Comment fonctionne textGrain, le filigrane invisible d’OpenAI
La technologie utilisée par OpenAI s’appelle textGrain. Lors de la génération, elle modifie légèrement la probabilité de certains choix de mots afin de créer un motif statistique invisible pour le lecteur, mais identifiable par un détecteur conçu pour le reconnaître.
Dans ChatGPT et Codex, le filigrane sera déployé progressivement sur les sorties textuelles éligibles dans l’Union européenne. OpenAI évoque une généralisation au cours des prochaines semaines, sans préciser quels comptes, modèles ou types de sorties sont déjà concernés.
Dans ce contexte, un utilisateur ne disposera pas d’indicateur dans ChatGPT lui permettant de vérifier si une sortie précise est marquée.
Les clients de l’API peuvent, eux, activer textGrain dans le monde entier sur certains modèles. A noter que l’option reste désactivée par défaut.
Ce filigrane ne prouve pas qu’un texte a été « écrit par l’IA »
Un filigrane détecté peut signaler qu’un système OpenAI a généré ou traité une partie du passage. Il ne permet pas de déterminer quelle part du texte provient de l’IA, combien de travail humain a été ajouté, ni qui en est l’auteur.
Inversement, l’absence de filigrane détectable ne prouve pas qu’un humain a rédigé le texte. Celui-ci peut être trop court, avoir été traduit ou réécrit, provenir d’un modèle non pris en charge ou avoir été produit avant l’activation du marquage.
Ce marquage a donc avant tout pour but de produire une signal de provenance, et non pas de mesurer la contribution humaine.
Quelques modifications suffisent à dégrader fortement la détection
Les évaluations publiées par OpenAI donnent une idée assez précise des limites du dispositif.
Avec un taux cible de faux positifs de 1 %, le détecteur identifie environ 80 % des passages de 200 tokens et 95 % des passages de 400 tokens sur certains contenus où le modèle dispose d’une certaine liberté dans ses choix de mots. Les performances baissent sur des textes plus contraints, notamment en mathématiques.
Surtout, sur des passages anglais de 400 tokens testés par OpenAI, le taux de détection passe d’environ 92 % à 66 % lorsque 10 % des mots sont remplacés par des synonymes.
Lorsque 25 % des mots sont remplacés, il tombe à 17 %.
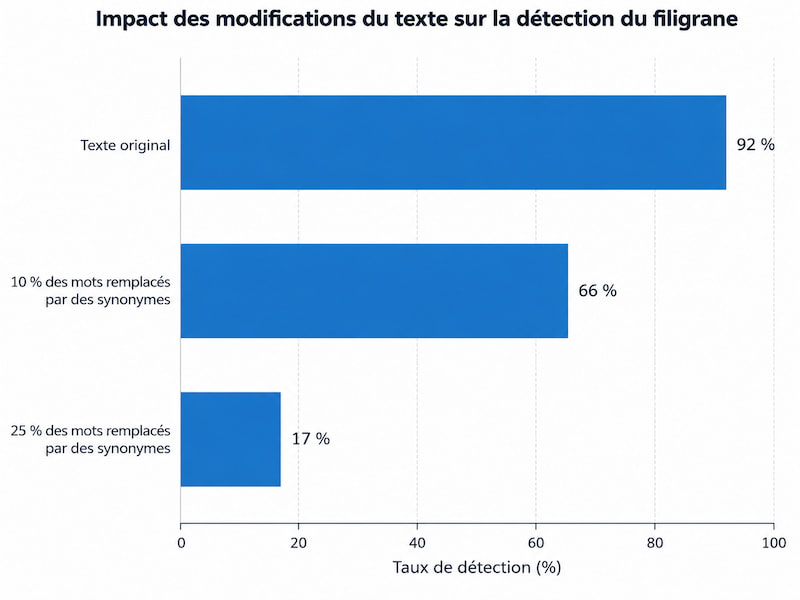
Cela ne signifie pas que toute retouche fait disparaître le filigrane : les résultats dépendent du texte et des modifications effectuées. Ils montrent en revanche qu’un marquage initialement détectable peut être fortement dégradé par la réécriture.
OpenAI limite notamment pour cette raison l’accès initial à son détecteur textuel à des chercheurs et organisations expertes approuvés.
Source principale : OpenAI, Our approach to EU text provenance rules.
0 commentaires