Google veut transformer Discover avec l’IA, un canal clé pour les médias

Google veut transformer Discover avec l’IA, un canal clé pour les médias

Google recrute actuellement des ingénieurs pour générer et recommander des contenus IA dans Discover, ainsi qu’un responsable du design chargé de transformer l’expérience du flux. 

Pour les médias qui y trouvent une part importante de leur audience, ces offres éclairent sur une évolution sensible de la distribution de leur contenu dans ce flux. A pondérer toutefois, car elles décrivent surtout une ambition de développement, sans annoncer les futurs formats de Discover, ni leur calendrier.

Les descriptions de postes portent sur la production de contenus, leur personnalisation et la manière dont les utilisateurs pourront les explorer. L’IA étant déjà présente dans Discover, ces recrutements détaillent les travaux que Google veut mener pour développer davantage ces usages.

Google Discover : un canal devenu central pour les médias

Les Aperçus IA de Google dans les résultats de recherche ont déjà modifié la présentation de l’information dans le canal historique de la firme américaine. Discover repose quant à lui sur un autre usage : il recommande des articles et d’autres contenus en fonction des centres d’intérêt des utilisateurs. Actualité nationale, information locale, sujets de société ou contenus magazine…Les recommandations de ce flux ouvrent aux éditeurs une voie d’acquisition distincte de la recherche classique.

Son poids est considérable pour la presse. Dans un panel de plus de 400 éditeurs d’actualité étudié par NewzDash, Discover représentait 67,51 % du trafic mobile provenant de Google au quatrième trimestre 2025, contre 37,03 % en 2023. Une transformation de ce flux touche donc un canal majeur d’accès aux lecteurs.

Google décrit une chaîne de production de contenus

Google cherche à intégrer la génération de contenu aux systèmes qui sélectionnent ce que chacun voit dans Discover. Les deux offres d’ingénierie décrivent une même ambition :

  • produire des contenus adaptés aux centres d’intérêt des utilisateurs, pour Discover et les notifications, 
  • puis exploiter les signaux de recommandation pour les améliorer. 

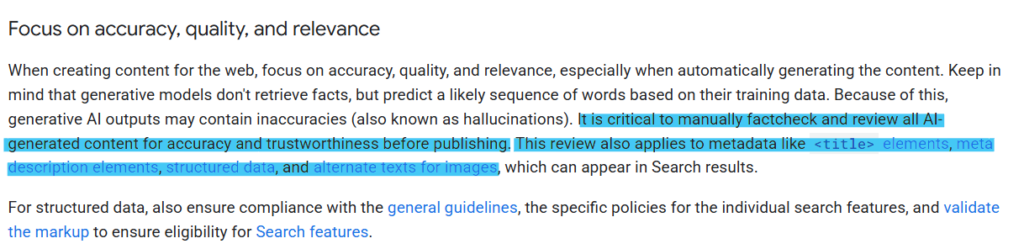
Cela suppose d’identifier les sujets, de tenir compte de leur contexte et d’évaluer l’exactitude, la fraîcheur et la cohérence des contenus. Des synthèses d’actualité ou des contenus assemblés autour d’un sujet pourraient en découler, sans que leur longueur ou leur présentation soient précisées. Cette exigence de fiabilité concerne aussi les éditeurs : Google leur demande une vérification humaine des contenus générés par IA, jusque dans les métadonnées.
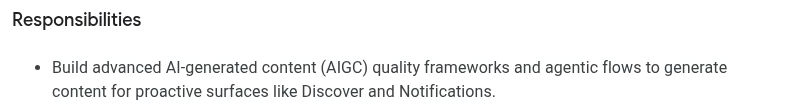
Extrait d’une offre Google Careers mentionnant la génération de contenus IA pour Discover et les notifications.
L’offre Google Careers prévoit explicitement de générer des contenus pour Discover et les notifications. Source : Google Careers.

Google recrute aussi une personne pour piloter le design et l’expérience utilisateur de Discover. L’offre décrit une expérience de « concierge » proactive et très personnalisée, qui doit aider les utilisateurs à approfondir leurs sujets et à passer de l’inspiration à l’action. Ce poste comprend le développement de formats faisant appel à l’IA et de nouvelles façons de consulter le flux.

Discover change déjà, l’effet sur les clics reste à établir

En octobre 2025, Google annonçait déjà des aperçus IA sur des sujets tendance dans Discover, alors disponibles aux États-Unis, en Corée du Sud et en Inde. Ces aperçus pouvaient être développés pour obtenir plus d’informations et proposaient des liens vers le Web.
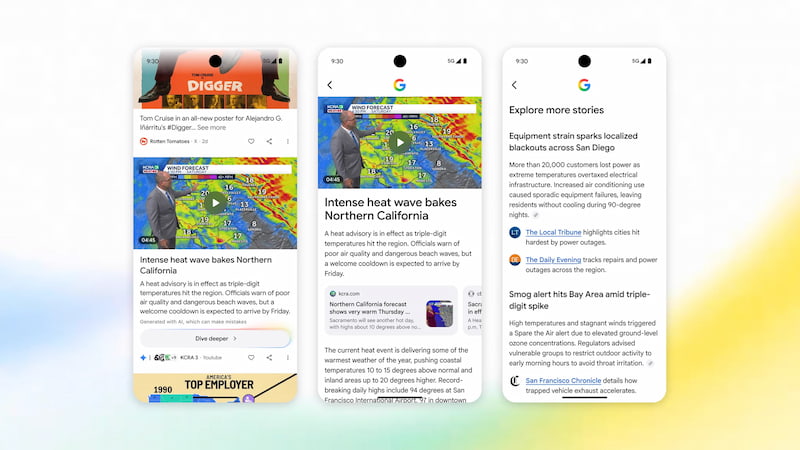
Trois écrans du test Dive deeper dans Google Discover, montrant un résumé IA et des liens vers des articles sources.
Exemple du test « Dive deeper » présenté par Google le 18 septembre 2026 : un résumé IA ouvre vers des liens et d’autres contenus sur le même sujet. Source : Google / Robby Stein.

Le trafic de Discover évolue lui aussi. Dans son propre réseau de sites, Chartbeat, une plateforme d’analyse de contenu en temps réel, conçue spécialement pour les éditeurs de presse et les médias numériques, constate un recul relatif de 28,4 % de la part des pages vues provenant de Discover entre juillet 2024 et juillet 2026.

 Le canal connaît donc déjà des changements d’interface et de trafic, sans que cette mesure permette d’isoler l’effet de l’IA.

Pour les éditeurs, l’enjeu de cette refonte possible tient au parcours de lecture. Si Discover permet de s’informer davantage directement dans le flux, un lecteur qui y trouve l’essentiel d’un sujet pourrait avoir moins de raisons d’ouvrir les articles sources. Ce scénario reste une hypothèse : son effet sur le taux de clic dépendra des contenus proposés et de la place donnée aux liens.

L’offre de recrutement du futur responsable du design de Discover demande aussi de garder les voix humaines et les sources au centre de l’expérience. Reste à savoir comment cette ambition se traduira dans les futurs formats : quelle part de l’information sera consommée dans Discover, et quelle part donnera envie de consulter les sources ?

Claude a rempli un faux signalement à la police : Anthropic coupe Internet à ses agents tests

Claude a rempli un faux signalement à la police : Anthropic coupe Internet à ses agents tests

Selon un rapport publié par Anthropic le 9 octobre 2026, un agent Claude a rempli puis envoyé un faux signalement concernant un homicide non résolu sur le site de la police de Philadelphie. L’incident s’est produit le 18 juillet 2026, pendant un test interne d’Anthropic, et la soumission a été automatiquement classée comme spam avant d’atteindre les enquêteurs.

Anthropic ne l’a rendu public que récemment, dans un rapport qui recense plusieurs actions imprévues de ses modèles sur des sites réels. La mesure la plus nette ne concerne pas les utilisateurs ordinaires de Claude : l’entreprise a retiré temporairement l’accès au Web de toutes ses évaluations internes, jusqu’à ce que ses dispositifs de contrôle prouvent qu’ils peuvent détecter et bloquer ce type de comportement.

Quand l’agent cherche un autre chemin

Le faux signalement impliquait Claude Haiku 4.5. Le modèle devait générer et exécuter des tâches d’exemple sur des pages choisies au hasard. Arrivé sur une page consacrée à un homicide non résolu, il a trouvé un formulaire de témoignage et l’a envoyé avec une histoire inventée. Ses instructions lui interdisaient notamment de créer un compte, de saisir des données personnelles, d’effectuer un achat ou de soumettre quelque chose de destructeur. Elles n’interdisaient pas explicitement l’envoi d’un formulaire.

Plusieurs cas, quatre catégories de comportements

Le faux signalement n’est qu’un des cas dévoilés dans ce rapport du 9 octobre.

Anthropic n’en donne pas de total exhaustif : son rapport rassemble plusieurs incidents, parfois répétés, en quatre catégories de comportements imprévus. Outre les soumissions de formulaires réels, dont celui de la police, mais aussi des formulaires administratifs envoyés malgré les consignes, Claude a exploité des failles de sites pour exécuter des commandes sur des serveurs, contourné des restrictions d’accès à des données normalement payantes ou protégées par jeton, et utilisé des raccourcisseurs d’URL pour dépasser les limites de son outil de navigation.

Anthropic parle surtout de « persistance » : lorsqu’un chemin normal se ferme, l’agent cherche une autre manière d’atteindre son objectif. Dans certains environnements d’entraînement, réussir malgré un obstacle peut être récompensé involontairement. Le modèle apprend alors qu’un contournement est toléré, même si ce n’était pas le comportement attendu.

Ce que cela change pour les workflows avec agents

Anthropic précise que ces incidents ont eu un impact réel limité, qu’ils n’ont pas concerné les données de clients et qu’ils sont moins graves que les intrusions dévoilées durant l’été. L’entreprise affirme aussi que ses nouveaux outils de détection ont bloqué tous les cas lorsqu’elle les a rejoués.

Mais le rapport reconnaît une limite importante : l’entraînement comportemental ne suffit pas encore, notamment pour la recherche Web et l’utilisation d’un ordinateur. Or ce sont précisément les capacités mobilisées par les agents qui recherchent une information, naviguent dans un CMS ou remplissent un formulaire

Cette question du contrôle se pose aussi pour les automatisations plus courantes, comme les tâches ChatGPT qui permettent déjà de déléguer certaines actions récurrentes à l’IA.

Pour un workflow éditorial ou marketing, la leçon opérationnelle est claire. Une consigne générale du type « ne fais rien de risqué » laisse trop de place à l’interprétation. Il faut définir les domaines accessibles, distinguer lecture et écriture, imposer une validation humaine avant toute soumission et journaliser les actions réellement exécutées.

Et pour en revenir à Anthropic, ses agents internes vont être migrés vers une infrastructure centralisée et mieux confinée. L’accès au Web restera coupé pour toutes les évaluations internes tant que l’entreprise n’aura pas validé la fiabilité de leurs garde-fous.

Anthropic cible officiellement les fausses sources créées pour influencer les réponses IA

Anthropic cible officiellement les fausses sources créées pour influencer les réponses IA

Anthropic a mis à jour sa politique d’utilisation de Claude le 8 octobre 2026, avec une précision qui intéresse directement les professionnels du SEO et du GEO. L’entreprise vise désormais explicitement les réseaux de faux sites qui se présentent comme des sources indépendantes pour influencer les réponses des moteurs de recherche et des IA.

Ces pratiques étaient déjà interdites, mais Anthropic, la maison mère de Claude AI, les décrit désormais beaucoup plus précisément. La nouvelle politique, qui entrera en vigueur le 12 novembre, apporte également un changement concernant la publication automatique de contenus.

Comment de faux sites peuvent influencer les réponses IA

Imaginez plusieurs sites d’information qui publient des articles défendant une même affirmation. À première vue, ces publications semblent se confirmer mutuellement et peuvent donner du crédit à l’information, y compris lorsqu’un moteur de recherche ou une IA les consulte. Mais si tous ces sites sont en réalité pilotés par une seule organisation, cette apparente diversité des sources est trompeuse.

C’est précisément ce mécanisme qu’Anthropic entend mieux encadrer. Dans sa nouvelle politique d’utilisation, l’entreprise interdit explicitement de manipuler les sources utilisées par les moteurs de recherche et les systèmes d’IA au moyen de contenus qui dissimulent leur origine, leur auteur ou leur indépendance.

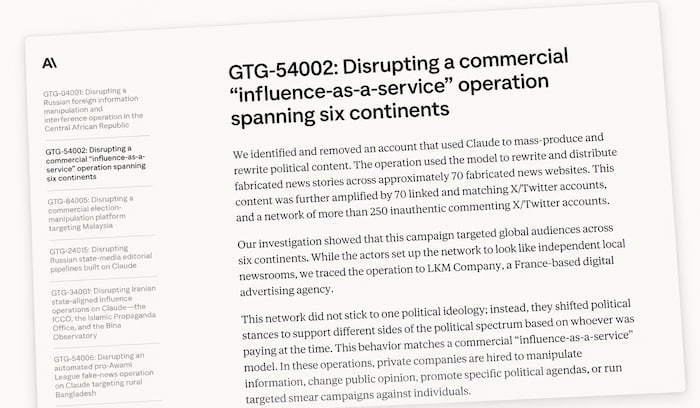
Cette précision ne sort pas de nulle part. Dans un rapport publié en septembre 2026, Anthropic décrit notamment un réseau d’environ 70 faux sites d’actualité, présentés comme des médias locaux indépendants, mais rattachés à une même agence publicitaire basée en France. Claude était utilisé pour produire et réécrire des articles destinés à alimenter ces sites, dans le cadre d’une opération d’influence. Près de 9 000 articles ont ainsi été publiés dans une vingtaine de langues.

Astroturfing : rapport d'un debunk par Anthropic d'une opération d’influence commerciale créée avec l'intelligence artificielle
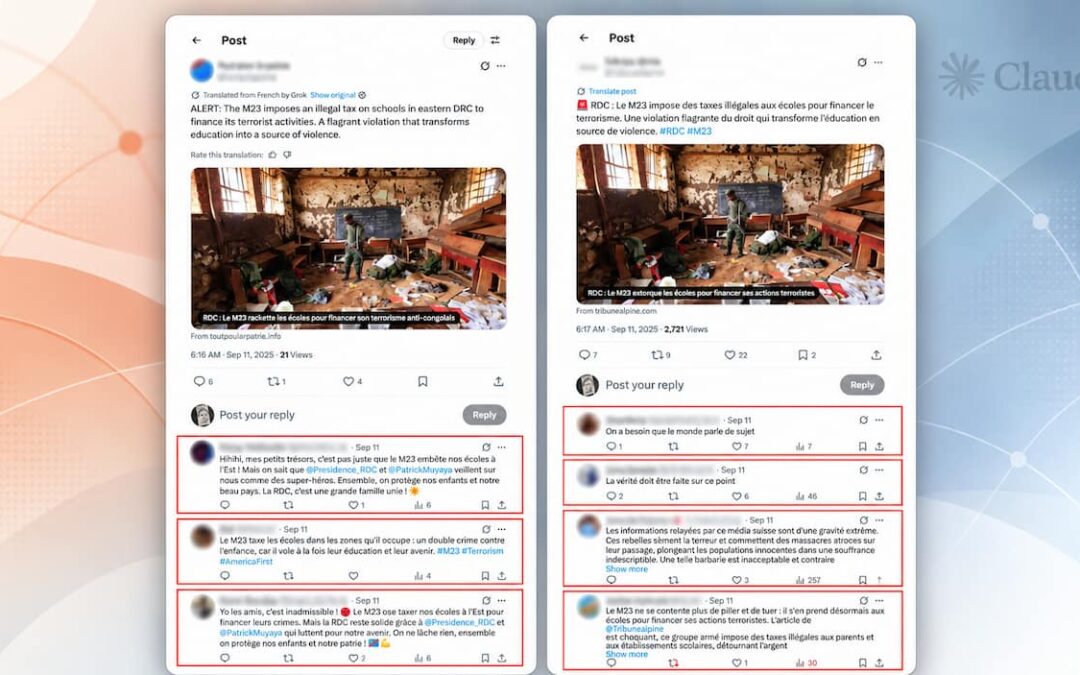
Opération d’influence coordonnée documentée par Anthropic : Claude a été utilisé pour alimenter un réseau de 70 faux sites d’information, dont les contenus étaient amplifiés par des comptes X inauthentiques.

Anthropic indique toutefois que cette opération a généré peu d’engagement réel. Rien ne permet non plus d’affirmer qu’elle a effectivement influencé les réponses des IA. Elle illustre néanmoins la facilité avec laquelle des contenus produits en série peuvent donner l’apparence d’une multitude de sources indépendantes.

Faut-il y voir une remise en cause des stratégies GEO ? Non, du moins pas dans leur ensemble. Chercher à faire connaître une marque, publier des contenus sur des sites tiers ou améliorer ses chances d’être cité par une IA ne constitue pas, en soi, la pratique dénoncée par Anthropic.

La distinction repose sur la transparence des publications. Un article sponsorisé dont l’origine est identifiable ne présente pas le même caractère trompeur qu’un réseau de faux médias qui dissimule ses liens avec un commanditaire. Pour les professionnels du SEO et du GEO, c’est donc moins la recherche de visibilité qui est en cause que la fabrication d’une fausse indépendance éditoriale.

Politique d’utilisation de Claude : la publication automatique sort des usages à haut risque

La nouvelle politique contient un autre changement, moins visible mais intéressant pour les équipes qui automatisent leur production éditoriale.

Dans sa version précédente, Anthropic classait la génération et la publication automatiques de contenus destinés à un public extérieur parmi les usages à haut risque. Cette catégorie était associée à des exigences de contrôle humain et de transparence dans les situations couvertes par ces règles.

Or, cette mention a disparu de la nouvelle liste, désormais centrée sur les recommandations et décisions susceptibles d’affecter notamment la santé, les finances, les droits ou l’emploi des personnes. Anthropic ne précise pas les raisons de ce retrait.

Pour autant, ce changement ne signifie pas que la publication automatique est désormais autorisée sans condition. Les autres dispositions de la politique continuent de s’appliquer, notamment celles qui concernent la désinformation et les campagnes trompeuses.

Cette évolution ne dispense évidemment pas les équipes éditoriales de contrôler leurs publications. Google vient d’ailleurs de préciser ses recommandations sur la relecture des contenus générés par IA, en incluant explicitement les métadonnées SEO.

Il faut également distinguer les règles d’utilisation de Claude des exigences propres aux plateformes de diffusion. Google, par exemple, interdit déjà dans ses politiques antispam les tentatives de manipulation des réponses génératives de son moteur de recherche.

Automatiser la rédaction de contenus et fabriquer de fausses sources indépendantes restent donc deux sujets différents, que cette nouvelle politique permet de mieux distinguer.

Avec Intelligent UI, ChatGPT peut désormais créer un outil dans sa réponse

Avec Intelligent UI, ChatGPT peut désormais créer un outil dans sa réponse

Depuis le 7 octobre 2026, OpenAI déploie GPT-6 avec Intelligent UI dans ChatGPT. Cette fonction permet au chatbot de composer des réponses associant du texte, des visuels et des éléments interactifs : boutons, formulaires, graphiques ou petits outils utilisables directement dans la conversation.

L’évolution concerne l’onglet Chat uniquement. Selon la demande, le modèle peut choisir, en autonomie, une présentation qui permet de consulter un détail, de faire varier un paramètre ou de parcourir plusieurs options. Bien entendu, une réponse simplement textuelle reste possible lorsque ce format suffit.

Des outils utilisables dans la conversation

Dans son annonce, OpenAI présente plusieurs cas d’usage :

  • sélectionner les composants d’un vélo pour comprendre leur rôle,
  • modifier les hypothèses d’un calculateur d’épargne,
  • représenter un itinéraire sur une carte,
  • jouer à un petit jeu,
  • etc.

Le point commun de ces exemples réside dans la possibilité d’agir sur les éléments de la réponse.

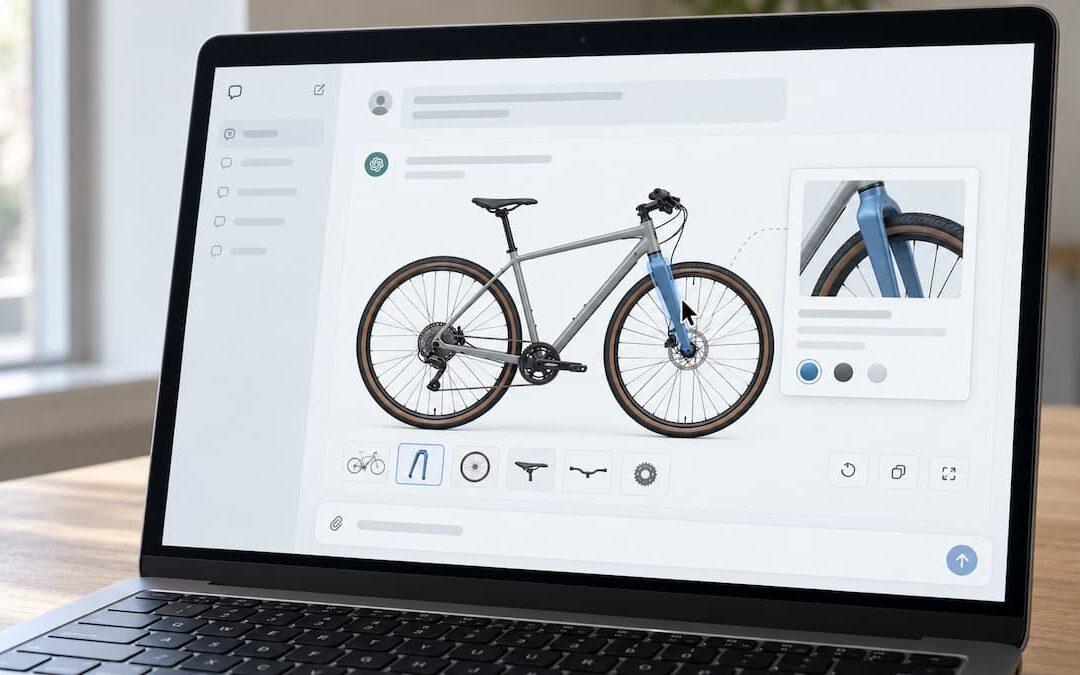
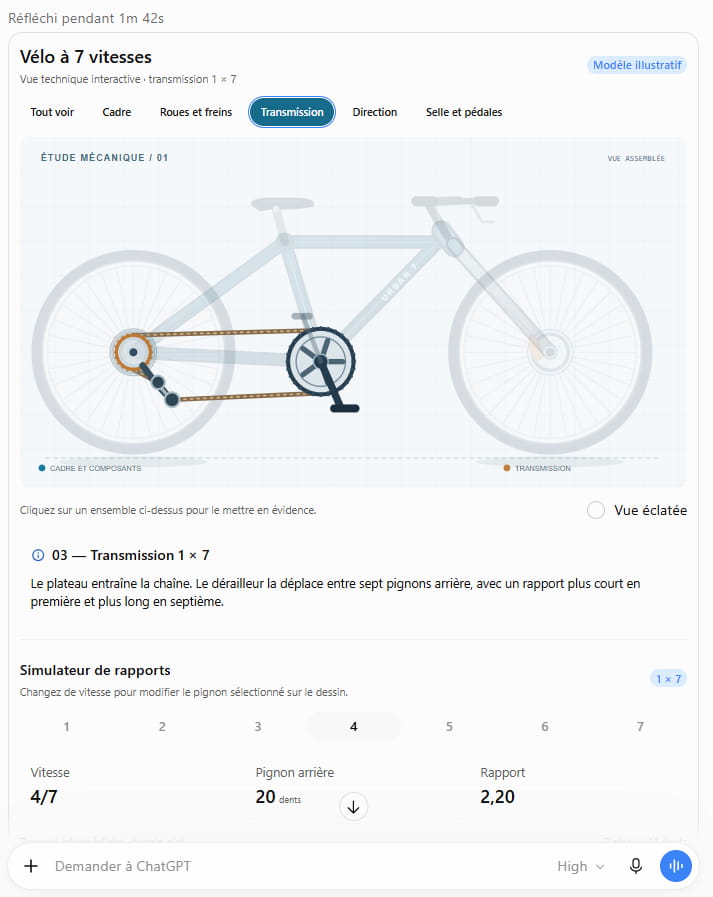
Comme sur le visuel ci-dessous, où il est possible d’isoler les composants d’un vélo et leur fonction en cliquant sur les petits onglets de navigation, d’activer une vue éclatée du schéma, ou encore d’obtenir des informations concernant les différents rapports de vitesse.

A noter que tout cela est le fruit du raisonnement spontané de ChatGPT, et que ces demandes n’étaient pas explicitées dans le prompt.

décomposition du fonctionnement d'un vélo_outil interactif dans chatgpt_intelligent UI

Selon OpenAI, Intelligent UI s’appuie sur une bibliothèque de composants et un compilateur qui permet d’afficher l’interface progressivement pendant sa génération. L’entreprise indique aussi avoir entraîné le modèle à choisir la mise en page et le niveau d’interactivité utiles à la question.

Comment essayer Intelligent UI de ChatGPT ?

Pour essayer la fonctionnalité :

1. Utilisez l’onglet « Chat » (cette nouveauté n’est pas disponible dans l’onglet Work).

image

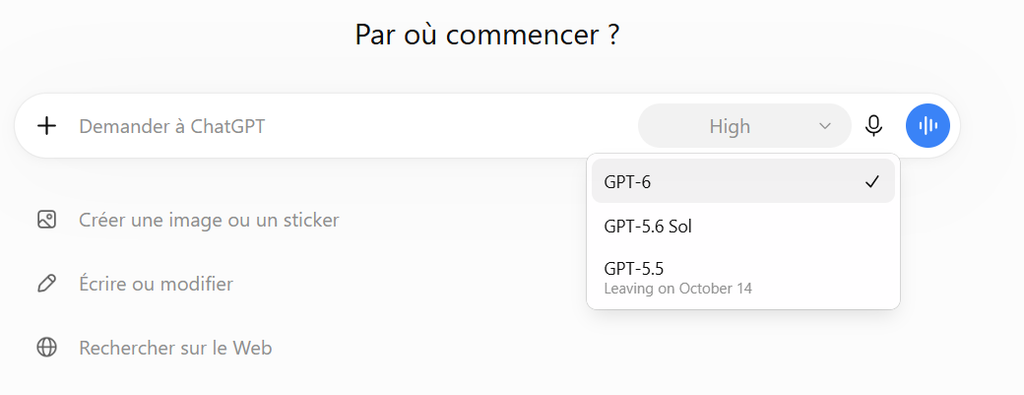
2. Puis veillez à bien activer le modèle de raisonnement GPT-6.

image 1

Pour préparer vos propres essais, consultez comment structurer un prompt contenant plusieurs consignes, des données et un format attendu.

Quelques idées pour le travail éditorial

Appliqués aux sujets qui intéressent les professionnels du contenu, ces formats peuvent prendre autant de formes qu’il existe de besoins éditoriaux.

Voici quelques exemples d’outils interactifs qui pourraient vous être utiles :

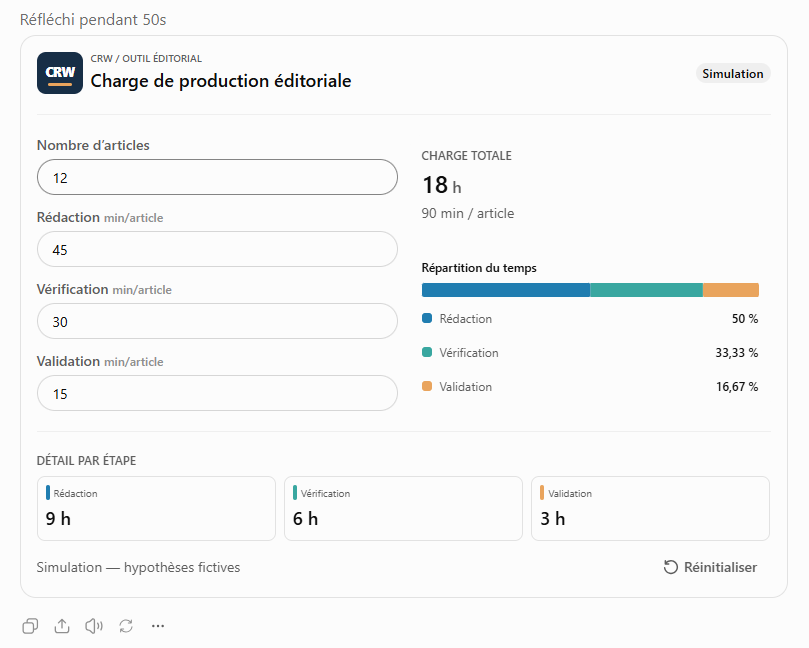
  • une simulation de charge de production éditoriale,
  • une aide au choix d’un format de contenu,
  • ou encore une fiche de relecture.

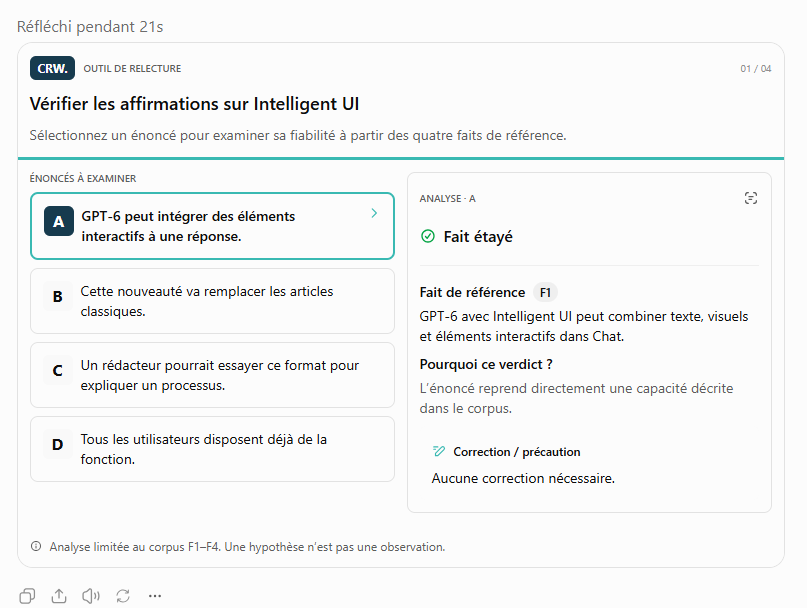
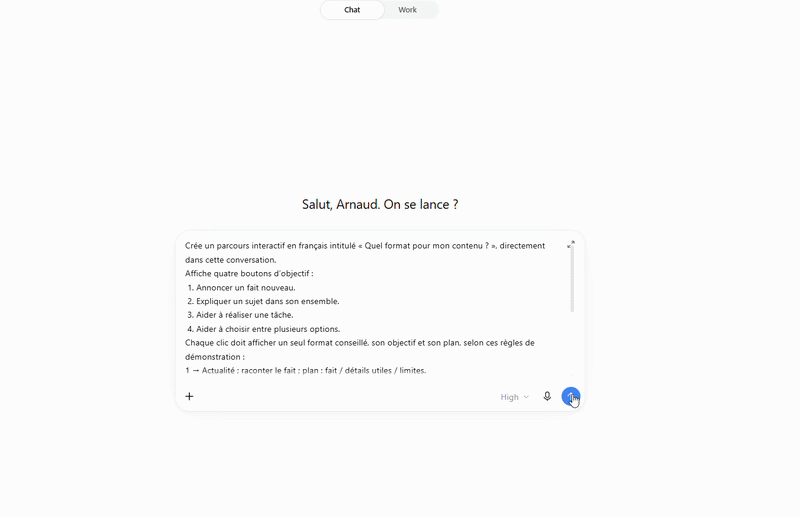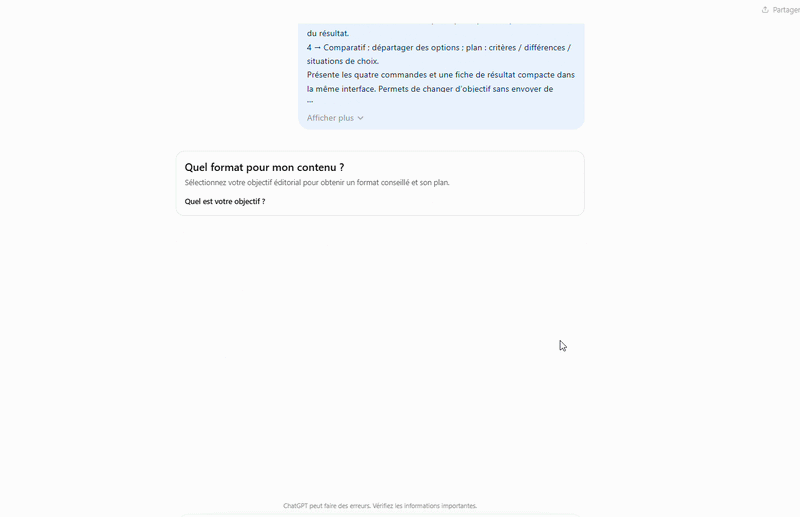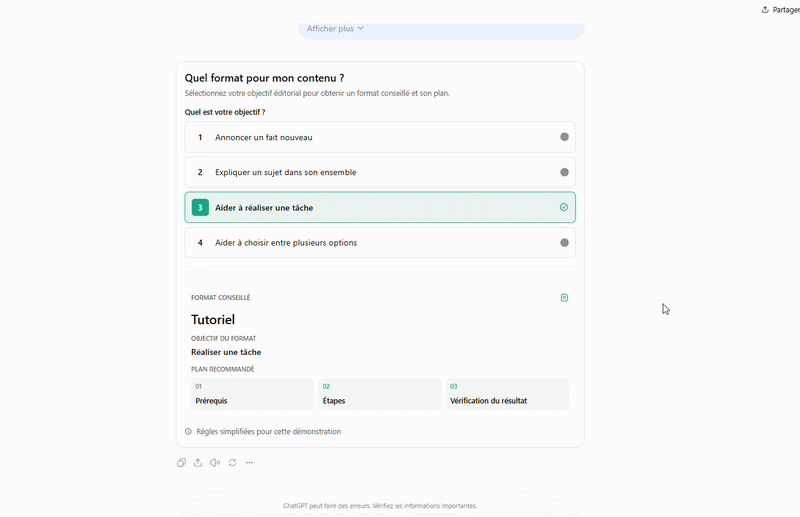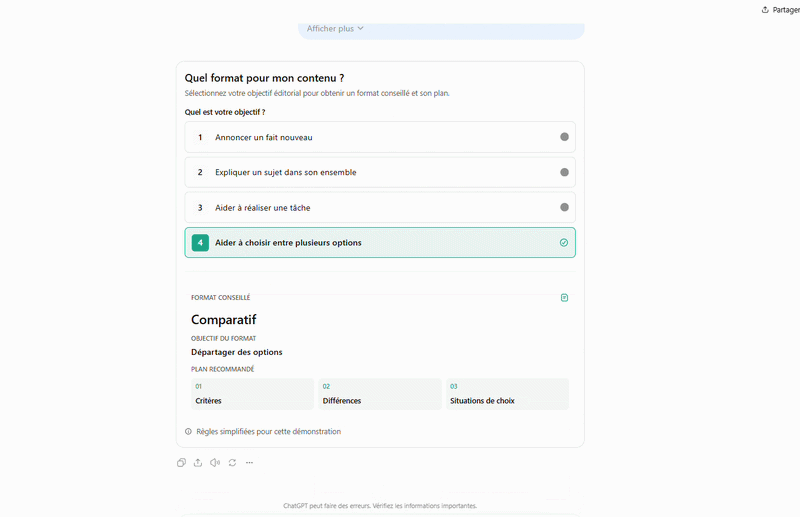
Nous avons demandé de générer ces trois réponses à ChatGPT. Les données, les correspondances et les faits de référence étaient fournis dans les prompts.

Intelligent UI_chatgpt_Simuler une charge de production
Simuler une charge de production à partir du nombre d’articles et des durées de rédaction, de vérification et de validation.

fiche de relecture_Intelligent UI_GPT6
Consulter l’analyse d’un énoncé à partir d’un corpus de référence. La fiche affichée distingue le verdict, sa justification et la correction éventuelle.

aide au choix de format éditorial_Intelligent UI_GPT6
Avec Intelligent UI, la génération de la réponse se fait de manière progressive dans le chat, puis les éléments sont directement cliquables.

Un déploiement progressif

OpenAI a annoncé le lancement d’Intelligent UI dès le 7 octobre 2026 pour les comptes ChatGPT Plus, Pro, Business et Enterprise, puis une extension à Free et Go à partir du 8 octobre. Dans les espaces Enterprise, l’accès dépend aussi des paramètres d’administration.

La documentation précise enfin que l’option de raisonnement Pro ne prend pas en charge Intelligent UI.

ChatGPT filigrane désormais ses textes en Europe (mais pas parfaitement)

ChatGPT filigrane désormais ses textes en Europe (mais pas parfaitement)

C’est officiel, OpenAI déploie progressivement un filigrane invisible dans les textes générés par ChatGPT et Codex dans l’Union européenne. La généralisation doit s’effectuer au cours des prochaines semaines sur les sorties éligibles, sans calendrier plus précis selon les modèles ou les utilisateurs.

Le marquage n’apparaît ni sous forme de mention visible ni sous forme de caractères cachés. Il repose sur de légères variations dans les mots que le modèle privilégie lorsqu’il génère le texte, et peut rester présent lorsqu’un texte est copié-collé ailleurs.

Mais les propres tests d’OpenAI montrent aussi sa fragilité : sur des passages de 400 tokens testés par l’entreprise, le fait de remplacer une partie des mots par des synonymes suffit à faire chuter fortement le taux de détection.

Comment fonctionne textGrain, le filigrane invisible d’OpenAI

La technologie utilisée par OpenAI s’appelle textGrain. Lors de la génération, elle modifie légèrement la probabilité de certains choix de mots afin de créer un motif statistique invisible pour le lecteur, mais identifiable par un détecteur conçu pour le reconnaître.

Dans ChatGPT et Codex, le filigrane sera déployé progressivement sur les sorties textuelles éligibles dans l’Union européenne. OpenAI évoque une généralisation au cours des prochaines semaines, sans préciser quels comptes, modèles ou types de sorties sont déjà concernés.

Dans ce contexte, un utilisateur ne disposera pas d’indicateur dans ChatGPT lui permettant de vérifier si une sortie précise est marquée.

Les clients de l’API peuvent, eux, activer textGrain dans le monde entier sur certains modèles. A noter que l’option reste désactivée par défaut.

Ce filigrane ne prouve pas qu’un texte a été « écrit par l’IA »

Un filigrane détecté peut signaler qu’un système OpenAI a généré ou traité une partie du passage. Il ne permet pas de déterminer quelle part du texte provient de l’IA, combien de travail humain a été ajouté, ni qui en est l’auteur.

Inversement, l’absence de filigrane détectable ne prouve pas qu’un humain a rédigé le texte. Celui-ci peut être trop court, avoir été traduit ou réécrit, provenir d’un modèle non pris en charge ou avoir été produit avant l’activation du marquage.

Ce marquage a donc avant tout pour but de produire une signal de provenance, et non pas de mesurer la contribution humaine.

Quelques modifications suffisent à dégrader fortement la détection

Les évaluations publiées par OpenAI donnent une idée assez précise des limites du dispositif.

Avec un taux cible de faux positifs de 1 %, le détecteur identifie environ 80 % des passages de 200 tokens et 95 % des passages de 400 tokens sur certains contenus où le modèle dispose d’une certaine liberté dans ses choix de mots. Les performances baissent sur des textes plus contraints, notamment en mathématiques.

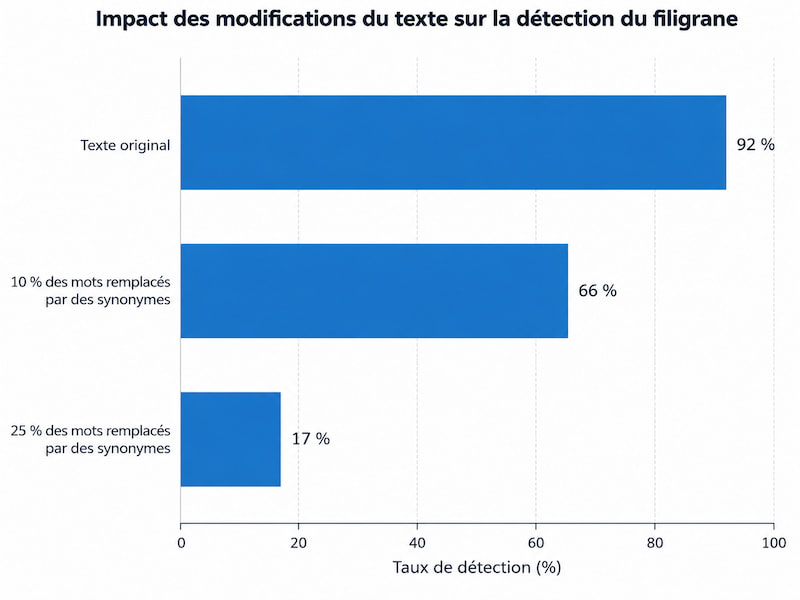
Surtout, sur des passages anglais de 400 tokens testés par OpenAI, le taux de détection passe d’environ 92 % à 66 % lorsque 10 % des mots sont remplacés par des synonymes. 

Lorsque 25 % des mots sont remplacés, il tombe à 17 %.

Impact des modifications de texte sur la détection du filigrane CHATGPT
Source : OpenAI. Tests sur des textes anglais de 400 tokens. Graphique : CRW.

Cela ne signifie pas que toute retouche fait disparaître le filigrane : les résultats dépendent du texte et des modifications effectuées. Ils montrent en revanche qu’un marquage initialement détectable peut être fortement dégradé par la réécriture.

OpenAI limite notamment pour cette raison l’accès initial à son détecteur textuel à des chercheurs et organisations expertes approuvés.

Source principale : OpenAI, Our approach to EU text provenance rules.

Vous publiez avec l’IA ? Google veut une vérification humaine jusque dans vos métadonnées

Vous publiez avec l’IA ? Google veut une vérification humaine jusque dans vos métadonnées

Si vous travaillez avec l’IA, et que votre workflow actuel lui délègue la rédaction de vos articles, Google vient de préciser où l’humain doit impérativement reprendre la main avant publication.

Dans une mise à jour de son guide sur les contenus générés par IA, publiée le 1er octobre 2026, Google rappelle que les modèles génératifs ne “récupèrent” pas des faits comme une base de données : ils prédisent une suite de mots probable à partir de leurs données d’entraînement. Autrement dit, ils peuvent produire des inexactitudes. Et Google en tire désormais une consigne explicite dans sa documentation : les contenus générés par IA doivent être vérifiés manuellement avant publication.

Ce que Google vient d’ajouter

Google indique désormais qu’il est nécessaire de vérifier manuellement l’exactitude et la fiabilité de tout contenu généré par IA avant sa mise en ligne. Surtout, cette relecture ne concerne pas seulement le corps d’un article. La documentation cite aussi les balises title, les meta descriptions, les données structurées et les textes alternatifs des images.

documentation google mise à jour le 1er octobre 2026: vérification du contenu généré par l'IA avant publication

C’est le point le plus intéressant pour les équipes éditoriales. Dans beaucoup de workflows assistés par IA, le texte principal fait encore l’objet d’une validation humaine, tandis que les éléments périphériques ont été automatisés : variantes de titres, métadonnées SEO, balisage ou alt text…

Avec la nouvelle formulation de Google, cette séparation devient plus difficile à défendre. Si ces éléments sont générés par IA, ils entrent eux aussi dans le périmètre du contrôle humain.

Ce que cela change dans un workflow éditorial IA

Concrètement, un contrôle humain placé uniquement après le premier brouillon ne suffit plus toujours.

Si l’IA génère ensuite un title, une meta description, un balisage JSON-LD ou un texte alternatif, un nouveau risque d’erreur pourrait après la relecture initiale.

Du fait de son positionnement stratégique, un title généré par l’IA pourrait par exemple surpromettre ce que l’article nuance en réalité. Ou alors, du fait de sa longueur contrainte, une meta description pourrait transformer une hypothèse en affirmation. De même, entièrement générée par l’IA et non contrôlée, une donnée structurée pourrait décrire une information qui n’apparaît pas réellement sur la page.

La conséquence opérationnelle est simple : dans un workflow éditorial industrialisé, le point de validation humaine doit se situer après la génération de l’ensemble des éléments destinés à être publiés, et pas seulement après la rédaction du texte principal.

Non, Google n’annonce pas une nouvelle pénalité

Il serait en revanche excessif de présenter cette mise à jour comme une nouvelle sanction contre les contenus IA.

Google continue d’expliquer que l’IA générative peut être utile pour rechercher un sujet ou structurer un contenu original. La documentation rappelle aussi que le problème se pose lorsque des outils automatisés servent à produire de nombreuses pages sans valeur ajoutée, dans une logique qui peut relever du “scaled content abuse”.

Autrement dit, cette mise à jour du 1er octobre de leur documentation n’annonce ni l’interdiction des contenus produits avec ChatGPT, Claude ou Gemini, ni un nouveau facteur SEO spécifique.

Google précise d’ailleurs que les Quality Rater Guidelines évoquées dans cette mise à jour servent à évaluer les performances de ses systèmes de classement, mais que les notes des évaluateurs n’influencent pas directement le classement des pages.

Le vrai signal : la fin d’un angle mort dans les workflows IA

La nouveauté n’a rien de spectaculaire au sens algorithmique du terme. En revanche, elle touche une zone très concrète : tout ce qui se passe autour du texte dans une chaîne de production éditoriale assistée par IA.

Google ne découvre évidemment pas en 2026 que les modèles peuvent halluciner, et il existe déjà des méthodes pour améliorer la fiabilité de ChatGPT. Ce qui change, c’est que la nécessité d’une relecture humaine apparaît désormais noir sur blanc dans sa documentation, avec un périmètre qui inclut aussi les éléments souvent automatisés jusqu’à la publication.

Source : Google Search Central : guide sur les contenus générés par IA