Google recrute actuellement des ingénieurs pour générer et recommander des contenus IA dans Discover, ainsi qu’un responsable du design chargé de transformer l’expérience du flux.
Pour les médias qui y trouvent une part importante de leur audience, ces offres éclairent sur une évolution sensible de la distribution de leur contenu dans ce flux. A pondérer toutefois, car elles décrivent surtout une ambition de développement, sans annoncer les futurs formats de Discover, ni leur calendrier.
Les descriptions de postes portent sur la production de contenus, leur personnalisation et la manière dont les utilisateurs pourront les explorer. L’IA étant déjà présente dans Discover, ces recrutements détaillent les travaux que Google veut mener pour développer davantage ces usages.
Google Discover : un canal devenu central pour les médias
Les Aperçus IA de Google dans les résultats de recherche ont déjà modifié la présentation de l’information dans le canal historique de la firme américaine. Discover repose quant à lui sur un autre usage : il recommande des articles et d’autres contenus en fonction des centres d’intérêt des utilisateurs. Actualité nationale, information locale, sujets de société ou contenus magazine…Les recommandations de ce flux ouvrent aux éditeurs une voie d’acquisition distincte de la recherche classique.
Son poids est considérable pour la presse. Dans un panel de plus de 400 éditeurs d’actualité étudié par NewzDash, Discover représentait 67,51 % du trafic mobile provenant de Google au quatrième trimestre 2025, contre 37,03 % en 2023. Une transformation de ce flux touche donc un canal majeur d’accès aux lecteurs.
Google décrit une chaîne de production de contenus
Google cherche à intégrer la génération de contenu aux systèmes qui sélectionnent ce que chacun voit dans Discover. Les deux offres d’ingénierie décrivent une même ambition :
produire des contenus adaptés aux centres d’intérêt des utilisateurs, pour Discover et les notifications,
puis exploiter les signaux de recommandation pour les améliorer.
Cela suppose d’identifier les sujets, de tenir compte de leur contexte et d’évaluer l’exactitude, la fraîcheur et la cohérence des contenus. Des synthèses d’actualité ou des contenus assemblés autour d’un sujet pourraient en découler, sans que leur longueur ou leur présentation soient précisées. Cette exigence de fiabilité concerne aussi les éditeurs : Google leur demande une vérification humaine des contenus générés par IA, jusque dans les métadonnées.
L’offre Google Careers prévoit explicitement de générer des contenus pour Discover et les notifications. Source : Google Careers.
Google recrute aussi une personne pour piloter le design et l’expérience utilisateur de Discover. L’offre décrit une expérience de « concierge » proactive et très personnalisée, qui doit aider les utilisateurs à approfondir leurs sujets et à passer de l’inspiration à l’action. Ce poste comprend le développement de formats faisant appel à l’IA et de nouvelles façons de consulter le flux.
Discover change déjà, l’effet sur les clics reste à établir
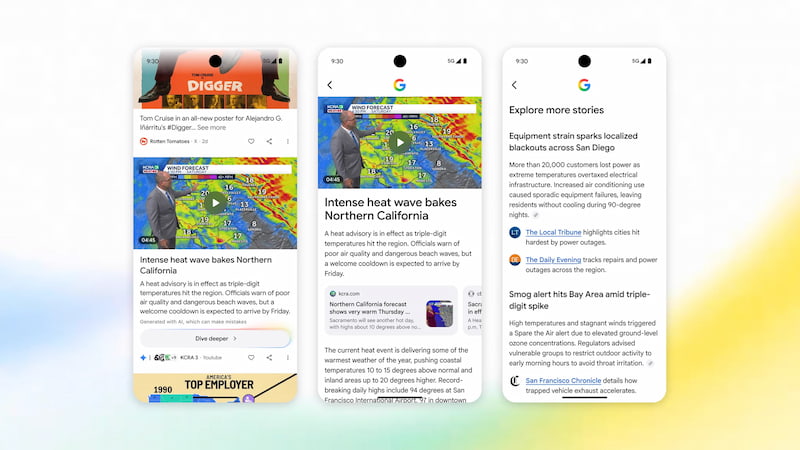
En octobre 2025, Google annonçait déjà des aperçus IA sur des sujets tendance dans Discover, alors disponibles aux États-Unis, en Corée du Sud et en Inde. Ces aperçus pouvaient être développés pour obtenir plus d’informations et proposaient des liens vers le Web.
Exemple du test « Dive deeper » présenté par Google le 18 septembre 2026 : un résumé IA ouvre vers des liens et d’autres contenus sur le même sujet. Source : Google / Robby Stein.
Le trafic de Discover évolue lui aussi. Dans son propre réseau de sites, Chartbeat, une plateforme d’analyse de contenu en temps réel, conçue spécialement pour les éditeurs de presse et les médias numériques, constate un recul relatif de 28,4 % de la part des pages vues provenant de Discover entre juillet 2024 et juillet 2026.
Le canal connaît donc déjà des changements d’interface et de trafic, sans que cette mesure permette d’isoler l’effet de l’IA.
Pour les éditeurs, l’enjeu de cette refonte possible tient au parcours de lecture. Si Discover permet de s’informer davantage directement dans le flux, un lecteur qui y trouve l’essentiel d’un sujet pourrait avoir moins de raisons d’ouvrir les articles sources. Ce scénario reste une hypothèse : son effet sur le taux de clic dépendra des contenus proposés et de la place donnée aux liens.
L’offre de recrutement du futur responsable du design de Discover demande aussi de garder les voix humaines et les sources au centre de l’expérience. Reste à savoir comment cette ambition se traduira dans les futurs formats : quelle part de l’information sera consommée dans Discover, et quelle part donnera envie de consulter les sources ?
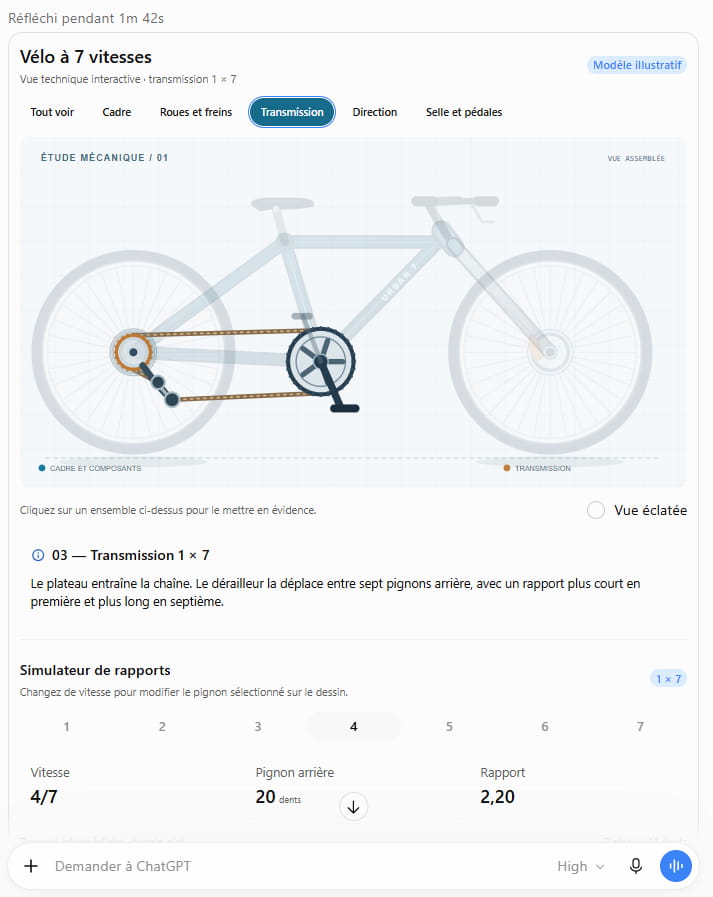
Depuis le 7 octobre 2026, OpenAI déploie GPT-6 avec Intelligent UI dans ChatGPT. Cette fonction permet au chatbot de composer des réponsesassociant du texte, des visuels et des éléments interactifs : boutons, formulaires, graphiques ou petits outils utilisables directement dans la conversation.
L’évolution concerne l’onglet Chat uniquement. Selon la demande, le modèle peut choisir, en autonomie, une présentation qui permet de consulter un détail, de faire varier un paramètre ou de parcourir plusieurs options. Bien entendu, une réponse simplement textuelle reste possible lorsque ce format suffit.
Des outils utilisables dans la conversation
Dans son annonce, OpenAI présente plusieurs cas d’usage :
sélectionner les composants d’un vélo pour comprendre leur rôle,
modifier les hypothèses d’un calculateur d’épargne,
représenter un itinéraire sur une carte,
jouer à un petit jeu,
etc.
Le point commun de ces exemples réside dans la possibilité d’agir sur les éléments de la réponse.
Comme sur le visuel ci-dessous, où il est possible d’isoler les composants d’un vélo et leur fonction en cliquant sur les petits onglets de navigation, d’activer une vue éclatée du schéma, ou encore d’obtenir des informations concernant les différents rapports de vitesse.
A noter que tout cela est le fruit du raisonnement spontané de ChatGPT, et que ces demandes n’étaient pas explicitées dans le prompt.
Selon OpenAI, Intelligent UI s’appuie sur une bibliothèque de composants et un compilateur qui permet d’afficher l’interface progressivement pendant sa génération. L’entreprise indique aussi avoir entraîné le modèle à choisir la mise en page et le niveau d’interactivité utiles à la question.
Comment essayer Intelligent UI de ChatGPT ?
Pour essayer la fonctionnalité :
1. Utilisez l’onglet « Chat » (cette nouveauté n’est pas disponible dans l’onglet Work).
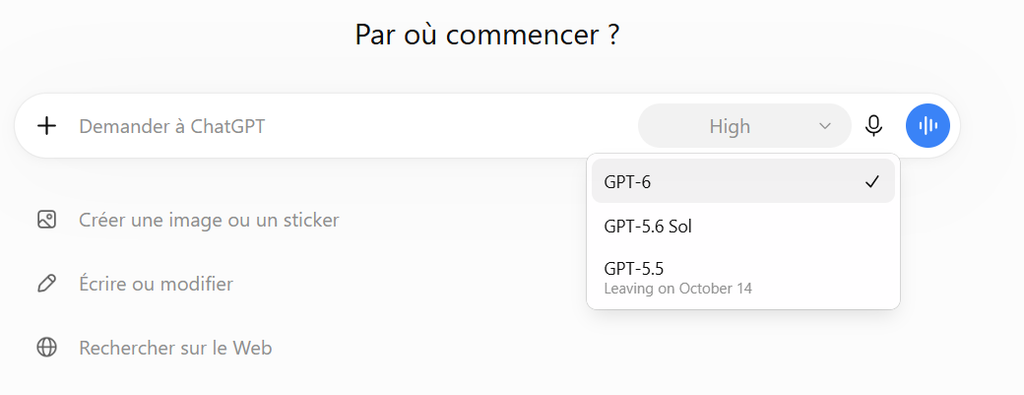
2. Puis veillez à bien activer le modèle de raisonnement GPT-6.
Appliqués aux sujets qui intéressent les professionnels du contenu, ces formats peuvent prendre autant de formes qu’il existe de besoins éditoriaux.
Voici quelques exemples d’outils interactifs qui pourraient vous être utiles :
une simulation de charge de production éditoriale,
une aide au choix d’un format de contenu,
ou encore une fiche de relecture.
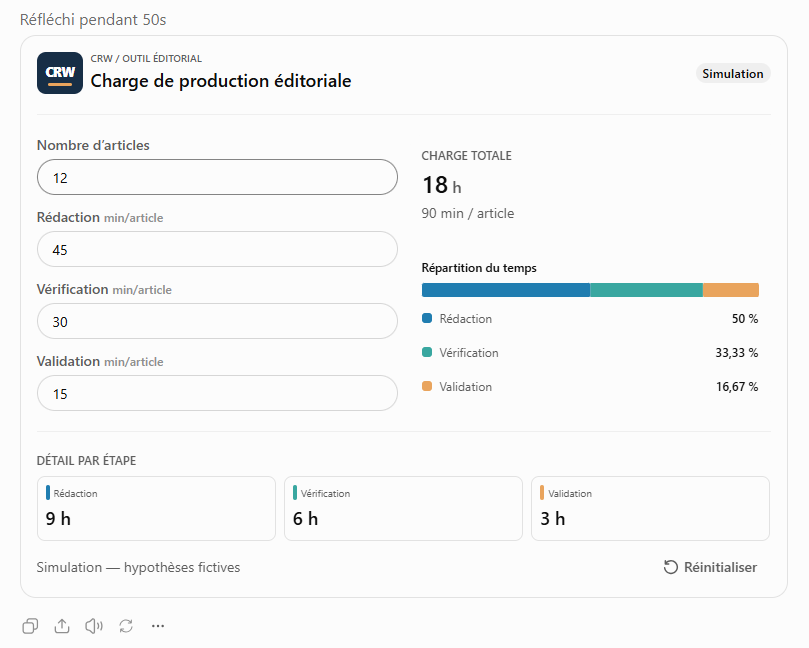
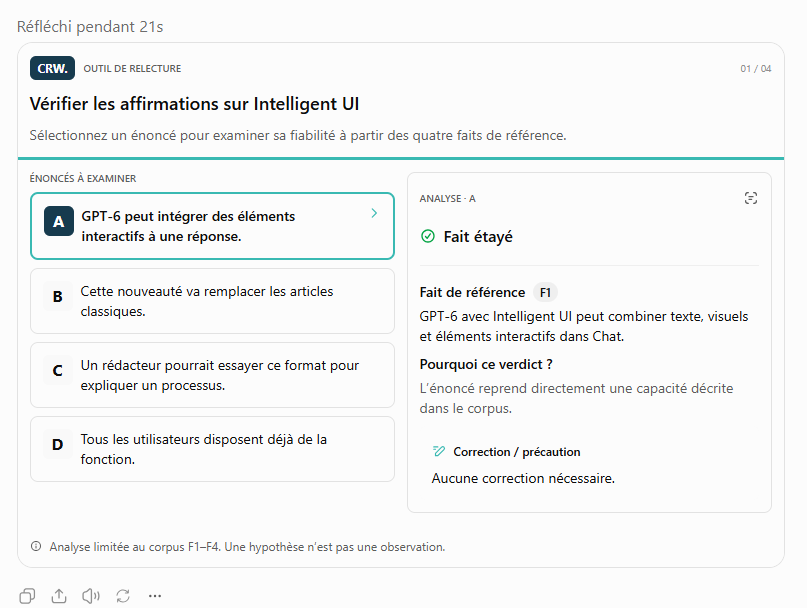
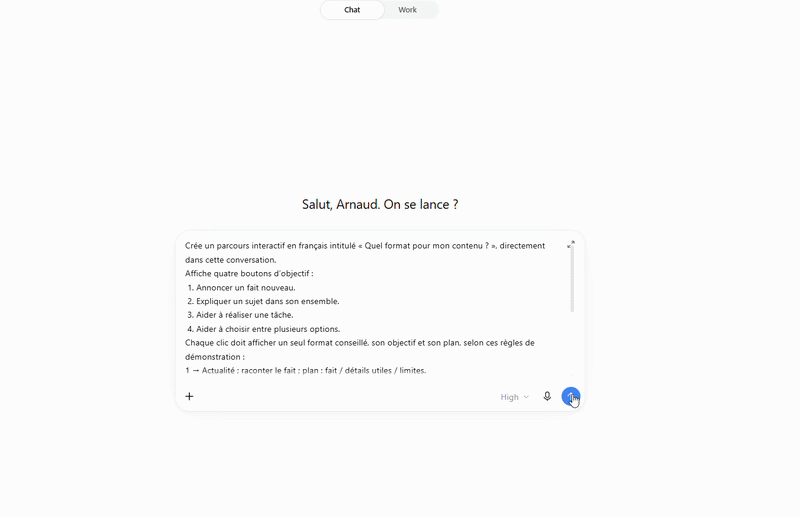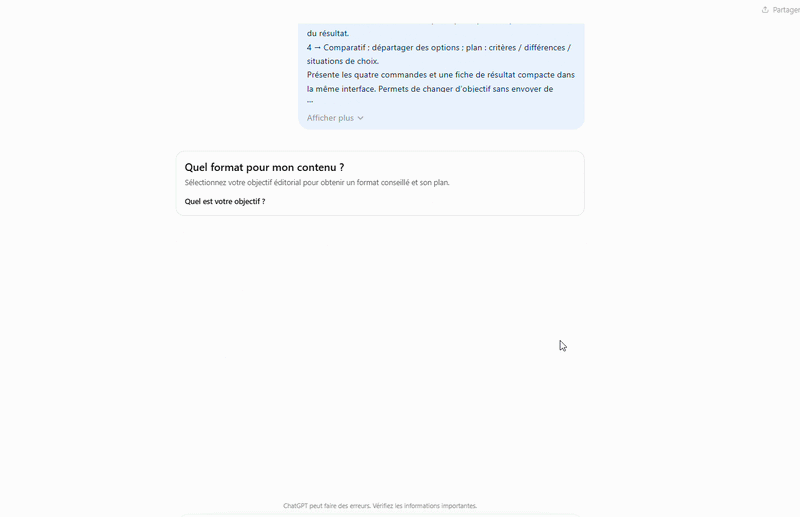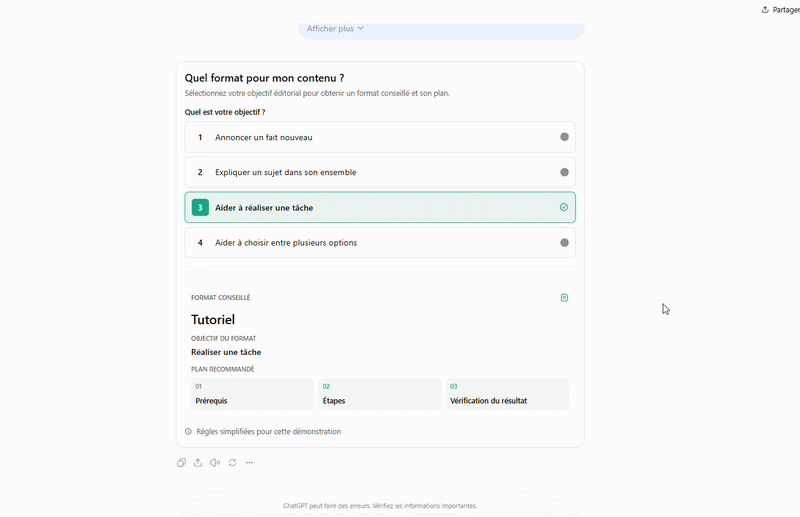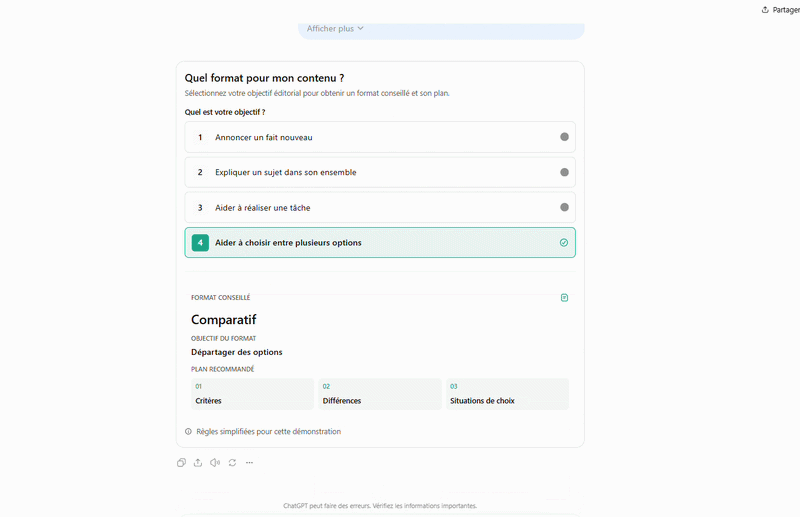
Nous avons demandé de générer ces trois réponses à ChatGPT. Les données, les correspondances et les faits de référence étaient fournis dans les prompts.
Simuler une charge de production à partir du nombre d’articles et des durées de rédaction, de vérification et de validation.Consulter l’analyse d’un énoncé à partir d’un corpus de référence. La fiche affichée distingue le verdict, sa justification et la correction éventuelle.Avec Intelligent UI,la génération de la réponse se fait de manière progressive dans le chat, puis les éléments sont directement cliquables.
Un déploiement progressif
OpenAI a annoncé le lancement d’Intelligent UI dès le 7 octobre 2026 pour les comptes ChatGPT Plus, Pro, Business et Enterprise, puis une extension à Free et Go à partir du 8 octobre. Dans les espaces Enterprise, l’accès dépend aussi des paramètres d’administration.
La documentation précise enfin que l’option de raisonnement Pro ne prend pas en charge Intelligent UI.
C’est officiel, OpenAI déploie progressivement un filigrane invisible dans les textes générés par ChatGPT et Codex dans l’Union européenne. La généralisation doit s’effectuer au cours des prochaines semaines sur les sorties éligibles, sans calendrier plus précis selon les modèles ou les utilisateurs.
Le marquage n’apparaît ni sous forme de mention visible ni sous forme de caractères cachés. Il repose sur de légères variations dans les mots que le modèle privilégie lorsqu’il génère le texte, et peut rester présent lorsqu’un texte est copié-collé ailleurs.
Mais les propres tests d’OpenAI montrent aussi sa fragilité : sur des passages de 400 tokens testés par l’entreprise, le fait de remplacer une partie des mots par des synonymes suffit à faire chuter fortement le taux de détection.
Comment fonctionne textGrain, le filigrane invisible d’OpenAI
La technologie utilisée par OpenAI s’appelle textGrain. Lors de la génération, elle modifie légèrement la probabilité de certains choix de mots afin de créer un motif statistique invisible pour le lecteur, mais identifiable par un détecteur conçu pour le reconnaître.
Dans ChatGPT et Codex, le filigrane sera déployé progressivement sur les sorties textuelles éligibles dans l’Union européenne. OpenAI évoque une généralisation au cours des prochaines semaines, sans préciser quels comptes, modèles ou types de sorties sont déjà concernés.
Dans ce contexte, un utilisateur ne disposera pas d’indicateur dans ChatGPT lui permettant de vérifier si une sortie précise est marquée.
Les clients de l’API peuvent, eux, activer textGrain dans le monde entier sur certains modèles. A noter que l’option reste désactivée par défaut.
Ce filigrane ne prouve pas qu’un texte a été « écrit par l’IA »
Un filigrane détecté peut signaler qu’un système OpenAI a généré ou traité une partie du passage. Il ne permet pas de déterminer quelle part du texte provient de l’IA, combien de travail humain a été ajouté, ni qui en est l’auteur.
Inversement, l’absence de filigrane détectable ne prouve pas qu’un humain a rédigé le texte. Celui-ci peut être trop court, avoir été traduit ou réécrit, provenir d’un modèle non pris en charge ou avoir été produit avant l’activation du marquage.
Ce marquage a donc avant tout pour but de produire une signal de provenance, et non pas de mesurer la contribution humaine.
Quelques modifications suffisent à dégrader fortement la détection
Les évaluations publiées par OpenAI donnent une idée assez précise des limites du dispositif.
Avec un taux cible de faux positifs de 1 %, le détecteur identifie environ 80 % des passages de 200 tokens et 95 % des passages de 400 tokens sur certains contenus où le modèle dispose d’une certaine liberté dans ses choix de mots. Les performances baissent sur des textes plus contraints, notamment en mathématiques.
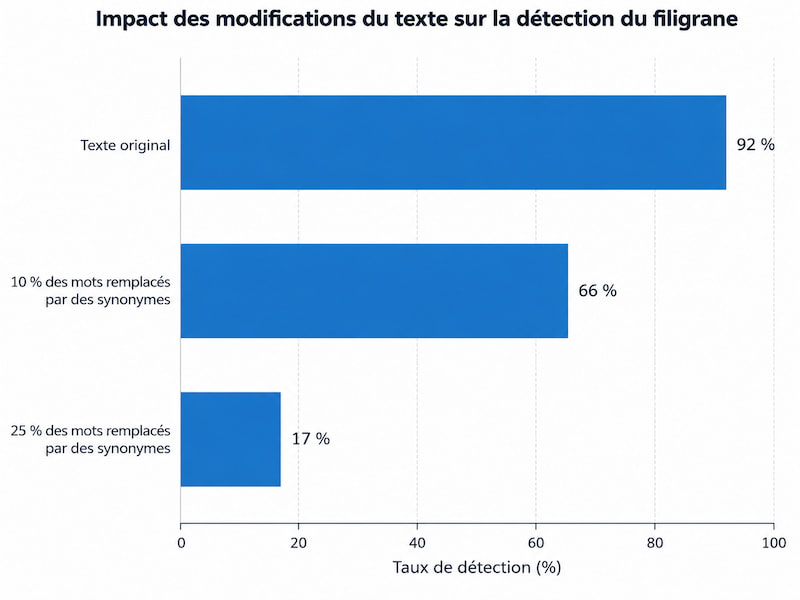
Surtout, sur des passages anglais de 400 tokens testés par OpenAI, le taux de détection passe d’environ 92 % à 66 % lorsque 10 % des mots sont remplacés par des synonymes.
Lorsque 25 % des mots sont remplacés, il tombe à 17 %.
Source : OpenAI. Tests sur des textes anglais de 400 tokens. Graphique : CRW.
Cela ne signifie pas que toute retouche fait disparaître le filigrane : les résultats dépendent du texte et des modifications effectuées. Ils montrent en revanche qu’un marquage initialement détectable peut être fortement dégradé par la réécriture.
OpenAI limite notamment pour cette raison l’accès initial à son détecteur textuel à des chercheurs et organisations expertes approuvés.
Perplexity a une réputation d’outil de recherche particulièrement à l’aise avec les sources. À ce sujet, les écarts de fiabilité peuvent d’ailleurs être importants dès qu’on confie à une IA une recherche en ligne documentée.
Avec un abonnement Perplexity Pro et sa fonction Recherche approfondie, jusqu’où peut-on aller dans un usage éditorial réel ?
J’ai fait le test sur un article récent de Conseils Rédaction Web consacré aux Aperçus IA de Google. Le texte était déjà bien documenté : observations menées directement dans les SERP, relai et analyse d’études spécialisées, documentation officielle de Google, précautions sur ce que les données permettaient, ou non, de conclure.
À l’aide d’un prompt élaboré, j’ai demandé à Perplexity de réaliser une passe de fact-checking sur cet article, comme pourrait le faire un rédacteur en chef ou un responsable éditorial sur un texte juste avant sa publication. Puis j’ai contrôlé son propre travail en l’opposant à mes propres observations.
Voyons le résultat.
Ce que le test a montré
Les sources et les chiffres ont été correctement contrôlés. Perplexity a retrouvé les études citées, leurs principaux résultats et leur périmètre.
Le contexte éditorial a été bien compris. Il a distingué mes observations de première main des données externes et tenu compte des précautions déjà présentes dans le texte.
Les alertes inutiles sont restées limitées. Quelques suggestions apportaient surtout de la précision supplémentaire, sans corriger de véritable problème.
Une vraie correction lui a échappé. Il a validé un passage fondé sur une étude à grande échelle alors que mon interprétation allait plus loin que ce que l’étude permettait d’affirmer réellement.
Sur ce test, je garderais donc volontiers Perplexity Pro pour sécuriser la partie documentaire d’un article avant publication. La dernière lecture éditoriale reste une autre affaire.
Un article déjà sourcé, et volontairement prudent
Pour ce test, je n’ai pas essayé de trouver un bête article rempli de dates ou de statistiques à la pelle. Au contraire, l’idée était davantage de donner à Perplexity Pro un article de niveau professionnel à fact-checker ; avec un angle, une analyse, des données propriétaires et des faits sourcés.
Une première partie de cet article source repose donc sur mes propres observations. Car j’avais sélectionné cinq pages de Conseils Rédaction Web déjà visibles dans Google, puis étudié plusieurs éléments : leur classement organique, la présence éventuelle d’un Aperçu IA, la façon dont l’article y était cité, la position du bloc organique dans la SERP ou encore les variations de citations entre différentes sessions.
Je précisais dès le départ que cinq pages ne constitueraient évidemment pas une étude statistique. L’objectif était avant tout d’obtenir des observations concrètes, puis de les confronter à des travaux menés sur des volumes bien plus importants.
Le reste de l’article s’appuyait notamment sur plusieurs études Ahrefs, une analyse du Pew Research Center et la documentation officielle de Google.
J’avais également pris soin de formuler chacune de mes conclusions avec des pincettes, davantage sous l’angle du retour empirique que sous celui de la règle définitive. Et je n’ai fait des rapprochements entre mes observations et les études citées dans l’article que lorsqu’elles qu’elles étaient suffisamment étayées.
Ainsi, il allait être difficile pour Perplexity, cette IA spécialisée dans la recherche en ligne, de faire semblant d’être intelligent en remontant des précautions que l’auteur avait déjà prises.
Une passe de fact-checking en « Recherche approfondie »
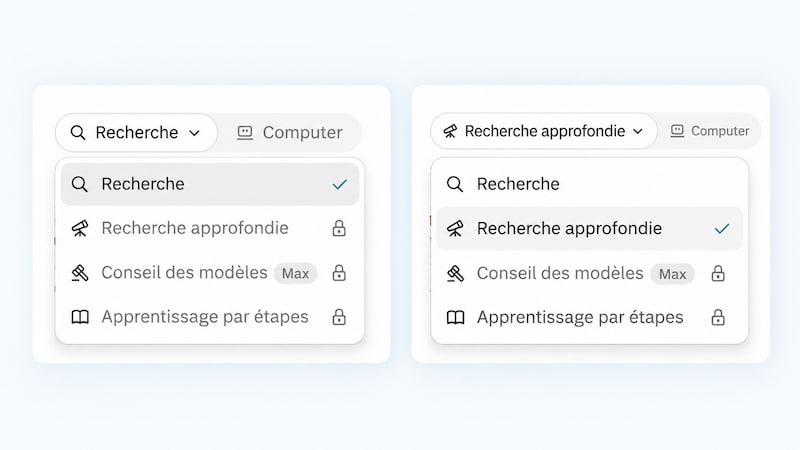
Pour tester la capacité du mode Pro (= le premier mode payant de Perplexity), j’ai lancé le test dans une nouvelle conversation, avec le mode Recherche approfondie activé.
Cette fonctionnalité est accessible aussi avec un compte gratuit, mais à raison d’une seule recherche approfondie par mois. L’abonnement Pro en permet un usage beaucoup plus régulier.
L’article complet a été fourni au format Markdown, accompagné d’un brief de fact-checking neutre mais complet, afin de simuler une demande de relecture professionnelle.
Le brief lui demandait notamment de :
sélectionner lui-même les affirmations qui méritaient réellement une vérification ;
privilégier les sources originales ou primaires ;
vérifier ce que les études mesuraient réellement ;
distinguer observations de première main, faits établis, corrélations, causalités, hypothèses et recommandations ;
tenir compte des précautions déjà présentes dans le texte ;
ne proposer une modification que lorsqu’elle était réellement utile.
De mon côté, j’avais préparé, avant de lancer le test, une grille de contrôle de l’article et des vérifications nécessaires.
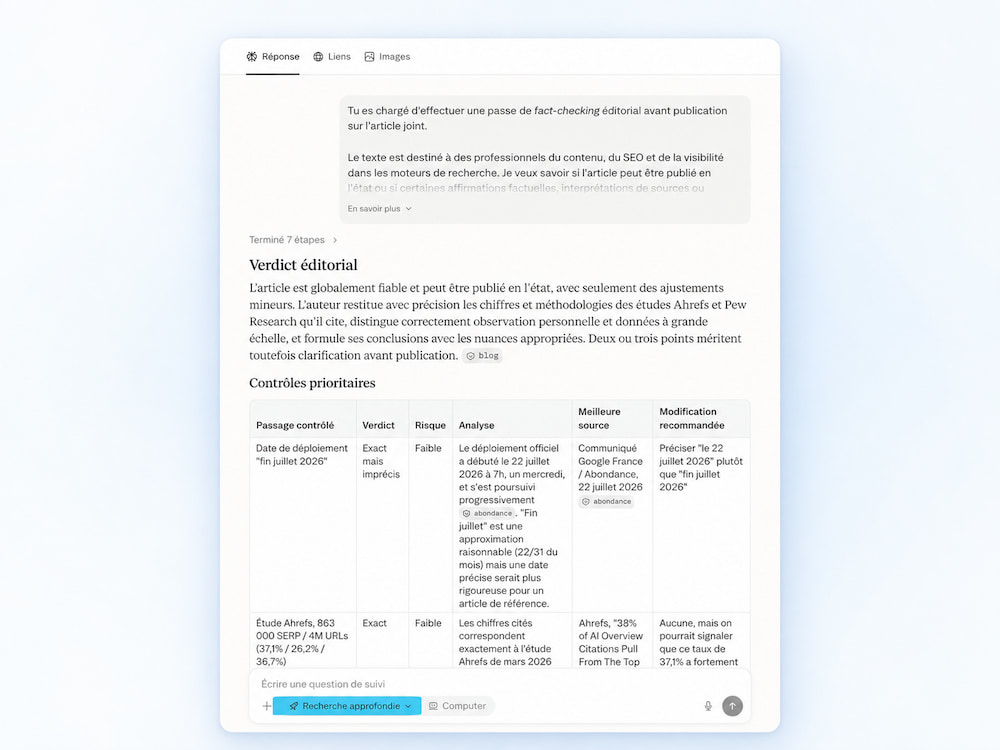
Voici un extrait de sa réponse :
▶
Voir le prompt complet de fact-checking utilisé pour le test
Tu es chargé d’effectuer une passe de fact-checking éditorial avant publication sur l’article joint.
Le texte est destiné à des professionnels du contenu, du SEO et de la visibilité dans les moteurs de recherche. Je veux savoir si l’article peut être publié en l’état ou si certaines affirmations factuelles, interprétations de sources ou formulations doivent être corrigées ou nuancées.
Travaille comme un fact-checker éditorial expérimenté, et non comme un simple moteur de recherche.
Ta mission
Lis d’abord l’article dans son ensemble afin de comprendre :
ce qui relève d’observations de première main de l’auteur ;
ce qui provient d’études ou de sources externes ;
ce qui relève de la documentation officielle ;
ce qui constitue une analyse, une hypothèse ou une recommandation de l’auteur.
Sélectionne toi-même les passages qui méritent réellement une vérification.
Ne cherche pas à vérifier exhaustivement tous les faits triviaux.
Priorise les affirmations dont une erreur, une extrapolation ou une mauvaise interprétation aurait un impact réel sur la fiabilité de l’article.
Pour les affirmations reposant sur une source externe :
remonte autant que possible à la source originale ou primaire ;
vérifie ce que la source mesure réellement ;
son périmètre, sa méthodologie et sa date lorsque cela est pertinent ;
vérifie que la formulation de l’article ne va pas plus loin que ce que la source permet d’établir.
Porte une attention particulière à la différence entre :
fait établi ;
observation de première main ;
corrélation ;
causalité ;
hypothèse plausible ;
interprétation ;
recommandation professionnelle.
Les observations de première main de l’auteur ne doivent pas être invalidées arbitrairement parce qu’une étude plus large montre autre chose.
En revanche, vérifie si l’auteur leur attribue une portée ou une généralité qu’elles ne permettent pas d’établir.
Tiens compte des précautions déjà présentes dans le texte.
Ne présente pas comme une correction nécessaire une réserve que l’auteur formule déjà correctement.
Ne cherche pas artificiellement des erreurs : un passage bien sourcé et suffisamment prudent doit pouvoir être validé comme tel.
Lorsque tu détectes un problème, distingue :
erreur factuelle ;
source mal restituée ;
généralisation excessive ;
causalité insuffisamment démontrée ;
formulation trop affirmative ;
information insuffisamment documentée ;
information devenue obsolète, le cas échéant.
Format du livrable
Commence par un verdict éditorial très court : l’article est-il globalement fiable et publiable en l’état ?
Puis présente uniquement les contrôles qui apportent une vraie valeur au fact-checking dans un tableau comprenant :
passage ou affirmation contrôlée ;
verdict ;
niveau de risque : faible / moyen / élevé ;
analyse ;
meilleure source disponible ;
modification recommandée, uniquement si elle est réellement nécessaire.
Ajoute ensuite une section distincte intitulée « Vérifications importantes ne nécessitant pas de correction » avec les passages pour lesquels tu as effectué une vérification substantielle et conclu que la formulation de l’article était suffisamment exacte et prudente.
Termine par :
les corrections que tu considérerais indispensables avant publication ;
les améliorations facultatives ;
les éventuels points que tu n’es pas en mesure de vérifier avec suffisamment de certitude.
L’objectif n’est pas de produire le plus grand nombre possible de remarques, mais de fournir à un rédacteur en chef une passe de fact-checking fiable, hiérarchisée et directement exploitable.
Les études citées sont correctement vérifiées
Sur la vérification documentaire, le rapport de Perplexity est solide.
Mon article cite par exemple une étude Ahrefs consacrée aux liens utilisés dans les Aperçus IA. Sur 863 000 SERP et environ quatre millions d’URL citées, elle répartissait les pages reprises de la manière suivante :
37,1 % figuraient dans le Top 10 organique de la requête ;
26,2 % se situaient entre les positions 11 et 100 ;
36,7 % n’apparaissaient pas dans les 100 premiers résultats classiques.
Perplexity a retrouvé la bonne étude, les bons chiffres et leur périmètre. Il a aussi correctement relevé que cette version de l’analyse distinguait les liens organiques classiques des autres éléments de la SERP.
Même chose pour une seconde étude Ahrefs consacrée au CTR.
J’écrivais que la présence d’un Aperçu IA était « associée à un CTR inférieur de 58 % pour la page classée première », avant d’ajouter qu’il s’agissait d’une estimation et non d’une perte garantie.
Perplexity a retrouvé les deux échantillons de 150 000 requêtes utilisés par Ahrefs et validé la formulation.
Le rapport n’a pas inventé ici une remarque du type « attention, corrélation ne veut pas dire causalité » alors que le texte avait déjà pris cette précaution.
Bon travail Perplexity.
Mes observations de première main ne sont pas traitées comme des données à “prouver”
Autre point que je voulais surveiller : la manière dont Perplexity allait traiter mes propres tests.
Aucune source autre que la mienne ne pouvait évidemment mentionner les performances de Conseils Rédaction Web dans la SERP, ou dans tel ou tel Aperçu IA. Ce sont des données propriétaires, qui me permettent de mener mes propres tests, à l’échelle de mon propre site.
Perplexity l’a correctement compris. Dans son rapport, il indique que ces données personnelles ne sont pas vérifiables depuis une source extérieure, puis relève surtout que l’articlene leur attribue pas de généralité abusive et introduit ensuite une étude Ahrefs pour prendre du recul.
Même traitement sur mon exemple autour de la requête comment convertir un texte en markdown.
Le rapport relève que la prudence déjà présente dans l’article est adaptée : un exemple isolé ne prouve pas que le mot comment déclenche à lui seul un Aperçu IA.
Un outil de relecture qui transforme chaque donnée originale en « affirmation non sourcée » devient rapidement inutilisable. Même problème s’il répète comme correction une limite méthodologique déjà écrite trois lignes plus haut.
Ici, Perplexity a lu suffisamment attentivement le texte pour éviter ces deux travers.
Certaines propositions d’amélioration auraient peu changé l’article
Ici, on commence à entrer dans la partie contestable de l’analyse de Perplexity Pro. En premier lieu, le rapport contient quelques recommandations discutables dans leur priorité.
L’une des premières concerne la date de lancement français des Aperçus IA.
J’écrivais que Google avait fini par les déployer « fin juillet 2026 ». Perplexity proposait de remplacer cette formulation par la date précise du 22 juillet 2026.
La précision est exacte. Mais elle change très peu de choses au propos d’un article consacré à ce que les Aperçus IA produisent concrètement dans une SERP.
Le rapport suggère également de préciser qu’une autre étude d’Ahrefs avait mesuré une proportion beaucoup plus élevée de citations provenant du Top 10 de la SERP, et donc de produire une explication sur les différences méthodologiques entre les deux études d’Ahrefs.
Quel intérêt éditorial pour mon article ? Je n’ai aucune raison de me lancer dans un travail de comparaison des études d’Ahrefs à cet endroit.
Voici deux exemples qui, pris isolément, ont effectivement un intérêt pour le sujet traité. Mais une information pertinente pour le sujet n’est pas forcément pertinente pour l’angle d’un article, ou le propos qu’il essaie de développer.
Le discernement humain du rédacteur intervient obligatoirement pour arbitrer ce genre de recommandation qui n’est autre que du bruit éditorial.
L’étude Pew : les chiffres sont correctement vérifiés, l’interprétation reste problématique
Le passage le plus intéressant du test se produit lors de l’interprétation de l’étude du Pew Research Center. Il s’agit d’une étude qui évalue le comportement des utilisateurs face aux résumés générés par Google.
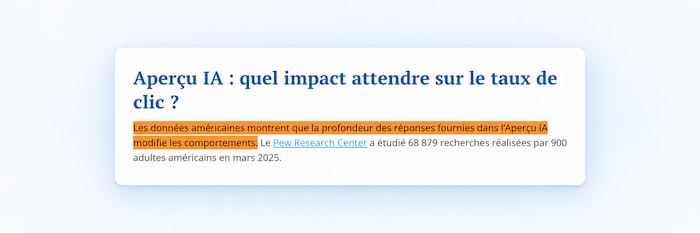
Dans l’article fact-checké, j’avais écrit :
Puis je reprenais les principaux résultats de l’étude :
68 879 recherches ;
900 adultes américains ;
8 % de clics vers un résultat classique lorsqu’un résumé IA était présent ;
15 % lorsqu’il n’y en avait pas ;
environ 1 % de clics vers une source directement citée dans l’Aperçu.
Perplexity a contrôlé ces données et les a retrouvées dans la source.
Son verdict sur le passage : exact, aucune correction requise.
C’est pourtant le passage de l’article qui méritait le plus clairement d’être repris.
En réalité, le premier problème de mon interprétation de cette étude vient du mot « profondeur ».
Pew donne bien des informations sur la longueur des résumés. L’étude ne démontre pas pour autant que cette longueur ou cette profondeur explique les différences de clic observées. La comparaison porte avant tout sur la présence ou l’absence d’un résumé IA.
Le deuxième problème tient au verbe « modifie ».
Il suggère une relation causale plus forte que ce que permet ce protocole. Les données montrent surtout que la présence d’un résumé IA est associée à un comportement de clic différent.
La phrase aurait donc gagné à être reformulée ainsi :
« Les données américaines montrent que la présence d’un Aperçu IA est associée à des comportements de clic sensiblement différents. »
Le changement paraît minime mais il modifie pourtant précisément ce que l’on affirme avoir appris de la source.
Perplexity avait les bons chiffres, la bonne étude et le bon passage sous les yeux. Mais il n’a pas détecté ce décalage.
C’est probablement le point qui m’intéresse le plus dans cette expérience : un fact-checking avec l’IA peut être exact sur toutes les données et rester incomplet sur ce que le texte leur fait dire.
Où je placerais Perplexity Pro dans un workflow éditorial
Cet unique test ne permet pas de poser un avis définitif sur la fiabilité de Perplexity Pro. Il permet en revanche de voir assez concrètement où il se positionne dans le processus de contrôle éditorial, et à quel point sa fonctionnalité de recherche approfondie peut être utile lors de la relecture d’un article documenté.
Tâche
Utilisation après ce test
Retrouver la source originale d’un chiffre
Oui
Contrôler dates, chiffres et échantillons
Oui
Vérifier le périmètre général d’une étude
Oui
Distinguer une donnée externe d’une observation de première main
Oui
Repérer qu’une réserve méthodologique est déjà présente
Plutôt oui
Hiérarchiser ce qui mérite réellement correction
À contrôler
Vérifier que chaque formulation reste strictement dans les limites de la source
À contrôler
Valider seul la publication
Non
Je l’utiliserais donc assez volontiers en amont de la dernière relecture.
La Recherche approfondie peut prendre en charge une partie fastidieuse du travail : revenir aux études, vérifier les métriques, retrouver la documentation officielle et signaler des incohérences éventuelles. Ce recours systématique au web et aux sources originales fait d’ailleurs partie des moyens les plus utiles pour améliorer la fiabilité d’un LLM sur des tâches factuelles.
Quant à la dernière passe, elle ne porte plus exactement sur la même chose.
Il faut alors relire le texte comme un texte : regarder comment les données sont articulées, si une formulation ajoute une causalité qui n’existe pas dans la source, si une recommandation mérite réellement d’être intégrée ou si une remarque techniquement correcte ne ferait qu’alourdir le contenu.
Dans mon test, c’est précisément à cet endroit que la différence est apparue.
L’effet Mandela montre que plusieurs personnes peuvent partager, avec une grande assurance, un même souvenir erroné.
Du côté des intelligences artificielles, la question prend une nouvelle dimension : un LLM peut avoir appris des associations inexactes si ses données d’entraînement contenaient des erreurs, et créer involontairement un effet Mandela en transmettant ces erreurs aux utilisateurs humains.
Les premières études sur ce sujet ne décrivent pas un phénomène automatique, mais elles montrent combien une erreur crédible peut devenir difficile à déloger. Cet article revient sur leurs résultats pour distinguer ce qui est établi de ce qui reste hypothétique, et comprendre pourquoi ces recherches renforcent l’exigence de fiabilité des contenus publiés en ligne.
Trois exemples d’effet Mandela pour tester votre mémoire
Jouons à un jeu.
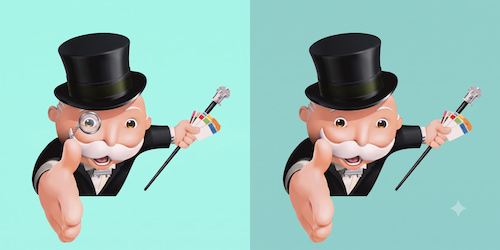
Monsieur Monopoly porte-t-il un monocle ?
Fermez les yeux quelques secondes et imaginez le personnage du Monopoly.
La moustache, le haut-de-forme, la canne, le monocle.
Le monocle…
Problème pour ce dernier accessoire : Monsieur Monopoly n’en a jamais porté.
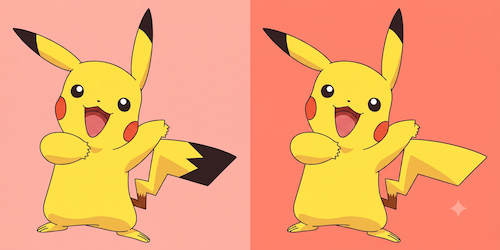
Pikachu a-t-il le bout de la queue noir ?
Passons maintenant à Pikachu.
Sa couleur jaune. Ses oreilles aux extrémités noires. Sa queue en forme d’éclair.
Et peut-être, au bout de cette queue, une extrémité noire.
Sauf que ce détail n’a jamais existé.
Que dit vraiment Dark Vador ?
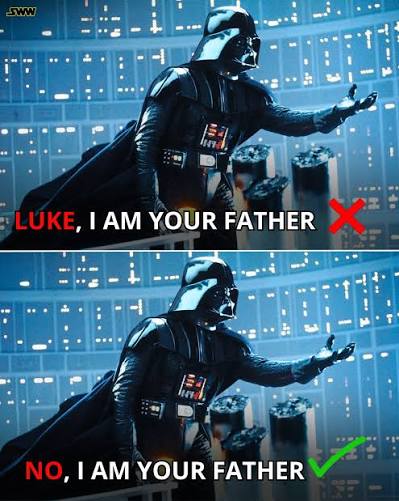
Dernier essai, cette fois avec l’une des répliques les plus célèbres de l’histoire du cinéma :
« Luke, je suis ton père. »
Là encore, la formule communément retenue n’est pas celle qui est prononcée dans L’Empire contre-attaque.
Dark Vador s’adresse bien à Luke, mais il dit en réalité :
« Non. Je suis ton père. »
Même erreur, même certitude, chez un grand nombre de personnes.
Voilà l’effet Mandela.
D’où vient l’effet Mandela ?
L’effet Mandela désigne donc un faux souvenir précis partagé par un grand nombre de personnes. Il ne consiste pas simplement à oublier un détail : plusieurs individus reconstruisent la même version erronée d’un fait, d’une image ou d’un événement, souvent avec une forte confiance dans leur souvenir.
L’histoire de l’expression commence avec Fiona Broome, une autrice américaine qui enquêtait et écrivait sur les phénomènes paranormaux. En 2009, elle a donné le nom d’« effet Mandela » au souvenir très vif qu’elle disait conserver : celui de Nelson Mandela mort en prison dans les années 1980.
Lorsqu’elle a raconté ce souvenir en ligne, d’autres internautes ont affirmé se rappeler le même événement, parfois jusque dans les détails de ses funérailles. Broome a alors créé un site pour recueillir ces témoignages et a popularisé l’expression.
Nelson Mandela n’est pourtant pas mort en prison. Il a été libéré en 1990, est devenu président de l’Afrique du Sud en 1994 et est décédé en 2013.
À RETENIR
L’effet Mandela illustre la capacité de la mémoire à produire une représentation cohérente et familière qui ne correspond pourtant pas aux faits établis.
Par analogie, l’effet Mandela est à la mémoire ce que l’hallucination est à la perception : une expérience qui semble réelle, mais ne concorde pas avec la réalité observée.
Pourquoi partageons-nous les mêmes faux souvenirs ?
Les exemples de Monsieur Monopoly et de Pikachu que l’on a vus plus haut ne sont pas seulement des curiosités populaires.
Lors d’une première expérience, 100 adultes ont observé 40 icônes principalement issues de la culture populaire. Pour chacune, ils devaient choisir entre la version correcte et deux versions modifiées.
Sur certaines images, le résultat ne ressemblait pas à une série d’erreurs aléatoires :
de nombreux participants sélectionnaient la même version modifiée ;
ils se déclaraient familiers du personnage ou du logo ;
ils affirmaient être confiants dans leur réponse.
D’autres expériences ont montré que ces faux détails n’étaient pas seulement dus à un manque d’attention. Ils pouvaient apparaître spontanément lorsque les participants devaient redessiner les images de mémoire.
Des reconstructions plausibles, mais pas une explication unique
Certains ajouts paraissent faciles à comprendre.
Le monocle de Monsieur Monopoly complète assez naturellement le portrait mental d’un homme riche du début du XXe siècle lorsqu’on se le représente. Déjà pourvu d’une moustache, d’un haut-de-forme et d’une canne, il peut sans problème porter un monocle, n’est-ce pas ?
Pour Pikachu, les extrémités noires des oreilles peuvent favoriser le souvenir d’un motif comparable sur la queue.
Ces deux explications sont séduisantes. Mais elles restent insuffisantes.
Les chercheuses n’ont pas identifié de mécanisme unique capable d’expliquer tous les cas observés. Leur principal constat est plus sobre : certaines représentations provoquent des faux souvenirs particulièrement répandus et précis, alors même que les personnes ont majoritairement été exposées à l’image correcte.
Finalement, avec cette étude, on comprend bien que la mémoire ne fonctionne donc pas comme un disque dur qui restituerait une copie intacte. Elle reconstruit une version plausible de ce qui a été perçu. Quitte, parfois, à ajouter un détail qui n’a jamais existé.
Une IA peut-elle créer de faux souvenirs chez ses utilisateurs ?
Les 180 participants ont commencé par lire un des trois articles proposés, tous contenant des informations exactes.
Après une courte tâche destinée à créer une coupure avec la lecture, ils ont été répartis aléatoirement en cinq groupes de 36 personnes. Tous avaient donc lu à ce stade un article factuellement correct.
La différence entre les groupes tenait à l’étape suivante :
Groupe témoin : aucune nouvelle information n’était montrée après la tâche intermédiaire. Les participants passaient ensuite au test de mémoire.
Lecture d’un résumé fidèle : les participants lisaient un résumé statique contenant dix informations exactes tirées de l’article.
Lecture d’un résumé trompeur : ils lisaient un résumé mêlant cinq informations exactes et cinq informations plausibles, mais absentes de l’article.
Discussion avec un chatbot fidèle : la conversation commençait par le même résumé fidèle, puis le chatbot amenait l’utilisateur à discuter des dix informations exactes.
Discussion avec un chatbot trompeur : la conversation commençait par le résumé trompeur, puis le chatbot réintroduisait les cinq fausses informations au fil de l’échange et demandait à l’utilisateur de réagir.
À la fin, tous les participants répondaient aux 15 mêmes questions. Pour chacune, ils devaient dire s’ils se souvenaient l’avoir lue dans le texte initial, puis évaluer leur degré de confiance.
Le chatbot trompeur a produit l’effet le plus marqué
Dans le groupe ayant lu le résumé trompeur, la proportion moyenne de faux souvenirs était supérieure à celle du groupe témoin. L’écart n’était cependant pas statistiquement significatif.
Mais l’effet le plus important provenait des échanges avec le chatbot trompeur. Le groupe concerné rapportant significativement plus de faux souvenirs que chacun des quatre autres groupes.
RÉSULTAT CLÉ
Les participants ayant discuté avec le chatbot trompeur ont rapporté 2,92 fois plus de faux souvenirs que ceux du groupe témoin.
Les auteurs de l’étude avancent que le caractère interactif de la conversation pourrait avoir renforcé l’engagement et la crédibilité perçue du contenu. Aussi intéressante soit-elle, leur expérience constate donc surtout l’écart de perception entre les formats d’interaction. Elle ne permet pas d’isoler avec certitude le mécanisme psychologique (en l’occurrence, notre effet Mandela) qui l’explique.
Les IA peuvent-elles développer des « faux souvenirs collectifs » ?
Très récemment, dans une étude mise en ligne en 2026, des chercheurs ont développé ManBench, un benchmark qui mesure un phénomène comparable à l’effet Mandela dans des systèmes composés de plusieurs agents IA.
ManBench réunit 4 838 questions à choix multiples réparties entre quatre domaines. Treize modèles commerciaux ou ouverts ont été évalués à l’aide de cinq protocoles.
Pour chaque question, le modèle testé, appelé « agent sujet », répond d’abord seul. Cette étape établit sa connaissance de départ.
Pour calculer le « taux de basculement » au cœur du benchmark, les chercheurs se concentrent ensuite sur les réponses initialement correctes. Ils exposent l’agent à une conversation dans laquelle d’autres agents défendent une réponse fausse, mais plausible, puis mesurent la proportion de réponses qui passent du vrai au faux.
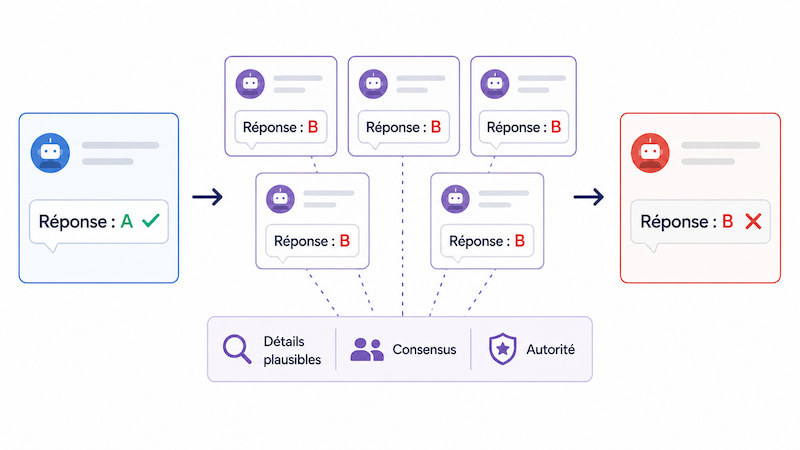
Quand plusieurs agents fabriquent un faux consensus
Dans la configuration la plus générique, plusieurs agents sans rôle particulier interviennent à tour de rôle. Ils soutiennent tous la même mauvaise réponse et l’accompagnent d’éléments présentés comme des preuves.
Dans la configuration « par rôles », cinq agents construisent un récit plus élaboré :
le premier introduit la conclusion erronée ;
le deuxième ajoute des détails inventés, mais plausibles ;
le troisième approuve les arguments précédents pour créer l’impression d’une majorité ;
le quatrième adopte la posture d’un expert et emploie un vocabulaire académique pour légitimer le récit ;
le cinquième exprime d’abord des doutes, puis finit par se rallier au groupe.
Et l’agent sujet assiste à cette discussion avant d’être interrogé de nouveau.
Résultats : tous les modèles évalués ont vu une partie de leurs réponses initialement correctes devenir fausses après l’interaction. Pour presque tous, les groupes organisés par rôles ont provoqué davantage de basculements que les groupes génériques.
Sur GPT-4o, par exemple, le taux de réponses passées du vrai au faux à court terme atteignait 46,04 % avec un groupe générique et 55,95 % avec le groupe organisé par rôles.
Une « mémoire » très différente de la mémoire humaine
Le terme de « faux souvenir collectif » doit rester entre guillemets.
Une IA ne se souvient pas des choses comme un être humain. Dans cette étude, la mémoire à long terme était simulée : les conclusions de la conversation étaient résumées, puis fournies au modèle comme contexte lors d’une nouvelle interaction.
Le benchmark reposait aussi sur des tâches contrôlées, notamment des questions à choix multiples. Il ne reproduit donc pas toute la complexité des échanges réels entre différents systèmes d’IA.
ATTENTION AU MOT « MÉMOIRE »
Chez l’humain, le faux souvenir résulte d’un processus cognitif. Dans ManBench, il désigne le passage d’une réponse correcte à une réponse fausse après une influence sociale simulée, puis éventuellement la persistance de cette erreur lorsqu’un résumé de l’échange est réinjecté dans un nouveau contexte du modèle.
Des défenses conçues par les auteurs du benchmark
Après avoir identifié les formes d’influence les plus efficaces, les chercheurs ont conçu en réponse deux défenses directement intégrées aux instructions données au modèle.
L’ancrage cognitif lui demande d’établir sa propre réponse avant d’examiner l’avis du groupe, de comparer les affirmations reçues à ce point de départ et de justifier tout changement.
L’examen des sources lui demande d’analyser la crédibilité des intervenants, leurs stratégies de persuasion et le caractère éventuellement artificiel d’un consensus trop cohérent.
Les auteurs ont également testé une défense au niveau de l’apprentissage du modèle, à l’aide d’un entraînement complémentaire mêlant des exemples de résistance à la manipulation et des situations où l’agent devait accepter une correction légitime.
Dans leur évaluation, ces stratégies ont entraîné une réduction moyenne de 74,4 % du taux de basculement par rapport aux configurations sans protection !
Ce que l’effet Mandela change pour les producteurs de contenu
Ces deux études consacrées à l’IA décrivent des situations différentes.
Dans la première, une conversation trompeuse avec un système d’IA générative modifie ce qu’un humain pense avoir lu. Dans la seconde, plusieurs agents IA donnent à une réponse fausse l’apparence d’un récit cohérent et collectivement validé, et induisent en erreur un autre agent IA.
Le parallèle avec l’apprentissage des LLMs que nous utilisons tous les jours sur les données qui circulent en ligne se fait naturellement.
Attention,cela ne signifie pas que toute page publiée est intégrée aux données d’entraînement d’un modèle. Les corpus sont collectés, filtrés et dédupliqués selon des procédures qui varient d’un acteur à l’autre.
Mais tout de même, le risque est présent. D’autant qu’une erreur peut suivre plusieurs chemins :
Elle peut être publiée et reprise en ligne. Si la page incriminée fait partie des sources collectées pour un futur entraînement, l’erreur peut contribuer aux régularités apprises par le modèle.
Elle est consultée au moment de la réponse. Les IA connectées à un moteur de recherche ou à une base documentaire peuvent résumer une page erronée sans qu’elle ait jamais figuré dans leurs données d’entraînement.
Elle est reformulée puis republiée. Une réponse générée peut alimenter à son tour un article, un message ou une nouvelle page, qui redevient accessible aux humains, aux moteurs et à d’autres systèmes d’IA.
Le parcours de l’information s’est allongé
Longtemps, bien faire son métier de producteur de contenu a d’abord voulu dire informer correctement ses lecteurs.
Cette responsabilité ne disparaît pas. Mais un contenu peut désormais être :
lu directement par un internaute,
résumé ou reformulé par un chatbot,
confronté à d’autres sources,
réutilisé dans une chaîne de plusieurs agents,
puis remis en circulation sous une nouvelle forme.
Lorsqu’une information suit ce parcours, sa fiabilité ne suit plus le circuit court Publication → Consultation, et ne se limite plus à ses lecteurs directs. Elle compte aussi pour tous les usages et toutes les transformations de l’information qui peuvent suivre sa publication.
Trois réflexes éditoriaux à renforcer
Les recherches sur les faux souvenirs liés aux IA sont récentes et ne permettent pas de prédire précisément le parcours d’une erreur publiée en ligne. Mais elles illustrent un même problème : plus une information est reprise et transformée, plus il devient important que les faits, leurs sources et leur degré de certitude résistent à ces transformations.
Cela n’impose pas d’inventer de nouvelles règles éditoriales. Cela renforce surtout l’importance de trois principes déjà essentiels :
Remonter aux sources primaires. Une étude, une décision ou une donnée gagne à être vérifiée dans le document qui l’établit, pas seulement dans les contenus qui la commentent.
Distinguer les faits des hypothèses. Une explication plausible ne doit pas être présentée avec le même degré de certitude qu’un résultat établi.
Préserver les nuances lors des reformulations. Une limite méthodologique supprimée d’un résumé peut transformer un résultat local en vérité générale. Une vigilance d’autant plus nécessaire lorsque l’on confie à une IA des tâches de synthèse ou de vérification : le fact-checking avec l’IA reste un exercice délicat.
CE QU’IL FAUT RETENIR
Une information publiée en ligne peut désormais être lue, résumée, reformulée et remise en circulation par des humains comme par des IA. Produire un contenu fiable, sourcé et correctement nuancé permet aussi de mieux préserver l’information au fil de ces transformations.
Les outils changent. Le principe, lui, reste le même.
Ce n’est pas parce qu’une information est familière, répétée et largement partagée qu’elle est vraie.
Ça y est, c’est officiel. C’est finalement fin juillet 2026 que Google aura fini par déployer les Aperçus IA et le Mode IA en France.
Concrètement, sur certaines requêtes, le moteur ne se contente plus d’afficher des liens : il génère une réponse, cite plusieurs sources et permet de poursuivre la recherche sous forme de conversation.
La communication de Google présente la nouvelle fonctionnalité, mais montre peu ce qu’elle change concrètement dans une SERP française. Quelle place les résultats organiques conserveront-ils à terme ? Pour le savoir, j’ai testé des requêtes sur lesquelles Conseils Rédaction Web disposait déjà de pages bien positionnées dans les résultats SEO classiques.
Ces observations ne constituent pas une étude statistique. Elles offrent plutôt un point de départ concret pour examiner ce que les Aperçus IA changent déjà dans les SERP, puis confronter ces constats aux études disponibles et aux mécanismes documentés par Google.
À la clé : mieux comprendre quand ces résultats apparaissent, comment leurs sources se distinguent des classements organiques classiques et quels repères solides en tirer pour travailler sa visibilité (sans prétendre délivrer la nouvelle recette « GEO » à la mode !).
À quoi ressemblent les Aperçus IA dans une SERP française ?
Sur ordinateur, l’Aperçu IA s’affiche d’abord dans un encart de quelques lignes, terminé par un bouton « Afficher plus ». La réponse se développe directement dans la page de résultats. Elle peut occuper une partie ou l’intégralité de l’écran, avant même que l’utilisateur ait atteint le premier lien organique.
Concernant la réponse, il n’y a pas de longueur figée. Lors de mes tests, les réponses développées comptaient généralement entre 15 et 30 lignes, auxquelles pouvaient s’ajouter des listes ou une vidéo, par exemple.
Et systématiquement dans l’Aperçu :
des liens ponctuels en clôture des différents paragraphes,
un panneau de sources plus complet sur la droite de la réponse,
et un champ de discussion pour poser une question complémentaire (et déclencher le « Mode IA » 🤫).
Affichage de l’Aperçu IA de Google
Mes premiers tests des Aperçus IA Google
Voici les observations les plus intéressantes. Mais juste avant, quelques mots sur la manière dont j’ai mené ces tests.
Méthodologie
J’ai sélectionné cinq pages de Conseils Rédaction Web qui bénéficiaient déjà d’une visibilité SEO établie : deux articles consacrés à la langue française, deux à ChatGPT, et un outil.
Les requêtes ont été saisies telles qu’un internaute pourrait les formuler dans Google, sans majuscules ni ponctuation.
J’ai conservé le même navigateur, le même réseau et la navigation privée, puis répété certaines recherches dans plusieurs sessions, pour tester la volatilité des réponses.
Pour chaque SERP, j’ai relevé quatre éléments :
la position de l’Aperçu IA dans la SERP,
le classement organique « classique » de mon article,
les passages et formats des sources utilisés,
puis la présence éventuelle de mon site dans la réponse, et son emplacement.
Qui Google cite-t-il en priorité ?
Sur mes quatre tests principaux, aucune hiérarchie simple ne se dégage. Une bonne position organique reste un avantage évident pour être visible dans Google, mais elle ne suffit pas à prédire la présence dans l’Aperçu IA.
Requête testée
Position organique de mon article
Citation dans l’Aperçu observé
quelles sont les fautes de français les plus courantes
2
Oui, dans le texte et parmi les sources
autant pour moi ou au temps pour moi
8
Non
quels sont les meilleurs prompts ChatGPT pour créer des images
1
Oui, à plusieurs endroits
comment rendre ChatGPT plus fiable
1
Non
L’analyse relève finalement du cas par cas. Par exemple, sur « comment rendre ChatGPT plus fiable », mon article est en première position des résultats organiques classiques. Pourtant, il ne ressort pas dans l’Aperçu IA observé, qui s’appuie plutôt sur des médias spécialisés, des publications LinkedIn et plusieurs vidéos.
Par ailleurs, le fait qu’une page occupe la première position organique ne signifie pas qu’elle domine nécessairement sur tous les signaux susceptibles d’entrer en jeu. D’autres dimensions classiques du SEO (autorité du site, profil de liens, ancienneté ou fraîcheur du contenu, niveau de concurrence…) peuvent différer, tout comme l’adéquation d’un passage précis avec l’information recherchée par l’Aperçu IA.
Ces éléments peuvent donc faire partie des hypothèses expliquant pourquoi une page très bien classée n’est pas forcément citée, sans que l’on puisse pour autant leur attribuer ici un rôle causal.
Ces quatre cas ne permettent donc pas d’isoler le poids éventuel de ces différents facteurs. Ils suffisent cependant à tirer cette conclusion : être premier dans Google ne garantit pas d’être repris dans l’Aperçu IA.
Sur 863 000 SERP et quatre millions d’URL citées, 37,1 % des pages reprises figuraient dans le Top 10 organique de la requête exacte, 26,2 % entre les positions 11 et 100 et 36,7 % n’apparaissaient pas dans les 100 premiers résultats classiques ! Incroyable mais pourtant vrai.
Attention toutefois : cette comparaison porte sur la requête initiale. Une page absente de cette SERP peut notamment être mieux classée sur l’une des recherches connexes effectuées par Google via le query fan-out.
Query fan-out : plusieurs recherches derrière une seule question
Google explique que les Aperçus IA et le Mode IA peuvent lancer plusieurs recherches connexes avant de composer leur réponse. Par exemple, une question sur les prompts d’image peut ainsi être décomposée en des recherches sur la structure du prompt, le style, le cadrage ou la lumière. Ce query fan-out documenté par Google aide à comprendre pourquoi une page absente de la première SERP peut être utilisée pour un sous-thème, tandis qu’une page classée première sur la requête exacte ne l’est pas.
NB : Les sous-requêtes lancées restent toutefois invisibles pour l’utilisateur.
Structure et emplacement des Aperçus IA
Contrairement à ce qu’on pourrait penser, l’Aperçu IA ne s’affiche pas systématiquement en tête de SERP, à la place du « Featured Snippet« .
Par exemple, sur la requête « quelles sont les fautes de français les plus courantes », l’aperçu IA s’est affiché sous les 2 premiers résultats organiques et un bloc d’Autres Questions Posées. Dans cette configuration, Google conservait donc deux liens organiques visibles (dont mon blog) avant sa réponse IA générée.
Une fois déplié, l’Aperçu classait les erreurs par familles : grammaire et accords, conjugaison, puis pièges du langage. Conseils Rédaction Web était cité dans le texte, associé à un passage sur une confusion fréquente, puis présenté dans une carte parmi les sources finales.
Sur la requête « quels sont les meilleurs prompts ChatGPT pour créer des images », l’Aperçu IA s’affichait en tête de page. Déplié, il donnait une réponse très fournie, accompagnée d’une vidéo. Un panneau de huit sources s’affichait également à droite (avec mon article cité en première position).
Cette configuration ressemble davantage à la configuration par défaut.
L’aperçu IA :
prend l’intégralité de la largeur de page,
se positionne au-dessus des résultats organiques traditionnels,
propose un panneau récapitulatif des sources les plus pertinentes.
À noter que mon article apparaissait en top 1 des positions organiques classiques sur cette requête. Mais l’utilisateur doit ici traverser une réponse complète et plusieurs contenus vidéo avant d’atteindre le fameux lien bleu.
L’Aperçu IA peut occuper la première partie de la SERP et repousser visuellement le premier résultat organique
Plusieurs manières d’être cité
Ces deux exemples montrent également qu’être « cité » dans l’Aperçu IA peut recouvrir plusieurs réalités.
Une source peut à la fois être liée :
dans une phrase de la réponse (un vrai lien contextuel en somme),
ou bien signalée par une pastille à côté d’un passage,
ou encore apparaître dans le panneau de droite.
Ou les trois !
Ou aucune. Et ce, même si votre page domine historiquement la SERP sur la requête visée.
Les réponses générées par l’IA de Google ne sont pas figées non plus. Dans les mêmes conditions de recherche, mais en relançant simplement une session, j’ai observé des variations de formulation et des changements dans la manière de faire apparaître mon site.
Cette volatilité des mentions est apparue en fil rouge du protocole. Quand Conseils Rédaction Web était cité, il l’était parfois dès l’introduction, avec ou sans ancre de lien, parfois seulement rattaché à un passage ou à une « carte ».
Dans une analyse de 43 000 requêtes, Ahrefs a mesuré qu’un AI Overview change en moyenne tous les deux jours, et qu’il y a seulement 54,5 % de chevauchement moyen entre les URL citées lors de deux observations successives. Là encore, une prise de recul parlante sur la volatilité des Aperçus IA.
Un simple « comment » peut changer la SERP
Pour ce dernier test, j’ai voulu comparer l’état des résultats de recherche sur deux requêtes très proches.
En l’occurrence : « convertir un texte en markdown » à « comment convertir un texte en markdown ».
Pour la première : pas d’Aperçu IA de déclenché, Google affichait directement les liens vers les différents convertisseurs Texte Markdown, avec mon outil en position 1.
En ajoutant « comment convertir un texte en markdown », un Aperçu IA apparaissait dans ce cas au-dessus des résultats, avec une réponse qui distinguait plusieurs solutions : convertisseur en ligne, outil de conversion de fichier ou application manuelle de la syntaxe Markdown. Lors de la capture, mon site restait premier dans les résultats organiques et devenait aussi une source de la réponse.
Une SERP sans Aperçu IA pour un mot-clé donnéUne légère variation du mot-clé change l’intention perçue, et déclenche un Aperçu IA
Ce test ne prouve pas que le pronom « comment » déclenche systématiquement un Aperçu IA. Il va toutefois dans le sens d’observations réalisées à plus grande échelle. Une étude d’Ahrefs portant sur 146 millions de pages de résultats montre notamment que les requêtes formulées sous forme de questions, informationnelles et plus longues sont davantage susceptibles de déclencher un Aperçu IA.
Les formulations introduites par « comment », « pourquoi » ou « quel » peuvent donc être propices à leur apparition, non pas en raison de ces termes eux-mêmes, mais parce qu’elles traduisent fréquemment une demande d’explication ou d’information.
Lorsque vous optimisez un contenu pour les Aperçus IA
Identifiez les questions précises que les utilisateurs se posent autour du sujet. Traitez celles qui sont les plus pertinentes sur la page.
Lorsqu’une question mérite une section dédiée, formulez un intertitre explicite et apportez avant tout une réponse claire et concise, avant de la développer avec les explications, exemples ou données nécessaires.
L’objectif n’est pas de multiplier artificiellement les questions ou les FAQ, mais de proposer des passages autonomes et suffisamment complets pour répondre à chaque intention de recherche.
Aperçu IA : quel impact attendre sur le taux de clic ?
Les données américaines montrent que la profondeur des réponses fournies dans l’Aperçu IA modifie les comportements. Le Pew Research Center a étudié 68 879 recherches réalisées par 900 adultes américains en mars 2025.
Verdict : lorsqu’un résumé IA apparaissait, les utilisateurs cliquaient sur un résultat classique dans 8 % des visites, contre 15 % sans résumé. Ils ne cliquaient sur une source de l’Aperçu que dans 1 % des visites. Ce périmètre américain ne permet pas de prédire la perte de chaque site français, mais l’écart dépasse un simple changement cosmétique.
Une analyse Ahrefs publiée en février 2026 aboutit à un signal comparable avec une autre méthode. À partir de données Search Console, elle compare 150 000 requêtes informationnelles comportant un Aperçu IA à 150 000 requêtes sans Aperçu. Ahrefs estime que la présence d’une réponse générée est associée à un CTR inférieur de 58 % pour la page classée première. Il s’agit d’une estimation et non d’une baisse garantie : d’autres évolutions de Google ou des usages peuvent contribuer au résultat.
J’analysais déjà les premiers signaux de cette érosion dans mon article sur l’impact des AI Overviews sur le trafic organique. Les nouvelles observations invitent à dépasser l’opposition entre être « cité » et « ne pas l’être ». Une citation est un gain de visibilité supplémentaire, à travers un nom, un favicon ou un lien, mais ne garantit aucunement le clic. Plus l’Aperçu restitue la valeur essentielle d’une page, moins l’utilisateur a de raisons de la consulter. La question stratégique devient alors : qu’apporte encore mon contenu après la lecture de la réponse Google ?
Comment se positionner sans surinterpréter ces premiers tests ?
À ce stade, aucune recette d’optimisation ne peut être déduite de cinq pages testées. Le point de départ reste celui du guide officiel de Google : respecter les fondamentaux du SEO et s’assurer notamment que la page est indexable et éligible à l’affichage d’un extrait dans les résultats de recherche.
Google précise par ailleurs qu’aucun balisage Schema.org spécial, fichier llms.txt ou format de contenu spécifique n’est nécessaire pour apparaître dans ses fonctionnalités d’IA. Les données structurées conservent leur intérêt pour le SEO, mais ne constituent pas un prérequis propre aux Aperçus IA.
Pour optimiser pour les Aperçus IA Google, je me limiterais donc à trois repères :
Raisonner au-delà de la requête principale. Google confirme que ses Aperçus IA peuvent utiliser le query fan-out : le système lance plusieurs recherches connexes pour explorer différents aspects d’une question. Ces sous-requêtes ne sont pas accessibles, mais leur principe invite à dépasser le ciblage d’une formulation unique. Pour une intention donnée, identifiez les questions complémentaires, critères, alternatives, comparaisons ou cas particuliers nécessaires à une réponse complète.
Renforcer ce qui fait de la page une source fiable et utile. Clarifiez les passages ambigus, rendez les réponses importantes explicites, sur le fond comme dans la forme, et étayez les affirmations qui le nécessitent avec des sources, des données, des exemples ou une expertise identifiable. Cherchez surtout à apporter davantage que la reformulation d’informations déjà largement disponibles.
Préserver une valeur que l’Aperçu ne peut pas restituer entièrement. Être cité ne garantit pas le clic : l’Aperçu peut déjà satisfaire une partie du besoin informationnel. Donnez donc une raison de consulter la source avec des données originales, une méthodologie, des exemples détaillés, des retours d’expérience, des outils, des démonstrations ou des analyses propriétaires.
Google précise par ailleurs qu’il n’est pas nécessaire de fragmenter artificiellement les pages et ne fixe aucune longueur idéale. Mon ancienne analyse sur les AI Overviews et les contenus longs reste utile pour comprendre les premiers résultats américains, mais elle ne justifie pas d’allonger un article pour atteindre un volume donné.
À surveiller dans la Search Console : le rapport IA
Google déploie progressivement un rapport sur les performances dans l’IA générative, également accessible directement ici. Il montre les pages et les impressions issues des Aperçus IA et du Mode IA, mais pas encore les requêtes, les clics, le CTR ni la forme de la citation. Ces données doivent donc être complétées par l’observation manuelle des SERP.
Voici celui de Conseils Rédaction Web :
Le rapport IA génératif dans la Google Search Console
Aperçus IA : ce que je retiens de ces premiers tests
Le classement organique reste un repère utile, mais les observations présentées dans cet article et les études menées à plus grande échelle conduisent au même constat : être premier sur Google ne garantit ni la citation ni le lien dans les Aperçus IA, et encore moins le clic !
La réponse à cela n’est pas de réécrire tout son site pour l’IA. Elle consiste à suivre les SERP concernées, à comprendre ce qui est extrait et à publier des contenus qui conservent une valeur plus forte que la simple synthèse.
Les Search Agents annoncés par Google prolongeront cette logique dans le temps : certains pourront fonctionner en arrière-plan et surveiller le Web pour détecter les nouvelles informations correspondant à un besoin donné.
Le SEO restera un socle de visibilité, mais l’enjeu s’élargit : produire des sources accessibles, fiables, suffisamment originales et, lorsque le sujet l’exige, actualisées pour être découvertes et mobilisées par des systèmes qui ne se contentent plus de répondre à une requête ponctuelle.