C’est un fait : les accents sont aussi importants que les lettres. Dans la langue française, il existe trois types d’accents : l’accent aigu, l’accent grave et l’accent circonflexe. Et, c’est ce dernier auquel nous allons nous intéresser dans cet article. Origine, histoire, fonction et avenir : découvrez tout sur cet accent « chevron-né ».
À retenir : chapeau bas !
L’accent circonflexe peut se placer sur les voyelles « a », « e », « i », « o » et « u ».
Son influence sur la prononciation varie selon les mots et les usages.
Exemple : bâton, fête, gîte, rôle, flûte.
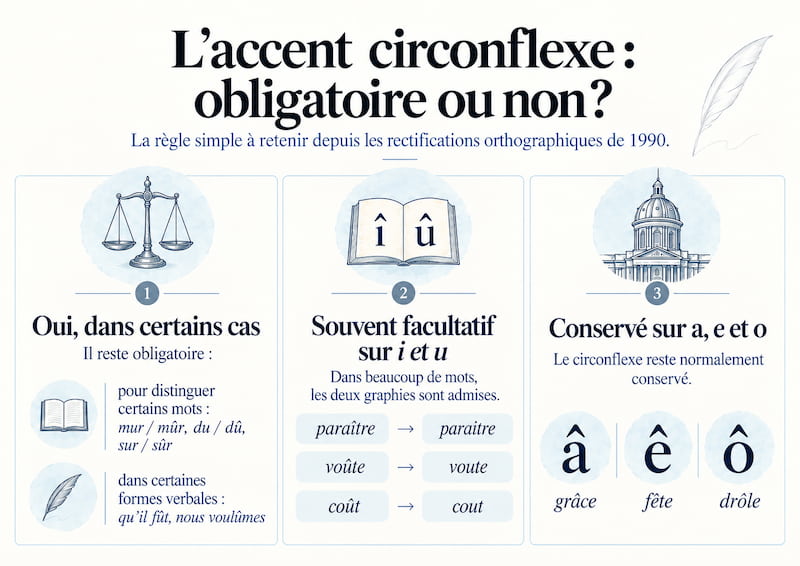
Il permet notamment de distinguer certains homophones ou quasi-homophones. Exemple : mur/mûr ; sur/sûr ; du/dû.
Il sert également à distinguer certaines formes verbales. Exemple : il chanta (passé simple) / qu’il chantât (imparfait du subjonctif).
Une consonne double apparaît très rarement après une voyelle accentuée.
Avec l’accent circonflexe, on rencontre notamment l’exception « châsse » et ses dérivés, dont « châssis ».
Chronologie (rapide) des accents de la langue française
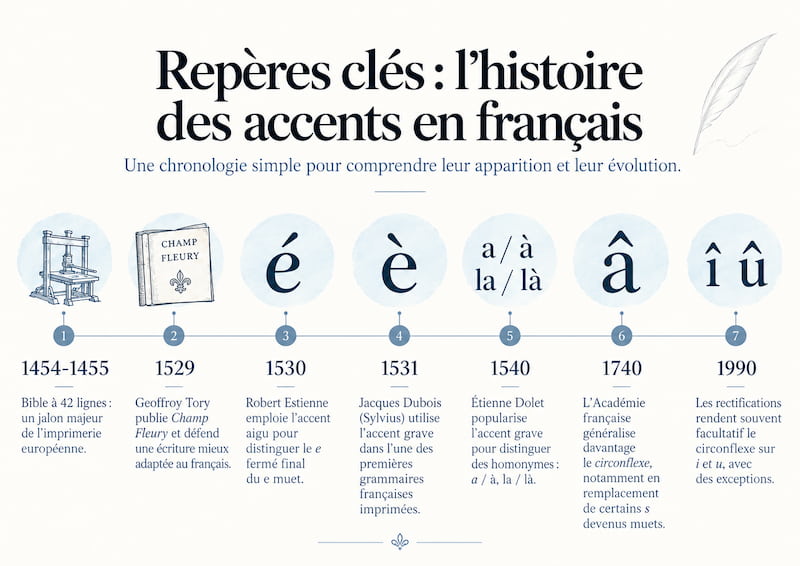
Les accents n’ont pas toujours fait partie de l’orthographe française. Dans les premiers textes d’ancien français, ils sont entièrement absents, et la lecture peut ainsi parfois prêter à confusion. Leur usage se développe surtout à partir du XVIe siècle, avec l’essor de l’imprimerie et les réflexions des grammairiens et imprimeurs sur la manière de représenter plus précisément la langue à l’écrit. Robert Estienne utilise ainsi dès 1530 l’accent aigu pour noter certains « e » fermés.
À cette époque, l’orthographe française est encore très variable : plusieurs systèmes et usages coexistent avant que les conventions ne se fixent progressivement. Les accents aigu, grave et circonflexe participent à cette évolution, même si leur emploi conserve au fil du temps certaines irrégularités.
En 1990, les rectifications de l’orthographe ont notamment proposé de simplifier l’usage de l’accent circonflexe. Sur le « i » et le « u », celui-ci n’est désormais plus obligatoire dans de nombreux mots, mais il reste notamment conservé lorsqu’il permet de distinguer des mots ou des formes grammaticales et dans certaines terminaisons verbales. Les graphies traditionnelles restent toutefois admises.
Alors, faut-il faire le deuil de cet accent emblématique ? Pas vraiment. Voyons cela en détail.
Les accents font bonne impression
L’apparition des accents dans la langue française doit beaucoup aux imprimeurs. Parce qu’ils avaient besoin de copies lisibles, ils ont été des précurseurs en matière de réflexion graphique.
Tout au début, il n’y avait pas franchement de règles précises concernant le rôle et la place des accents dans la langue. Aussi, leur utilisation variait d’un imprimeur à l’autre ou d’un auteur à l’autre.
C’est vers 1454-1455 que l’atelier de Gutenberg à Mayence réalise la célèbre Bible à 42 lignes, premier grand ouvrage européen produit avec des caractères mobiles métalliques. Ce n’est pas le tout premier livre imprimé au monde — des ouvrages existaient déjà en Asie grâce à l’impression xylographique et aux caractères mobiles coréens et chinois — mais il marque une étape majeure dans l’histoire de l’imprimerie européenne.
Bien des années plus tard, en 1529, l’humaniste et imprimeur Geoffroy Tory publie son traité de typographie Champ Fleury. Il y défend notamment le recours à de nouveaux signes graphiques, parmi lesquels la cédille, et appelle à mieux adapter l’écriture à la prononciation du français. Dès l’année suivante, Robert Estienne utilise l’accent aigu pour distinguer le e fermé final du e muet. Ces innovations restent toutefois encore peu stabilisées et leur adoption dans les textes imprimés se fait de manière progressive.
En 1531, l’accent grave est utilisé par Jacques Du Bois, alias Jacobus Sylvius, auteur de l’une des premières grammaires françaises imprimées. À l’époque, l’accent grave sert surtout à marquer le « e » sourd comme dans les mots « gracè » (grâce) ou « bonè » (bonne).
Tous ces usages peuvent nous sembler surprenants, mais en réalité, il s’agissait d’une période faste d’innovations intenses où chacun y allait de son petit signe personnel afin de tenter d’adapter au mieux la prononciation du français à l’alphabet latin dont il a vaillamment hérité.
En 1540, l’imprimeur humaniste Étienne Dolet propose un usage de l’accent grave qui nous est bien plus familier : distinguer les homonymes, par exemple a/à ou la/là.
Ensuite, du XVIᵉ au XVIIIᵉ siècle, l’emploi des accents est resté assez chaotique. L’accent aigu pouvait marquer aussi bien un e fermé qu’un e ouvert, selon les auteurs ou les imprimeurs. Même chez Voltaire, on retrouve encore des formes comme Eugéne, progrés ou encore collége.
Bref, c’était la loose.
Ce n’est qu’au XVIIIᵉ siècle que l’usage moderne commence à s’imposer. Mais certains mots gardent longtemps des graphies flottantes : ainsi, il a fallu attendre 1878 pour que l’Académie française retienne officiellement collège avec un accent grave au lieu de collége.
De tout ce flou orthographique, il nous reste quelques vestiges : abrégement, sécheresse ou encore céleri s’écrivaient avec un accent aigu sur un e pourtant ouvert. Les rectifications orthographiques de 1990 ont cherché à remettre de l’ordre en préférant les graphies abrègement, sècheresse et cèleri. Dans les faits, l’usage n’a pas toujours suivi : sécheresse, par exemple, reste de loin la forme la plus répandue aujourd’hui.
Lisez ce dialogue :
– De toute façon, l’accent circonflexe ne sert à rien.
– Ah, vous êtes sur ?
– Une chaise, pourquoi ?
➡️Attention, l’accent circonflexe reste obligatoire sur le i et le u lorsque le mot présente un risque d’homonymie !
L’accent circonflexe a le complexe du corn-flakes.
Ronsard et les poètes de la Pléiade raffolaient de ce petit chapeau au point de l’utiliser dans leurs poèmes. Pourtant, ce mal-aimé a toujours eu du mal à s’imposer.
L’accent circonflexe nous vient du système d’accentuation du grec ancien. Il traduisait un ton mélodique, avec une voix qui monte puis qui descend.
Et c’est encore Geoffroy Tory qui figure parmi les premiers à expérimenter l’usage du circonflexe en français. Inspiré par les modèles antiques, il l’introduit dans ses travaux typographiques, mais sans véritable règle fixe.
Ainsi, il a notamment servi à indiquer une voyelle allongée à la suite de la disparition ou de la contraction ancienne d’une voyelle ou d’une consonne.
Exemple : bâtir (au lieu de bastir), château (au lieu de chasteau), bête (au lieu de beste), dûment (au lieu de duement).
En 1740, l’Académie française intervient à son tour et généralise largement l’emploi du circonflexe, notamment en remplacement de certains « s » devenus muets.
Il peut ainsi rappeler l’effacement d’une lettre, le plus souvent la lettre « s ».
Exemple : hôpital/hospitalier – forêt/forestier – épître/épistolaire.
Historiquement, il a également servi à noter certaines voyelles longues.
Exemple : diplôme, drôle, grâce, infâme, etc.
ATTENTION toutefois : dans certains dérivés, lorsque la voyelle se retrouve en position atone, le circonflexe disparaît.
Ainsi, on écrit bien : diplomatie, drolatique, gracieux, infamie, etc.
On dit merci qui ? Merci l’Académie qui aime vraiment cultiver la contradiction.
En conclusion, l’accent circonflexe est-il obligatoire aujourd’hui ?
Oui, l’accent circonflexe reste obligatoire dans certains cas. Depuis les rectifications orthographiques de 1990, il est toutefois devenu facultatif sur les lettres « i » et « u » dans de nombreux mots : on peut ainsi écrire voûte ou voute, paraître ou paraitre. Les deux graphies sont admises.
A croire que cette ancienne star vieillissante a été honteusement poussée vers la sortie. Les rectifications de 1990 prônaient non pas la disparition du célèbre chapeau, mais plutôt une outrageuse simplification de son utilisation.
Il est donc désormais possible d’abandonner lâchement l’accent circonflexe après de nombreuses années de bons et loyaux services. Mais pas partout : il reste notamment obligatoire lorsqu’il permet de distinguer certains mots, comme mur/mûr, du/dû ou sur/sûr, ainsi que dans certaines formes verbales comme nous voulûmes, vous suivîtes ou qu’il fût.
Sur les lettres « a », « e » et « o », en revanche, notre petit chapeau conserve sa place.
L’accent circonflexe continue donc de se battre sans relâche et de s’accrocher coûte que coûte. Ce petit chapeau n’est-il pas finalement ce petit supplément d’âme orthographique qui nous plaît tant ?
Et voilà, vous savez tout sur l’accent circonflexe. Si vous souhaitez découvrir d’autres subtilités de la langue française, foncez vite lire notre article sur les exceptions de la langue française et autres règles bizarres.
Et si vous aimez vous exercer en français, découvrez notre mega-quiz de langue française ! Plus de 50 questions vous attendent, avec résultats personnalisés à la fin !
Perplexity a une réputation d’outil de recherche particulièrement à l’aise avec les sources. À ce sujet, les écarts de fiabilité peuvent d’ailleurs être importants dès qu’on confie à une IA une recherche en ligne documentée.
Avec un abonnement Perplexity Pro et sa fonction Recherche approfondie, jusqu’où peut-on aller dans un usage éditorial réel ?
J’ai fait le test sur un article récent de Conseils Rédaction Web consacré aux Aperçus IA de Google. Le texte était déjà bien documenté : observations menées directement dans les SERP, relai et analyse d’études spécialisées, documentation officielle de Google, précautions sur ce que les données permettaient, ou non, de conclure.
À l’aide d’un prompt élaboré, j’ai demandé à Perplexity de réaliser une passe de fact-checking sur cet article, comme pourrait le faire un rédacteur en chef ou un responsable éditorial sur un texte juste avant sa publication. Puis j’ai contrôlé son propre travail en l’opposant à mes propres observations.
Voyons le résultat.
Ce que le test a montré
Les sources et les chiffres ont été correctement contrôlés. Perplexity a retrouvé les études citées, leurs principaux résultats et leur périmètre.
Le contexte éditorial a été bien compris. Il a distingué mes observations de première main des données externes et tenu compte des précautions déjà présentes dans le texte.
Les alertes inutiles sont restées limitées. Quelques suggestions apportaient surtout de la précision supplémentaire, sans corriger de véritable problème.
Une vraie correction lui a échappé. Il a validé un passage fondé sur une étude à grande échelle alors que mon interprétation allait plus loin que ce que l’étude permettait d’affirmer réellement.
Sur ce test, je garderais donc volontiers Perplexity Pro pour sécuriser la partie documentaire d’un article avant publication. La dernière lecture éditoriale reste une autre affaire.
Un article déjà sourcé, et volontairement prudent
Pour ce test, je n’ai pas essayé de trouver un bête article rempli de dates ou de statistiques à la pelle. Au contraire, l’idée était davantage de donner à Perplexity Pro un article de niveau professionnel à fact-checker ; avec un angle, une analyse, des données propriétaires et des faits sourcés.
Une première partie de cet article source repose donc sur mes propres observations. Car j’avais sélectionné cinq pages de Conseils Rédaction Web déjà visibles dans Google, puis étudié plusieurs éléments : leur classement organique, la présence éventuelle d’un Aperçu IA, la façon dont l’article y était cité, la position du bloc organique dans la SERP ou encore les variations de citations entre différentes sessions.
Je précisais dès le départ que cinq pages ne constitueraient évidemment pas une étude statistique. L’objectif était avant tout d’obtenir des observations concrètes, puis de les confronter à des travaux menés sur des volumes bien plus importants.
Le reste de l’article s’appuyait notamment sur plusieurs études Ahrefs, une analyse du Pew Research Center et la documentation officielle de Google.
J’avais également pris soin de formuler chacune de mes conclusions avec des pincettes, davantage sous l’angle du retour empirique que sous celui de la règle définitive. Et je n’ai fait des rapprochements entre mes observations et les études citées dans l’article que lorsqu’elles qu’elles étaient suffisamment étayées.
Ainsi, il allait être difficile pour Perplexity, cette IA spécialisée dans la recherche en ligne, de faire semblant d’être intelligent en remontant des précautions que l’auteur avait déjà prises.
Une passe de fact-checking en « Recherche approfondie »
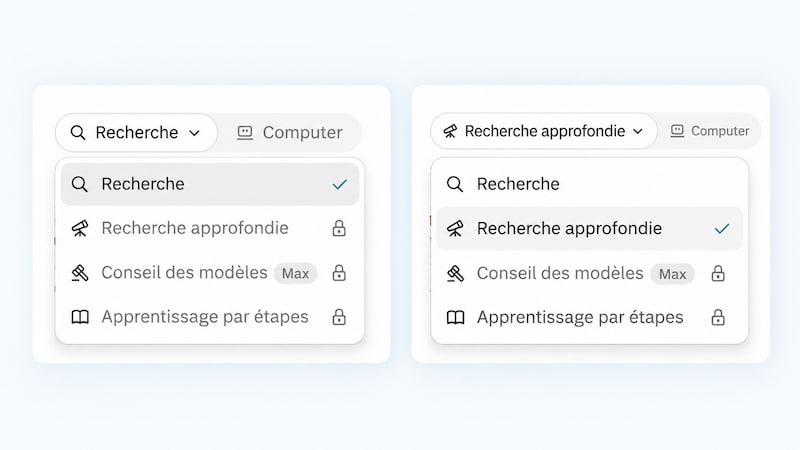
Pour tester la capacité du mode Pro (= le premier mode payant de Perplexity), j’ai lancé le test dans une nouvelle conversation, avec le mode Recherche approfondie activé.
Cette fonctionnalité est accessible aussi avec un compte gratuit, mais à raison d’une seule recherche approfondie par mois. L’abonnement Pro en permet un usage beaucoup plus régulier.
L’article complet a été fourni au format Markdown, accompagné d’un brief de fact-checking neutre mais complet, afin de simuler une demande de relecture professionnelle.
Le brief lui demandait notamment de :
sélectionner lui-même les affirmations qui méritaient réellement une vérification ;
privilégier les sources originales ou primaires ;
vérifier ce que les études mesuraient réellement ;
distinguer observations de première main, faits établis, corrélations, causalités, hypothèses et recommandations ;
tenir compte des précautions déjà présentes dans le texte ;
ne proposer une modification que lorsqu’elle était réellement utile.
De mon côté, j’avais préparé, avant de lancer le test, une grille de contrôle de l’article et des vérifications nécessaires.
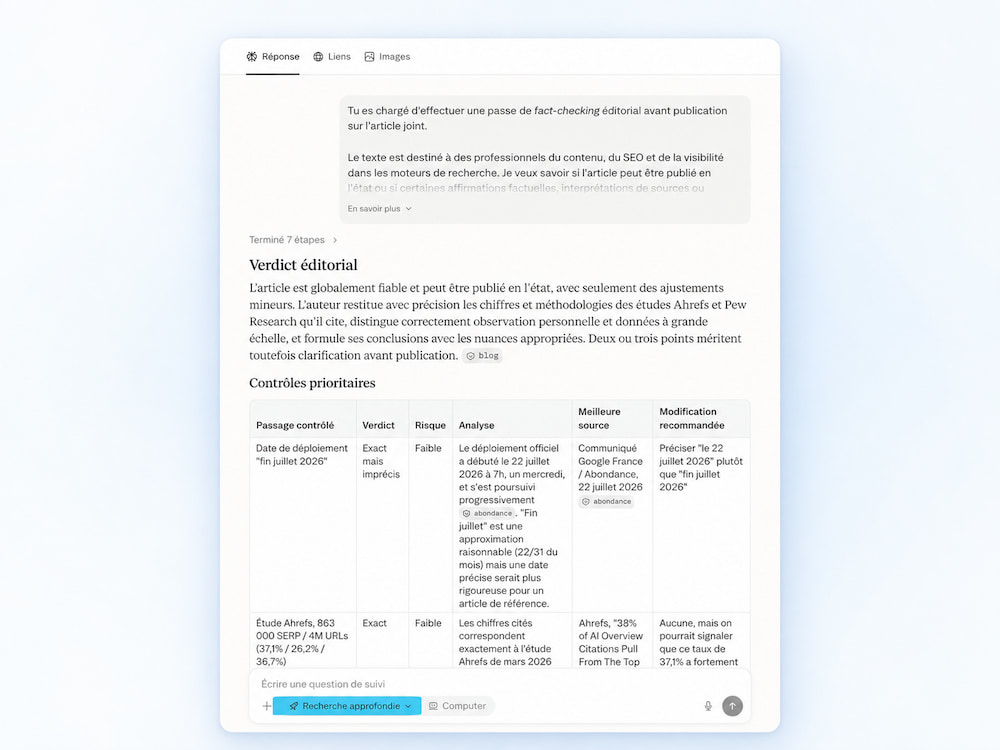
Voici un extrait de sa réponse :
▶
Voir le prompt complet de fact-checking utilisé pour le test
Tu es chargé d’effectuer une passe de fact-checking éditorial avant publication sur l’article joint.
Le texte est destiné à des professionnels du contenu, du SEO et de la visibilité dans les moteurs de recherche. Je veux savoir si l’article peut être publié en l’état ou si certaines affirmations factuelles, interprétations de sources ou formulations doivent être corrigées ou nuancées.
Travaille comme un fact-checker éditorial expérimenté, et non comme un simple moteur de recherche.
Ta mission
Lis d’abord l’article dans son ensemble afin de comprendre :
ce qui relève d’observations de première main de l’auteur ;
ce qui provient d’études ou de sources externes ;
ce qui relève de la documentation officielle ;
ce qui constitue une analyse, une hypothèse ou une recommandation de l’auteur.
Sélectionne toi-même les passages qui méritent réellement une vérification.
Ne cherche pas à vérifier exhaustivement tous les faits triviaux.
Priorise les affirmations dont une erreur, une extrapolation ou une mauvaise interprétation aurait un impact réel sur la fiabilité de l’article.
Pour les affirmations reposant sur une source externe :
remonte autant que possible à la source originale ou primaire ;
vérifie ce que la source mesure réellement ;
son périmètre, sa méthodologie et sa date lorsque cela est pertinent ;
vérifie que la formulation de l’article ne va pas plus loin que ce que la source permet d’établir.
Porte une attention particulière à la différence entre :
fait établi ;
observation de première main ;
corrélation ;
causalité ;
hypothèse plausible ;
interprétation ;
recommandation professionnelle.
Les observations de première main de l’auteur ne doivent pas être invalidées arbitrairement parce qu’une étude plus large montre autre chose.
En revanche, vérifie si l’auteur leur attribue une portée ou une généralité qu’elles ne permettent pas d’établir.
Tiens compte des précautions déjà présentes dans le texte.
Ne présente pas comme une correction nécessaire une réserve que l’auteur formule déjà correctement.
Ne cherche pas artificiellement des erreurs : un passage bien sourcé et suffisamment prudent doit pouvoir être validé comme tel.
Lorsque tu détectes un problème, distingue :
erreur factuelle ;
source mal restituée ;
généralisation excessive ;
causalité insuffisamment démontrée ;
formulation trop affirmative ;
information insuffisamment documentée ;
information devenue obsolète, le cas échéant.
Format du livrable
Commence par un verdict éditorial très court : l’article est-il globalement fiable et publiable en l’état ?
Puis présente uniquement les contrôles qui apportent une vraie valeur au fact-checking dans un tableau comprenant :
passage ou affirmation contrôlée ;
verdict ;
niveau de risque : faible / moyen / élevé ;
analyse ;
meilleure source disponible ;
modification recommandée, uniquement si elle est réellement nécessaire.
Ajoute ensuite une section distincte intitulée « Vérifications importantes ne nécessitant pas de correction » avec les passages pour lesquels tu as effectué une vérification substantielle et conclu que la formulation de l’article était suffisamment exacte et prudente.
Termine par :
les corrections que tu considérerais indispensables avant publication ;
les améliorations facultatives ;
les éventuels points que tu n’es pas en mesure de vérifier avec suffisamment de certitude.
L’objectif n’est pas de produire le plus grand nombre possible de remarques, mais de fournir à un rédacteur en chef une passe de fact-checking fiable, hiérarchisée et directement exploitable.
Les études citées sont correctement vérifiées
Sur la vérification documentaire, le rapport de Perplexity est solide.
Mon article cite par exemple une étude Ahrefs consacrée aux liens utilisés dans les Aperçus IA. Sur 863 000 SERP et environ quatre millions d’URL citées, elle répartissait les pages reprises de la manière suivante :
37,1 % figuraient dans le Top 10 organique de la requête ;
26,2 % se situaient entre les positions 11 et 100 ;
36,7 % n’apparaissaient pas dans les 100 premiers résultats classiques.
Perplexity a retrouvé la bonne étude, les bons chiffres et leur périmètre. Il a aussi correctement relevé que cette version de l’analyse distinguait les liens organiques classiques des autres éléments de la SERP.
Même chose pour une seconde étude Ahrefs consacrée au CTR.
J’écrivais que la présence d’un Aperçu IA était « associée à un CTR inférieur de 58 % pour la page classée première », avant d’ajouter qu’il s’agissait d’une estimation et non d’une perte garantie.
Perplexity a retrouvé les deux échantillons de 150 000 requêtes utilisés par Ahrefs et validé la formulation.
Le rapport n’a pas inventé ici une remarque du type « attention, corrélation ne veut pas dire causalité » alors que le texte avait déjà pris cette précaution.
Bon travail Perplexity.
Mes observations de première main ne sont pas traitées comme des données à “prouver”
Autre point que je voulais surveiller : la manière dont Perplexity allait traiter mes propres tests.
Aucune source autre que la mienne ne pouvait évidemment mentionner les performances de Conseils Rédaction Web dans la SERP, ou dans tel ou tel Aperçu IA. Ce sont des données propriétaires, qui me permettent de mener mes propres tests, à l’échelle de mon propre site.
Perplexity l’a correctement compris. Dans son rapport, il indique que ces données personnelles ne sont pas vérifiables depuis une source extérieure, puis relève surtout que l’articlene leur attribue pas de généralité abusive et introduit ensuite une étude Ahrefs pour prendre du recul.
Même traitement sur mon exemple autour de la requête comment convertir un texte en markdown.
Le rapport relève que la prudence déjà présente dans l’article est adaptée : un exemple isolé ne prouve pas que le mot comment déclenche à lui seul un Aperçu IA.
Un outil de relecture qui transforme chaque donnée originale en « affirmation non sourcée » devient rapidement inutilisable. Même problème s’il répète comme correction une limite méthodologique déjà écrite trois lignes plus haut.
Ici, Perplexity a lu suffisamment attentivement le texte pour éviter ces deux travers.
Certaines propositions d’amélioration auraient peu changé l’article
Ici, on commence à entrer dans la partie contestable de l’analyse de Perplexity Pro. En premier lieu, le rapport contient quelques recommandations discutables dans leur priorité.
L’une des premières concerne la date de lancement français des Aperçus IA.
J’écrivais que Google avait fini par les déployer « fin juillet 2026 ». Perplexity proposait de remplacer cette formulation par la date précise du 22 juillet 2026.
La précision est exacte. Mais elle change très peu de choses au propos d’un article consacré à ce que les Aperçus IA produisent concrètement dans une SERP.
Le rapport suggère également de préciser qu’une autre étude d’Ahrefs avait mesuré une proportion beaucoup plus élevée de citations provenant du Top 10 de la SERP, et donc de produire une explication sur les différences méthodologiques entre les deux études d’Ahrefs.
Quel intérêt éditorial pour mon article ? Je n’ai aucune raison de me lancer dans un travail de comparaison des études d’Ahrefs à cet endroit.
Voici deux exemples qui, pris isolément, ont effectivement un intérêt pour le sujet traité. Mais une information pertinente pour le sujet n’est pas forcément pertinente pour l’angle d’un article, ou le propos qu’il essaie de développer.
Le discernement humain du rédacteur intervient obligatoirement pour arbitrer ce genre de recommandation qui n’est autre que du bruit éditorial.
L’étude Pew : les chiffres sont correctement vérifiés, l’interprétation reste problématique
Le passage le plus intéressant du test se produit lors de l’interprétation de l’étude du Pew Research Center. Il s’agit d’une étude qui évalue le comportement des utilisateurs face aux résumés générés par Google.
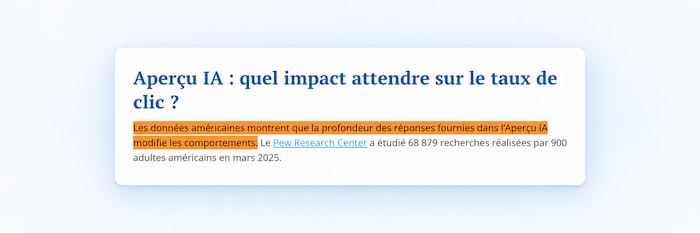
Dans l’article fact-checké, j’avais écrit :
Puis je reprenais les principaux résultats de l’étude :
68 879 recherches ;
900 adultes américains ;
8 % de clics vers un résultat classique lorsqu’un résumé IA était présent ;
15 % lorsqu’il n’y en avait pas ;
environ 1 % de clics vers une source directement citée dans l’Aperçu.
Perplexity a contrôlé ces données et les a retrouvées dans la source.
Son verdict sur le passage : exact, aucune correction requise.
C’est pourtant le passage de l’article qui méritait le plus clairement d’être repris.
En réalité, le premier problème de mon interprétation de cette étude vient du mot « profondeur ».
Pew donne bien des informations sur la longueur des résumés. L’étude ne démontre pas pour autant que cette longueur ou cette profondeur explique les différences de clic observées. La comparaison porte avant tout sur la présence ou l’absence d’un résumé IA.
Le deuxième problème tient au verbe « modifie ».
Il suggère une relation causale plus forte que ce que permet ce protocole. Les données montrent surtout que la présence d’un résumé IA est associée à un comportement de clic différent.
La phrase aurait donc gagné à être reformulée ainsi :
« Les données américaines montrent que la présence d’un Aperçu IA est associée à des comportements de clic sensiblement différents. »
Le changement paraît minime mais il modifie pourtant précisément ce que l’on affirme avoir appris de la source.
Perplexity avait les bons chiffres, la bonne étude et le bon passage sous les yeux. Mais il n’a pas détecté ce décalage.
C’est probablement le point qui m’intéresse le plus dans cette expérience : un fact-checking avec l’IA peut être exact sur toutes les données et rester incomplet sur ce que le texte leur fait dire.
Où je placerais Perplexity Pro dans un workflow éditorial
Cet unique test ne permet pas de poser un avis définitif sur la fiabilité de Perplexity Pro. Il permet en revanche de voir assez concrètement où il se positionne dans le processus de contrôle éditorial, et à quel point sa fonctionnalité de recherche approfondie peut être utile lors de la relecture d’un article documenté.
Tâche
Utilisation après ce test
Retrouver la source originale d’un chiffre
Oui
Contrôler dates, chiffres et échantillons
Oui
Vérifier le périmètre général d’une étude
Oui
Distinguer une donnée externe d’une observation de première main
Oui
Repérer qu’une réserve méthodologique est déjà présente
Plutôt oui
Hiérarchiser ce qui mérite réellement correction
À contrôler
Vérifier que chaque formulation reste strictement dans les limites de la source
À contrôler
Valider seul la publication
Non
Je l’utiliserais donc assez volontiers en amont de la dernière relecture.
La Recherche approfondie peut prendre en charge une partie fastidieuse du travail : revenir aux études, vérifier les métriques, retrouver la documentation officielle et signaler des incohérences éventuelles. Ce recours systématique au web et aux sources originales fait d’ailleurs partie des moyens les plus utiles pour améliorer la fiabilité d’un LLM sur des tâches factuelles.
Quant à la dernière passe, elle ne porte plus exactement sur la même chose.
Il faut alors relire le texte comme un texte : regarder comment les données sont articulées, si une formulation ajoute une causalité qui n’existe pas dans la source, si une recommandation mérite réellement d’être intégrée ou si une remarque techniquement correcte ne ferait qu’alourdir le contenu.
Dans mon test, c’est précisément à cet endroit que la différence est apparue.
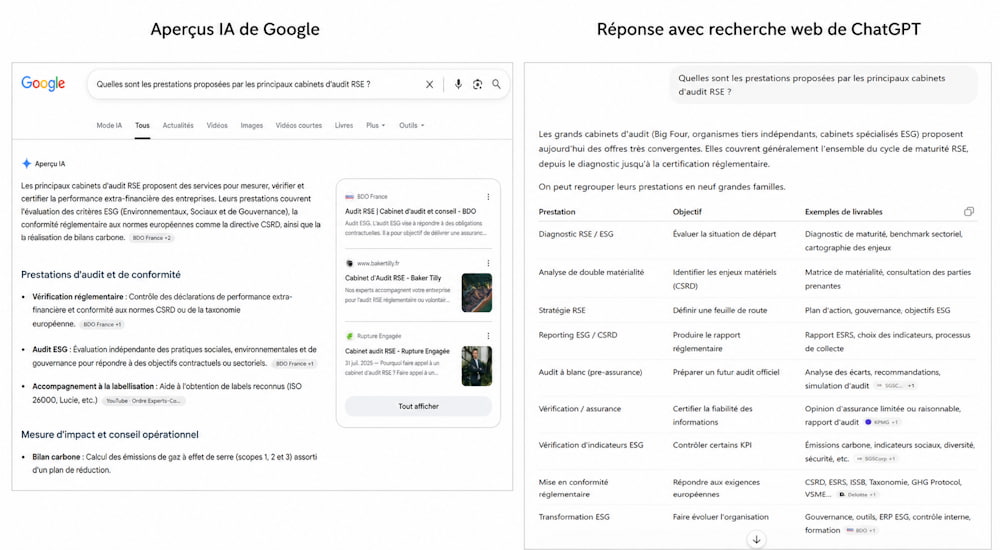
L’époque où les moteurs de recherche se contentaient d’ordonner les pages les plus pertinentes dans une liste de résultats est révolue. Google, ChatGPT, Perplexity et autres savent à présent formuler directement une synthèse, recommander plusieurs solutions ou construire un comparatif à partir de votre requête ou votre prompt, et des informations qu’ils retrouvent en ligne.
Cette évolution crée un nouvel enjeu pour les marques et les éditeurs : leurs contenus doivent pouvoir être sélectionnés et correctement représentés, y compris lorsque l’utilisateur ne visite aucun site. Avant, les sites étaient en compétition pour capter le clic de l’utilisateur. Le clic n’est pas (encore) mort, mais la citation est devenue un nouvel enjeu.
C’est précisément dans ce cadre que se définit l’Answer Engine Optimization, ou AEO. L’optimisation pour les moteurs de réponse prolonge le travail SEO afin d’améliorer la présence d’un contenu, d’une organisation ou d’une offre dans les réponses générées par l’intelligence artificielle.
Ce guide en présente les mécanismes, les leviers réellement défendables et une méthode de mise en œuvre pour agir rapidement sur vos propres contenus.
Les infos essentielles du dossier
L’AEO ne remplace pas le SEO : il en élargit l’objectif.
Une page doit toujours être accessible, indexable, fiable et bien reliée au reste du site. Mais la réussite ne se limite plus à une position dans Google : elle peut prendre la forme d’une mention, d’une citation ou d’une représentation exacte de la marque dans une réponse générée.
N’essayez pas d’optimiser vos contenus pour une liste de prompts précis.
Les moteurs de réponse décomposent chaque demande en sous-requêtes variables. Il est plus utile de travailler des familles de questions et de couvrir les critères dont l’IA aura besoin pour construire sa réponse.
Commencez par un périmètre resserré et directement utile à l’activité.
Sélectionnez trois à cinq familles de questions, cinq à dix pages prioritaires et quelques concurrents de référence. Pour chaque sujet, cherchez si votre faiblesse vient d’un manque de couverture, de preuves, de visibilité externe ou d’une mauvaise représentation de votre offre.
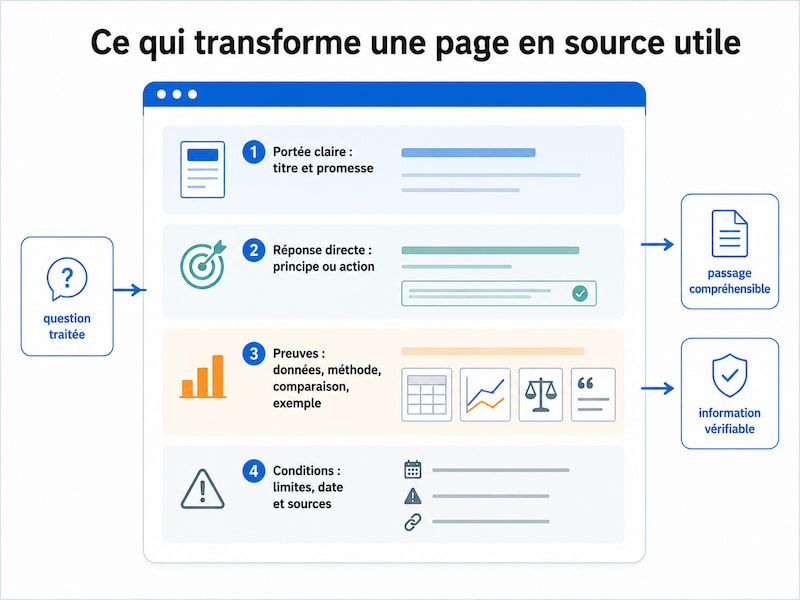
Transformez chaque page prioritaire en source exploitable.
La réponse principale doit être immédiatement identifiable, puis étayée par des faits datés, des exemples, une méthode, des conditions d’application, des limites et des sources. La longueur, l’ajout d’une FAQ ou le balisage Schema ne suffisent pas, à eux seuls, à rendre un contenu citable.
La visibilité AEO se construit également hors de votre site.
Les comparatifs, médias spécialisés, communautés, partenaires et contenus vidéo participent au consensus à partir duquel les moteurs décrivent et recommandent une marque. L’enjeu consiste à apparaître dans les environnements déjà reconnus sur votre sujet, sans fabriquer artificiellement des mentions.
Ne mesurez pas l’AEO comme un simple classement.
Suivez la fréquence des mentions et des citations, l’exactitude des réponses, les pages exposées, le trafic référent, les recherches de marque et les conversions. Le clic peut devenir moins fréquent, mais aussi plus qualifié : l’utilisateur a souvent déjà précisé son besoin, compris les options disponibles et identifié les acteurs pertinents avant d’arriver sur le site.
Qu’est-ce que l’AEO, et que change-t-il par rapport au SEO ?
L’AEO, pour Answer Engine Optimization, regroupe les actions destinées à améliorer la présence, l’utilité et l’exactitude d’un contenu, d’une organisation ou d’une offre dans les réponses produites par des moteurs.
Initialement, ce terme couvrait tout type de réponse présente dans les résultats du moteur (Featured Snippet, PAA…). Depuis l’arrivée des AI Overviews (Aperçus IA), son emploi a désormais évolué aux réponses des moteurs générées à l’aide de l’intelligence artificielle.
En explorant ce nouveau terrain de jeu, vous rencontrerez aussi fréquemment les termes GEO (pour Generative Engine Optimization), et LLMO (pour Large Language Model Optimization). A date, aucun standard ne délimite aujourd’hui clairement ces trois expressions.
En dépit de leur chevauchement, on remarque généralement que :
l’AEO met l’accent sur la réponse fournie à l’utilisateur dans un moteur de recherche,
le GEO élargit le sujet à la visibilité dans les environnements de recherche générative,
le LLMO insiste davantage sur la manière dont les grands modèles de langage identifient et associent les contenus, les concepts et les marques.
Ces distinctions restent toutefois des conventions d’usage, et non trois disciplines dotées de méthodes indépendantes. Nous retiendrons donc le terme AEO dans ce guide, parce qu’il décrit directement l’objectif opérationnel poursuivi : améliorer sa présence dans les moteurs de réponse.
Maintenant que la définition est clarifiée, parlons du périmètre d’action du AEO. Le premier point à retenir est le suivant : le AEO ne rend pas le SEO obsolète.
Une page introuvable, non indexable, mal reliée au reste du site ou peu crédible part avec un handicap avant même que se pose la question de sa citation. Google indique d’ailleurs qu’aucune optimisation technique supplémentaire n’est requise pour apparaître dans ses fonctions génératives : les fondamentaux du SEO restent applicables. Le changement porte surtout sur le résultat recherché et, par conséquent, sur la manière de le mesurer.
Dimension
SEO traditionnel
AEO
Unité observée
Page classée dans des résultats
Marque, entité ou source présente dans une réponse
Résultat intermédiaire
Impression, position, clic
Mention, citation, reprise d’une information
Requête
Souvent analysée comme un mot-clé ou une intention
Souvent formulée comme une demande contextualisée et décomposée en plusieurs recherches
Concurrence
Pages visibles dans une même page de résultats
Sources sélectionnées et informations retenues pour composer la réponse
Mesure
Positions, impressions, clics, conversions
Présence, citations, représentation, trafic assisté et conversions
Parce que l’unité observée n’est plus seulement la position d’une page, une progression AEO peut prendre plusieurs formes :
votre marque est recommandée, avec ou sans lien ;
une de vos pages est affichée parmi les sources ;
une définition, une donnée ou une procédure issue de votre contenu contribue à la réponse ;
l’utilisateur retient votre nom, puis revient par une recherche de marque ou un accès direct ;
la réponse décrit correctement votre offre, même si elle ne génère pas immédiatement de visite.
La valeur de ces résultats dépend de ce que la réponse dit réellement et de ce que l’utilisateur en fait.
Cas de figure typique : une marque peut très bien être mentionnée de manière inexacte, tandis qu’une page affichée parmi les sources peut n’avoir fourni aucune information décisive à la synthèse. Même le clic ne constitue pas une fin en soi s’il ne débouche sur aucun engagement utile.
À retenir : l’AEO ne cherche pas une hypothétique « première position dans les IA ». Il vise une présence utile, exacte et mesurable dans les réponses qui comptent pour votre public.
Cette conception élargie de la visibilité devient particulièrement importante à mesure que les réponses immédiates réduisent le recours aux liens traditionnels.
Un impact bouleversant sur le CTR
sur les liens SEO classiques…
Dans une étude portant sur l’activité de navigation de 900 adultes américains en mars 2025, le Pew Research Center a relevé un clic vers un résultat classique dans 8 % des visites comportant un résumé IA, contre 15 % lorsqu’aucun résumé n’apparaissait.
…Et sur le CTR sur les liens dans le résumé IA
Les liens intégrés dans le résumé lui-même n’ont reçu un clic que dans 1 % de ces visites. L’étude ne permet pas de généraliser ces proportions à tous les pays ni à toutes les plateformes, mais elle montre que l’accès à une réponse immédiate peut réduire fortement les clics vers les sites sources.
L’impact des AI Overviews sur le trafic organique oblige dès lors à préserver sa place au moment où l’utilisateur comprend, compare et forme sa préférence, sans limiter l’analyse au trafic récupéré.
Une nouvelle grille de lecture, plus qualitative
En réalité, le clic change de place (et de valeur) dans le parcours
Ce chapitre est important, car le changement de grille de lecture « SEO vs. AEO » se joue ici.
Dans une SERP classique, l’internaute clique souvent sur un lien pour découvrir si la page répondra réellement à sa question.
Dans un moteur de réponse, l’utilisateur ne se charge plus de l’exploration. Il peut formuler son contexte en langage naturel, ses contraintes et ses critères de décision, puis obtenir une synthèse qui compare les options et met certaines sources en avant.
Lorsqu’une marque apparaît à ce stade, elle entre dans son champ de considération avant même la visite du site.
Cette exposition conserve donc une valeur sans clic immédiat. Et lorsque l’utilisateur clique depuis la réponse IA, il dispose déjà d’une première compréhension du sujet et d’une raison plus « engagée » de consulter la source.
Cette qualification potentielle ne relève plus seulement de l’intuition. Google indique que les utilisateurs qui quittent un AI Overview pour approfondir un sujet produisent des clics de meilleure qualité, notamment parce qu’ils passent davantage de temps sur les sites visités.
Les données publiées par Adobe vont dans le même sens : dans le retail américain, en mai 2026, les visites issues de l’IA affichaient un engagement supérieur de 15 % et un taux de conversion supérieur de 54 % (!!) aux autres sources de trafic. Elles présentaient également un taux de rebond inférieur de 36 %.
Dit autrement : l’AEO peut réduire structurellement le trafic d’un site internet, mais peut également produire une valeur disproportionnée lorsque l’utilisateur consulte le site après une phase de recherche et de comparaison déjà avancée.
Nouvelle grille de lecture : l’AEO ne remplace pas le clic. Il ajoute des niveaux de valeur en amont :
être présent dans la réponse,
être correctement représenté,
être identifié comme une source,
puis accueillir les utilisateurs qui ont encore besoin d’approfondir ou qui sont prêts à agir.
Comment un moteur de réponse trouve-t-il ses sources ?
Un moteur de réponse ne consulte pas une seule page avant de lui attribuer une position fixe. Selon la question et le produit utilisé, il peut s’appuyer sur les connaissances déjà intégrées au modèle, lancer des recherches sur le web, rapprocher plusieurs sources et n’exploiter que certains passages de chacune. La réponse finale résulte de cette combinaison, ce qui explique qu’elle puisse varier d’une exécution à l’autre. On parle de volatilité des réponses.
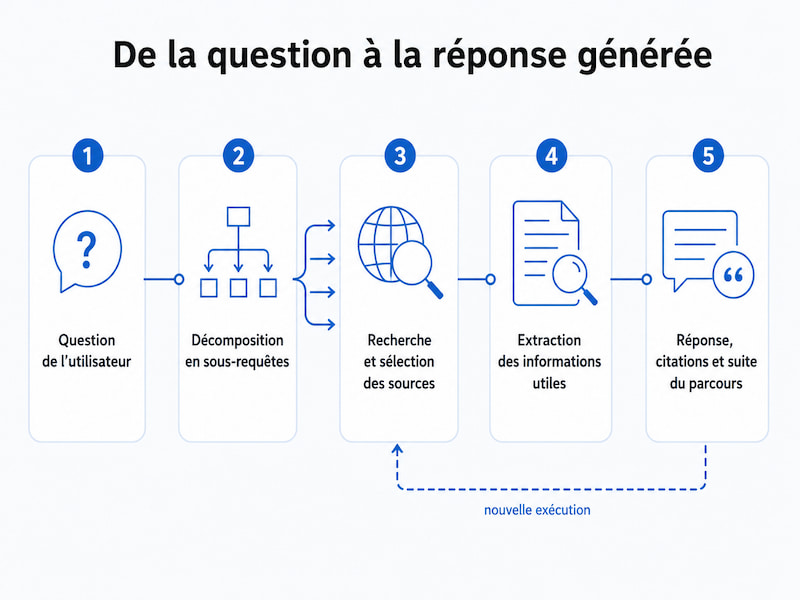
Le détail complet des systèmes reste propriétaire des laboratoires d’IA que l’on connaît tous, mais on peut tout de même décomposer le processus en cinq étapes.
Activation de la recherche : le système détermine s’il peut répondre directement ou s’il doit récupérer des informations externes. Les réponses portant sur l’actualité, un produit précis ou une situation complexe ont davantage besoin de sources à jour.
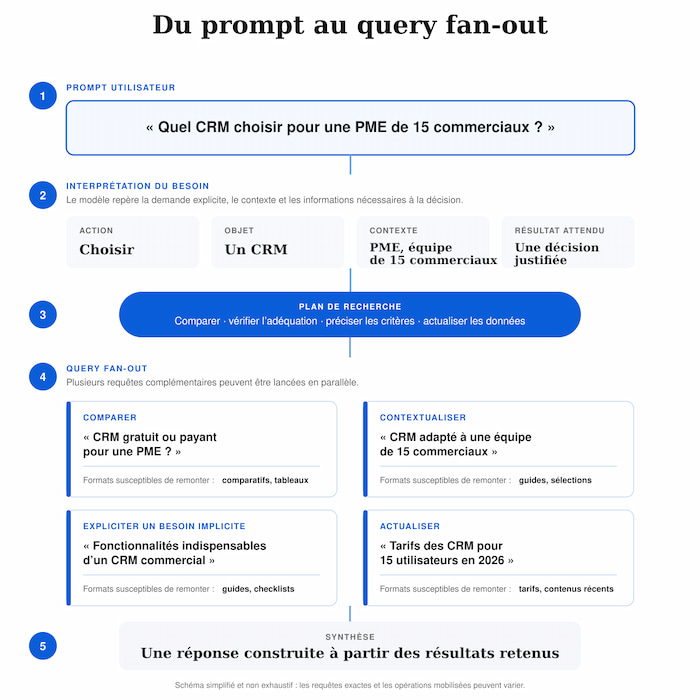
Décomposition du besoin : une question complexe peut être transformée en plusieurs recherches complémentaires, exécutées en même temps. C’est ce qu’on appelle le « query fan-out« . Google a confirmé l’emploi de cette technique, dans ses Aperçus IA et le mode IA. Par exemple, une demande sur le choix d’un logiciel peut déclencher un « query fan-out » sur ses fonctions, son prix, ses limites, ses alternatives…(cf. visuel explicatif ci-dessous).
Récupération et sélection des sources : le moteur retrouve des pages, puis détermine celles qui peuvent contribuer à la réponse. L’éligibilité technique, la pertinence, la langue, le marché, le type de source et différents signaux d’autorité interviennent à ce stade. Leurs poids ne sont pas publics.
Exploitation des informations : une page sélectionnée peut seulement figurer dans la liste des sources ou contribuer réellement à la définition, aux faits, à la comparaison ou à la procédure présentés. Les processus de sélection et d’attribution sont loin d’être évidents. Par exemple, une étude de 2026 a remarqué que les contenus d’actualité sont souvent retenus parmi les sources dans les réponses IA, mais leur contribution moyenne à la réponse reste plus faible que celle des pages encyclopédiques. Une source fréquemment sélectionnée n’est donc pas nécessairement une source fortement intégrée dans la construction de la réponse finale.
Présentation et comportement de l’utilisateur : le moteur génère une réponse, choisit éventuellement des citations et laisse l’utilisateur poursuivre sa conversation. Celui-ci peut cliquer sur les sources, reformuler sa question ou ne rien faire.
Qu’apprend-on avec ce processus ?
Cette décomposition montre pourquoi l’optimisation d’un prompt exact constitue une mauvaise cible. Comme le moteur peut reformuler le besoin et produire des sous-requêtes différentes à chaque exécution, ces formulations synthétiques ne se travaillent pas comme une nouvelle liste de mots-clés.
Leur intérêt est ailleurs : au-delà de la requête pure, le query fan-out révèle surtout les informations, les critères, les angles ou encore les entités que le système juge nécessaires pour construire sa réponse.
Ce fonctionnement introduit également une notion de variabilité, absente d’un classement traditionnel : une même question ne produit pas nécessairement la même réponse, les mêmes sources ou les mêmes citations à chaque essai.
Il faut donc distinguer l’observation ponctuelle de la mesure. Une capture d’écran peut illustrer la présence de votre contenu dans une réponse, mais elle ne suffit pas à démontrer une progression. Pour identifier une tendance, il faut répéter les tests, utiliser plusieurs formulations proches et comparer les résultats dans le temps.
Les conclusions doivent également rester propres à chaque plateforme. Les moteurs ne s’appuient pas sur les mêmes index, les mêmes sources ni les mêmes mécanismes de sélection et de citation.
Les principes présentés dans la suite constituent donc une base commune, dont les effets devront être vérifiés sur les outils réellement utilisés par vos personas.
Étape 1 : sur quelles réponses devez-vous concentrer vos efforts ?
Avant de réécrire la moindre page, vous devez déterminer dans quelles réponses votre organisation a une raison légitime et utile d’apparaître.
Et cette démarche peut suivre une progression précise :
Identifier ce que les moteurs doivent reconnaître.
Regrouper les questions du public.
Evaluer leur valeur.
Diagnostiquer les écarts de visibilité.
Choisir l’action adaptée.
1. Cartographiez vos entités
Recensez les éléments que les moteurs peuvent avoir à identifier :
le nom principal de l’organisation et ses variantes ;
les produits, services, gammes ou offres ;
les personnes qui portent publiquement l’expertise ;
les concepts, méthodes, études ou indicateurs que vous avez créés ;
les établissements et zones géographiques si l’activité est locale ;
les anciennes dénominations susceptibles de créer une confusion.
Reliez ensuite chaque entité aux problèmes qu’elle résout, aux publics concernés, aux attributs vérifiables et aux sujets sur lesquels elle possède une expertise démontrable.
Cette carte vous permet de clarifier le périmètre réel de votre entreprise. Une fois ce périmètre posé, vous pouvez rechercher les questions qui devraient mobiliser ces différentes entités.
2. Constituez des familles de questions
Partez de plusieurs sources :
requêtes déjà visibles dans la Search Console,
questions adressées aux équipes commerciales, support ou formation,
recherches sur le moteur interne du site,
comparaisons formulées par les prospects,
questions associées (les fameuses « PAA ») et suggestions des moteurs,
prompts recueillis lors d’entretiens ou d’études utilisateurs,
sous-thèmes révélés par l’analyse du query fan-out lorsqu’ils sont accessibles.
Regroupez ces formulations par tâche plutôt que par phrase exacte. Une famille peut par exemple couvrir « comprendre », « choisir », « comparer », « mettre en œuvre », « résoudre un problème » ou « vérifier une information ».
À partir de ces familles, constituez un panel de prompts destiné à observer les réponses des différentes plateformes. Ce panel est un instrument de test : il permet de varier le niveau de contexte et la formulation d’un même besoin, mais ne doit pas devenir une liste d’expressions à répéter mécaniquement dans vos contenus.
Exemple
Prenons l’exemple d’un organisme qui propose des formations à la cybersécurité pour les PME.
Sa cartographie peut faire ressortir plusieurs entités : le nom de l’organisme, ses formations, ses formateurs, une méthode d’audit qu’il a développée, ses certifications et les villes dans lesquelles il intervient.
Ces entités peuvent ensuite être reliées à plusieurs familles de questions :
comprendre : « Que contient une formation de sensibilisation au phishing ? »
choisir : « Quelle formation en cybersécurité pour une PME ? »
comparer : « Formation en ligne ou en présentiel pour sensibiliser ses salariés à la cybersécurité ? »
mettre en œuvre : « Comment organiser une campagne de sensibilisation au phishing dans une PME ? »
vérifier : « Une formation en cybersécurité est-elle obligatoire pour les salariés ? »
trouver un prestataire : « Quel organisme de formation en cybersécurité à Lyon ? »
L’objectif n’est pas encore de produire une page pour chacune de ces formulations. Il s’agit d’abord d’identifier les ensembles de réponses dans lesquels l’entreprise pourrait apporter une information utile, crédible et suffisamment distinctive.
3. Évaluez la valeur de chaque famille
Toutes les familles de questions liées à votre activité ne méritent pas le même effort. Pour les départager, examinez trois critères.
L’importance pour le public
La question correspond-elle à un besoin réel, à une difficulté fréquente ou à une décision importante ? Une formulation peu recherchée peut rester prioritaire si elle intervient à un moment décisif du parcours.
La valeur pour l’organisation
Une présence dans la réponse peut-elle soutenir un objectif précis : faire connaître l’organisation, renforcer sa crédibilité, orienter un choix, générer une demande, favoriser une inscription ou déclencher un achat ?
La légitimité de l’organisation
L’organisation a-t-elle une raison crédible d’apparaître dans cette réponse ? Cette légitimité peut venir de son activité, de son expertise, de son expérience, de ses données ou de son rôle sur le sujet.
Reprenons l’exemple de l’organisme de formation en cybersécurité pour les PME.
Famille de questions
Importance pour le public
Valeur pour l’organisme
Légitimité
« Comment sensibiliser ses salariés au phishing ? »
Forte : la question répond à un problème concret de prévention.
Forte : elle peut conduire vers une formation ou un accompagnement.
Forte : l’organisme intervient directement sur ce sujet.
« Quelle formation en cybersécurité choisir pour une PME ? »
Forte : la question intervient au moment de comparer des solutions.
Très forte : elle est proche d’une décision d’achat.
Forte, mais avec un risque de discours trop commercial.
« La formation à la cybersécurité est-elle obligatoire en entreprise ? »
Forte : la réponse peut conditionner une décision ou un budget.
Moyenne : elle peut faire naître un besoin, sans intention d’achat immédiate.
Partielle : l’organisme peut expliquer les conséquences pratiques, mais les sources juridiques restent centrales.
4. Diagnostiquez vos écarts
Interrogez plusieurs moteurs avec un petit panel stable, puis confrontez leurs réponses à vos contenus et à la présence de vos concurrents.
Écart
Question de contrôle
Action probable
Couverture
Les bonnes questions sont-elles traitées par une page suffisamment complète ?
Mettre à jour ou restructurer une page, ou créer le contenu manquant
Preuve
Les affirmations importantes sont-elles précises, datées et vérifiables ?
Ajouter des données, une méthode, des exemples et des sources
Représentation
La marque, l’offre ou la personne est-elle décrite correctement ?
Clarifier les informations officielles et, si possible, faire corriger les sources tierces erronées
Distribution
Les sources tierces qui font autorité sur le sujet connaissent-elles et citent-elles cette ressource ?
Diffuser la ressource et solliciter des mentions ou des citations légitimes
Consignez ensuite chaque écart dans un backlog opérationnel. Une entrée doit permettre de comprendre la situation observée et l’action à engager.
❌ « ChatGPT | Phishing | Non cité »
✅ « ChatGPT | Sensibilisation au phishing | Deux concurrents mentionnés, dont un cité comme source | Une page de notre site existe, mais elle répond mal à l’intention | Action : la recentrer sur les techniques de phishing les plus fréquentes »
5. Choisissez entre corriger, construire et distribuer
Corriger : une page existe et répond partiellement au besoin. Elle doit être mise à jour, précisée ou restructurée.
Construire : aucun contenu ne couvre correctement la famille de questions ou le format attendu.
Distribuer : l’information existe, mais elle reste confinée au site de la marque ou absente des sources tierces pertinentes.
Ces actions ne sont pas exclusives. Une page peut, par exemple, devoir être corrigée avant d’être mieux distribuée.
Pour commencer, retenez trois à cinq familles de questions, représentées chacune par une ou deux formulations. Associez-les à cinq à dix pages prioritaires et à deux ou trois concurrents. Conservez ce panel pour comparer les résultats entre plusieurs moteurs et renouveler l’observation à intervalles réguliers.
Étape 2 : comment rendre une page exploitable et digne d’être citée ?
On vient de le voir, lorsqu’un moteur de réponse déclenche une recherche en ligne, il décompose la demande initiale en plusieurs sous-requêtes, récupére différentes pages, puis utilise certains passages pour construire les différentes parties de sa réponse. Google décrit notamment ce fonctionnement à travers la génération augmentée par récupération (le fameux RAG) et le query fan-out.
Votre page n’a donc pas nécessairement besoin de répondre, à elle seule, à l’intégralité d’une demande complexe. Elle doit en revanche fournir une réponse particulièrement solide à une ou plusieurs sous-questions utiles.
Cela ne demande pas d’adopter une écriture artificiellement conçue pour la machine. Comme pour le SEO moderne, vous devez produire une ressource qu’un lecteur peut comprendre, vérifier et utiliser. La précaution supplémentaire consiste à faire en sorte qu’une section récupérée indépendamment du reste de l’article conserve un sens suffisamment précis.
Construisez un conteneur de preuves
Considérez la page comme un conteneur de preuves : une ressource au périmètre identifiable qui réunit les informations nécessaires pour soutenir une réponse.
Selon le sujet, ces unités peuvent prendre plusieurs formes :
une définition précise,
un fait accompagné de sa date et de son périmètre,
un critère de décision,
une comparaison,
une procédure,
un exemple réel,
une condition d’application,
une limite,
une source permettant de vérifier l’affirmation.
Toutes les pages n’ont pas besoin de réunir systématiquement chacun de ces éléments. Une page consacrée à une définition n’aura pas la même structure qu’un comparatif ou qu’un tutoriel. L’objectif est de rassembler les unités dont le lecteur a réellement besoin pour accomplir la tâche annoncée.
Les observations disponibles sur les réponses génératives vont dans ce sens : les pages qui contribuent le plus fortement aux réponses étudiées sont généralement bien alignées avec la demande et riches en éléments extractibles. C’est particulièrement le cas des pages qui contiennent des définitions, des données, des comparaisons et des procédures.
Par ailleurs, le format questions-réponses, surabondant sur le web, ne présente à lui seul aucun avantage particulier.
Avant de réviser une page, formulez donc précisément la tâche qu’elle doit prendre en charge, puis recensez les sous-questions indispensables. Ne cherchez pas à anticiper chaque formulation possible du query fan-out et ne créez pas non plus une page pour chacune d’elles.
Ne créez pas une page pour chaque requête du « fan-out » ! Google déconseille cette production de variantes en série et indique que ses systèmes peuvent comprendre la pertinence d’une page sans correspondance littérale avec chaque requête.
Donnez la réponse avant son historique
Une section devient plus facile à parcourir lorsque son ouverture donne au lecteur le principe ou l’action qu’il est venu chercher, avant d’en développer le contexte, les preuves et les limites. Personnellement, j’appelle cela les « unités informationnelles autoportantes ». En une ou deux phrases, vous répondez à la question implicite traitée par la section (celle que se pose le lecteur a priori).
Cette unité informationnelle est suffisante pour couvrir 80% de la réponse. Le contexte, les preuves et les nuances viennent ensuite.
Attention, cette logique ne vous oblige pas à transformer chaque paragraphe en réponse sèche. Elle vous demande en revanche de revoir vos habitudes de rédaction web, en veillant à ne pas enfouir l’information principale sous plusieurs paragraphes introductifs.
Regroupez les informations qui doivent être comprises ensemble
Lorsqu’un moteur de réponse recherche des informations, il peut utiliser un passage précis de votre page pour traiter l’une des sous-requêtes générées en arrière-plan. Vous ne contrôlez ni la taille exacte de ce passage ni la manière dont le moteur découpe le contenu.
Votre objectif est donc plus simple : organisez chaque grande section autour d’une intention claire et réunissez-y les informations qui doivent rester associées pour que la réponse demeure exacte.
Reprenons l’exemple de notre organisme proposant des formations à la cybersécurité pour les PME. Une section intitulée « Quelle formation en cybersécurité choisir pour une PME ? » est trop large : elle peut recouvrir le public à former, les risques concernés, le format pédagogique, la durée, le niveau attendu et le choix du prestataire.
Cette matière gagne à être répartie entre plusieurs sections, par exemple :
« Quels salariés faut-il former en priorité ? »
« Quels risques la formation doit-elle couvrir ? »
« Quel format convient à une PME ? »
« Comment évaluer un organisme de formation ? »
Chaque section conserve une intention dominante. Elle peut néanmoins développer plusieurs éléments étroitement liés. La section consacrée aux salariés prioritaires peut ainsi présenter les fonctions les plus exposées, les risques correspondants et les situations dans lesquelles une sensibilisation de l’ensemble des équipes reste nécessaire.
Pour vérifier votre découpage, posez-vous trois questions :
La section traite-t-elle un besoin identifiable sans ouvrir plusieurs sujets indépendants ?
Les conditions, les exceptions et les preuves nécessaires à la réponse figurent-elles dans la même section ?
Le développement répond-il à une question suffisamment distincte pour mériter son propre intertitre ?
Vérifiez ensuite la précision des passages :
nommez explicitement les personnes, produits, organisations ou concepts concernés ;
placez les exceptions près de la règle qu’elles nuancent ;
indiquez le périmètre et la date des faits qui peuvent évoluer ;
placez la source près de l’affirmation qu’elle soutient ;
évitez les renvois ambigus comme « cette méthode », « ce cas » ou « ils » lorsque leur référent se trouve loin dans la page.
Augmentez la densité d’informations utiles, pas le nombre de mots
Il n’existe pas de longueur optimale valable pour toutes les pages. La bonne longueur dépend du nombre de sous-questions nécessaires, du niveau de preuve attendu et de la complexité de la décision.
Les pages utilisées comme sources par les moteurs IA peuvent être longues, mais leur longueur s’accompagne généralement d’une structure plus claire, d’une meilleure couverture du sujet et d’informations plus faciles à exploiter. Il ne faut donc pas en déduire que l’ajout de texte augmente, à lui seul, les chances d’être cité.
Chaque paragraphe ou bloc doit remplir au moins une fonction utile :
répondre à une sous-question nécessaire ;
apporter une preuve, une source, une condition ou une limite ;
fournir un exemple qui rend l’explication applicable ;
proposer un critère qui aide à comparer ou à décider ;
synthétiser une information importante ou apporter un élément nouveau.
Un développement qui ne remplit aucune de ces fonctions allonge la page sans renforcer la réponse. Supprimez en priorité les répétitions, les transitions génériques, les reformulations sans apport et les paragraphes créés uniquement pour étoffer le contenu.
Appliquez le même raisonnement à la fraîcheur du contenu. Une page mérite d’être actualisée lorsque les données, les recommandations, le produit, la réglementation ou les attentes du public ont changé.
Choisissez le format en fonction de l’information
Un tableau, une liste, une FAQ ou une suite d’étapes ne constitue pas en soi un signal de qualité. Le format n’a de valeur que s’il représente correctement la relation entre les informations.
Utilisez :
un tableau pour comparer des objets selon des critères homogènes ;
une liste ordonnée lorsque l’ordre des actions doit être respecté ;
une liste simple pour regrouper des critères indépendants ;
une FAQ pour traiter de vraies questions complémentaires ;
un paragraphe argumenté pour expliquer une relation, une cause ou une nuance ;
un encadré pour isoler une condition, un avertissement ou une information à retenir.
Une FAQ composée de réponses génériques n’est pas plus exploitable qu’un article générique. De même, un tableau dont les colonnes ne comparent pas les mêmes critères risque de dégrader la compréhension plutôt que de la faciliter.
Les titres, listes et tableaux doivent exposer la logique de la page. Ils ne remplacent pas la matière qu’ils organisent.
Rendez les preuves vérifiables
Toute affirmation importante doit en préciser l’objet, le périmètre et le fondement.
Pour une donnée chiffrée, précisez autant que possible :
ce qui a été mesuré ;
la période concernée ;
la population ou l’échantillon ;
la méthode ;
la source ;
les principales limites d’interprétation.
Pour une recommandation, indiquez les situations dans lesquelles elle s’applique et celles dans lesquelles elle doit être adaptée.
Pour un exemple, distinguez clairement :
le cas réellement observé ;
l’illustration fictive ;
l’hypothèse ;
l’estimation.
Cette proximité entre une affirmation, son contexte et sa preuve ne garantit ni la sélection de la page ni une restitution fidèle. Elle aide néanmoins le lecteur à contrôler l’information et réduit son ambiguïté lorsqu’un passage est extrait de la page.
Les recherches sur les moteurs génératifs montrent en effet qu’une citation affichée ne soutient pas toujours correctement l’affirmation à laquelle elle est associée.
Apportez une information que la synthèse générique ne peut pas remplacer
Une page qui reformule uniquement des connaissances déjà disponibles apporte peu de raisons d’être retenue plutôt qu’une autre.
Google recommande explicitement de créer des contenus non interchangeables : expérience directe, point de vue propre, données originales, analyse ou expertise qui dépassent une synthèse de connaissances communes. Il présente cette valeur distinctive comme l’une des orientations les plus importantes pour la visibilité à long terme dans ses fonctions génératives.
Vous pouvez notamment publier :
une méthode accompagnée de ses critères et de ses limites ;
une étude dont le protocole et l’échantillon sont accessibles ;
un comparatif fondé sur des tests documentés ;
une procédure illustrée par un cas réel ;
une base de données ou un outil utilisable ;
une analyse fondée sur vos propres observations ;
une position d’expert étayée par des faits ;
une FAQ issue de questions effectivement reçues, avec des réponses substantielles.
La même exigence s’applique aux concepts que vous créez. Donnez-leur un nom explicite, définissez leur champ d’application et leur méthode sur une page de référence, puis conservez cette terminologie dans vos autres publications.
Auditer une page prioritaire pour le AEO : par quoi commencer ?
Les meilleurs candidats pour cette tâche sont vos pages actuelles qui disposent d’une légitimité et/ou d’une audience.
Vérifiez les points suivants :
La page répond à une famille de besoins clairement identifiée.
Son titre et son introduction annoncent précisément la tâche traitée.
Chaque grande section répond à une sous-question utile.
Les intertitres décrivent le contenu réel des sections.
La réponse principale apparaît avant les développements secondaires.
Les faits importants comportent une date, un périmètre et une source.
Les recommandations conservent leurs conditions et leurs limites.
Les entités sont nommées sans ambiguïté.
Les tableaux comparent des critères homogènes.
Les étapes sont réellement ordonnées.
Les exemples réels sont distingués des illustrations.
Les citations et les données soutiennent directement l’affirmation voisine.
Les informations devenues fausses ou inutiles ont été supprimées.
Les appels à l’action correspondent à l’intention de la page.
Aucun passage n’existe uniquement pour atteindre une longueur.
Étape 3 : comment obtenir des mentions tierces crédibles ?
Une organisation ne contrôle pas seule la manière dont les moteurs de réponse la décrivent. Lorsqu’ils recherchent des informations en ligne, ceux-ci peuvent confronter les contenus officiels de la marque à des médias spécialisés, des comparatifs, des avis, des discussions communautaires, des vidéos ou des annuaires.
Le travail AEO hors site consiste donc à faire circuler des informations exactes et utiles dans les environnements où le sujet est déjà traité. L’objectif n’est pas de fabriquer artificiellement un consensus, mais de donner à des sources tierces de bonnes raisons de mentionner la marque.
Ciblez les sources déjà visibles sur vos sujets
Ne sélectionnez pas un site uniquement pour son autorité SEO. Commencez par observer les sources tierces citées lorsque votre public compare des solutions, cherche un avis, vérifie une méthode ou formule une demande locale.
La bonne cible est une page qui :
traite réellement la question visée ;
peut accueillir une contribution utile ;
permet de mentionner la marque pour une raison compréhensible.
Où obtenir une mention ?
Pourquoi ces sources comptent-elles ?
Actions possibles
Médias et sites spécialisés
Ils apportent des analyses, des données et des points de vue experts
Proposer une étude, une donnée originale, une interview, une tribune ou une contribution à un dossier
Comparatifs, guides d’achat et sites d’avis
Ils servent à comparer des offres et à formuler des recommandations
Demander une inclusion justifiée, proposer un test, transmettre des informations vérifiables ou faire corriger une donnée
Partenaires et organisations professionnelles
Ils peuvent documenter une relation, une méthode ou un cas réel
Publier une étude de cas, un retour d’expérience, une page partenaire ou une ressource commune
Communautés, forums et sites de questions-réponses
Ils font remonter des problèmes et des usages réels
Apporter une réponse détaillée, déclarer son affiliation et ajouter un lien seulement s’il complète la réponse
Vidéos, podcasts et présentations tierces
Ils conviennent aux sujets qui nécessitent une démonstration ou un échange expert
Participer à une interview, un podcast, un webinaire, une démonstration ou une vidéo comparative
Annuaires et plateformes locales
Ils répondent aux recherches géographiques, transactionnelles ou liées à la disponibilité
Compléter les fiches, préciser les services, les catégories, les zones couvertes et les informations locales
Construisez le netlinking à partir des questions visées
Une campagne de netlinking AEO ne devrait pas commencer par une liste générale de sites à forte autorité. Elle devrait partir des questions sur lesquelles la marque souhaite apparaître.
Pour chaque intention prioritaire :
relevez les pages et les domaines cités par les moteurs ;
identifiez les formats utilisés : comparatif, média, annuaire, forum ou vidéo ;
vérifiez qu’une contribution légitime de la marque est possible ;
définissez le contenu à créer ou à enrichir ;
choisissez une page de destination qui complète réellement la réponse.
Le lien ne doit pas être l’unique objectif. La page tierce doit répondre à une question identifiable et intégrer la marque dans un raisonnement utile : expertise, gamme, implantation, disponibilité, méthode, service ou adéquation à un usage.
Évitez :
les articles conçus principalement pour accueillir une ancre ;
les mentions de marque isolées du raisonnement ;
les contenus généralistes sans réponse précise ;
les publications sans rapport direct avec les sujets visés.
Le suivi des mentions doit aussi porter sur leur exactitude.
Si vous repérez une erreur :
rétablissez les faits sur une page officielle ;
identifiez précisément l’information à corriger ;
contactez la source concernée ;
transmettez un élément vérifiable.
Étape 4 : quels contrôles techniques réaliser en priorité ?
Le volet technique de l’AEO consiste à vérifier que les pages susceptibles de servir de sources peuvent être découvertes, lues et affichées correctement par les moteurs concernés. Il repose d’abord sur les fondamentaux du SEO, auxquels s’ajoutent quelques contrôles propres aux robots et aux infrastructures utilisés par les services d’IA.
Vérifiez l’éligibilité de base
Commencez par les pages qui répondent aux intentions les plus importantes pour votre activité : guides de choix, comparatifs, fiches produit, catégories, contenus récents ou pages locales.
Par exemple, je participe actuellement à une analyse de visibilité menée pour une marque de e-commerce. 98,3 % des mentions observées dans les IA s’appuient sur son propre site. Ce résultat n’est pas généralisable évidemment, mais il montre qu’un problème d’indexation, d’exploration ou de rendu sur les actifs propriétaires peut directement limiter la visibilité de la marque.
Vérifiez en priorité que :
la page est indexable et renvoie vers la bonne URL canonique,
le fichier robots.txt ne bloque pas les répertoires utiles,
le CDN, le pare-feu et les dispositifs de protection contre les robots autorisent les accès souhaités,
le serveur renvoie un code HTTP correct et répond sans erreur répétée,
le contenu principal est présent sous forme textuelle et ne dépend pas uniquement d’une interaction ou d’un rendu côté client,
les liens internes permettent de retrouver la page depuis des sections pertinentes du site,
les redirections conduisent vers une page réellement équivalente,
les données structurées correspondent au contenu visible,
les URL 404 qui reçoivent encore des visites sont analysées avant toute redirection.
NB : Ces vérifications ne garantissent ni l’indexation ni la citation. Elles éliminent les obstacles techniques qui empêcheraient la page d’être prise en compte.
Distinguez recherche et entraînement
Tous les robots d’exploration des IA n’ont pas la même fonction. Autoriser la recherche ne signifie donc pas nécessairement autoriser l’utilisation des contenus pour l’entraînement.
Par exemple, OpenAI documenteOAI-SearchBot comme le robot utilisé pour faire apparaître des pages dans la recherche ChatGPT. Son autorisation peut être gérée séparément de GPTBot, qui lui est associé à la collecte de contenus susceptibles de servir à l’entraînement.
Perplexity distingue également PerplexityBot, qui alimente ses résultats de recherche, de Perplexity-User, utilisé lorsqu’une action d’un utilisateur déclenche la consultation d’une page.
Besoin
Contrôle pertinent
Décision
Apparaître dans les fonctions IA de Google Search
Accès de Googlebot, indexabilité et éligibilité à l’extrait
Aligner la décision sur la politique SEO du site
Être éligible à la recherche ChatGPT
Accès d’OAI-SearchBot et des plages IP publiées
Autoriser si cette visibilité est souhaitée
Être retrouvé dans Perplexity
Accès de PerplexityBot et des plages IP publiées
Autoriser si cette visibilité est souhaitée
Autoriser l’utilisation pour l’entraînement
Règles propres aux robots d’entraînement et politique de contenu
Prendre une décision distincte avec les parties prenantes concernées
Attention :robots.txt exprime des consignes destinées aux robots qui choisissent de les respecter. Il ne constitue pas un contrôle d’accès absolu. À l’inverse, autoriser un robot dans ce fichier ne garantit pas que le CDN, le pare-feu ou un outil de protection ne le bloquera pas ailleurs.
Contrôlez donc la configuration réellement appliquée par votre infrastructure. Cloudflare peut, par exemple, créer ou préfixer le fichier robots.txt servi aux robots et y ajouter des préférences distinctes pour la recherche, l’utilisation dans une réponse générée et l’entraînement. Vérifiez la configuration effectivement servie par le CDN, ainsi que les règles du pare-feu, et pas uniquement le fichier présent dans votre CMS.
Ne surinvestissez pas dans Schema et llms.txt
Les données structurées restent utiles lorsqu’elles décrivent correctement une entreprise, un produit, un article, une vidéo ou une autre typologie de contenu prise en charge par les moteurs. Elles peuvent notamment rendre une page éligible à certaines fonctionnalités enrichies de la recherche.
Rien ne permet cependant d’en faire un levier AEO autonome capable, à lui seul, de provoquer une citation. Google précise qu’aucun balisage Schema spécifique n’est requis pour ses fonctions génératives. Utilisez donc les données structurées justifiées par le contenu visible et par votre stratégie SEO, sans empiler des balises dans l’espoir de forcer leur reprise.
Le fichier llms.txt doit être traité avec la même prudence. Son site officiel le présente comme une proposition de standardisation destinée à fournir aux modèles une présentation synthétique du site et des liens vers ses ressources. Google indique toutefois ne pas l’utiliser pour ses fonctions de recherche générative, et il il n’existe pas de preuve solide que publier un llms.txt augmente directement la citation dans les IA génératives.
Vous pouvez l’expérimenter lorsque son coût de création et de maintenance est faible, notamment pour un site de documentation. Son intérêt réside moins dans un éventuel gain de visibilité que dans la mise à disposition d’un point d’entrée structuré, susceptible de faciliter l’exploration du site par certains agents IA ou systèmes RAG qui choisissent de l’utiliser.
Bien construire son fichier llms.txt
Aujourd’hui, beaucoup de llms.txt ressemblent à des sitemaps déguisés : des dizaines ou des centaines de liens sans hiérarchie ni contexte. Or, si l’on considère que le but est de faciliter le travail d’un agent IA, cette approche est probablement contre-productive.
À l’inverse, le fichier llms.txt de Conseils Rédaction Web a été conçu comme un document d’orientation. L’objectif n’était pas de répertorier l’ensemble du site, mais de guider rapidement un agent IA vers les ressources les plus utiles. Pour cela, les contenus sont organisés par grandes thématiques, les guides de référence sont privilégiés aux articles d’actualité, et chaque ressource importante est accompagnée d’une brève description afin d’en faciliter la sélection. Cette approche reste expérimentale, mais elle illustre la philosophie qui sous-tend llms.txt : aider un agent à comprendre la structure et les contenus clés d’un site, plutôt que lui fournir un simple inventaire de liens.
Étape 5 : comment mesurer la visibilité AEO ?
La visibilité dans les moteurs de réponse ne se mesure pas comme une position SEO. Une même question peut produire des réponses différentes selon le moteur, la formulation employée ou le moment du test.
Pour démarrer, ne cherchez donc pas un indicateur parfait. Mettez en place un suivi simple qui permet de répondre à quatre questions :
Niveau
Question
Indicateurs possibles
Présence
La marque ou le site apparaît-il dans les réponses ?
Impressions, taux de présence, part de voix
Représentation
Comment la marque est-elle présentée ?
Produits ou services associés, concurrents mentionnés, exactitude des informations, sentiment général
L’objectif n’est pas de tout suivre dès le départ. Pour passer de 0 à 1, combinez trois sources : les données fournies par les moteurs, le suivi d’un panel de questions et les résultats observés sur votre site.
Commencez par les questions qui comptent vraiment
Un score global peut progresser alors que la marque perd du terrain sur les demandes les plus importantes pour son activité. Regroupez donc les questions suivies par intention, par exemple :
obtenir un conseil ;
comparer plusieurs solutions ;
choisir un prestataire ou un produit ;
effectuer une recherche locale ;
suivre une tendance.
Pour chaque famille, sélectionnez quelques questions réalistes. Inutile de constituer immédiatement une base de plusieurs centaines de prompts. Une vingtaine de questions bien choisies permet déjà d’obtenir un premier état des lieux. Référez-vous à l’étape numéro 1 de cet article pour choisir les bonnes questions pour votre activité.
Conservez le même panel dans le temps, par exemple pour un relevé mensuel. Les réponses pouvant varier d’une exécution à l’autre, analysez l’évolution globale des résultats plutôt qu’une réponse isolée.
Exploitez les données fournies par les moteurs
Les rapports propriétaires constituent le point de départ le plus solide lorsqu’ils sont disponibles, puisqu’ils reposent sur les expositions réellement enregistrées par la plateforme.
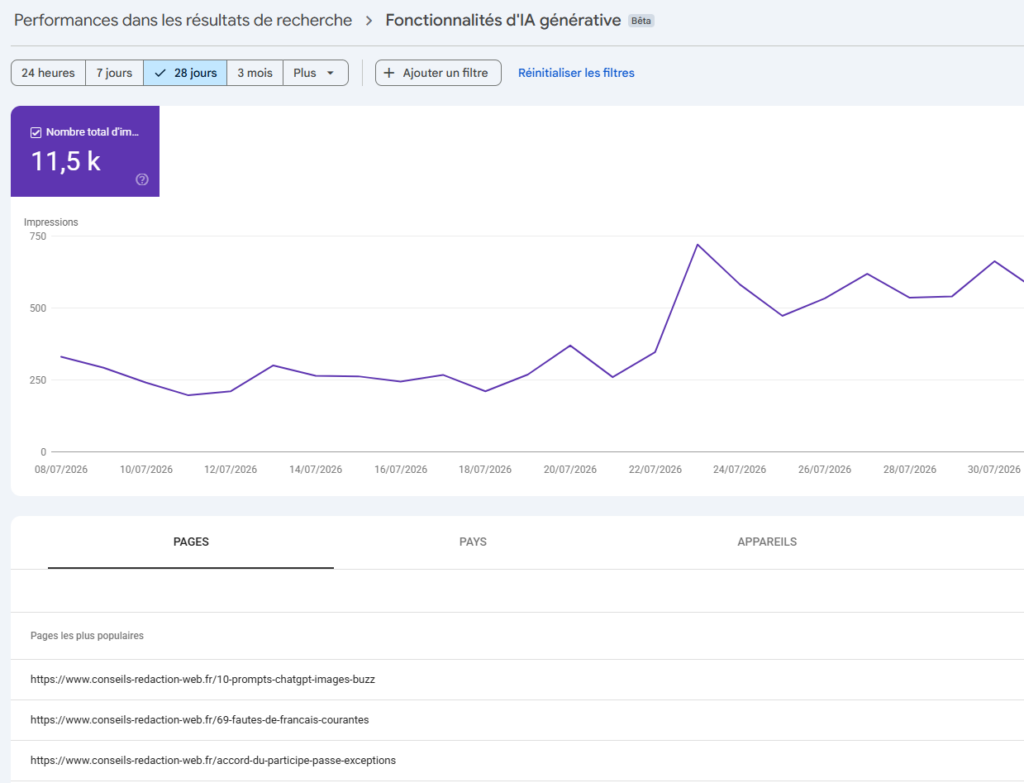
Le rapport consacré aux fonctionnalités d’IA générative dans Google Search Console permet notamment de suivre :
le nombre d’impressions ;
leur évolution dans le temps ;
les pages dont un lien est apparu ;
les pays ;
les appareils.
Il ne fournit pas, à ce stade, les requêtes, les clics ni une position. Utilisez-le donc pour repérer les pages déjà exposées et suivre leur progression, pas pour reconstituer un classement.
Search Console permet de suivre les impressions obtenues dans les fonctionnalités génératives de Google et d’identifier les pages exposées. Le rapport ne fournit pas encore les requêtes, les clics ni les positions.
Automatisez le suivi avec un outil dédié
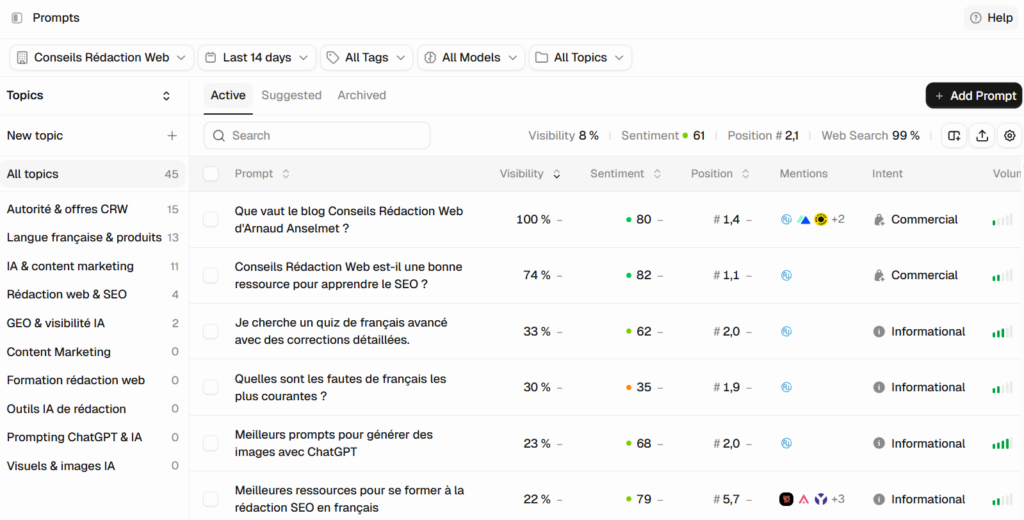
Les rapports fournis par les moteurs ne couvrent que leurs propres environnements. Les outils spécialisés dans le monitoring de la visibilité IA permettent de compléter cette vue en exécutant régulièrement un même panel de questions sur plusieurs moteurs.
Leur fonctionnement est généralement comparable : vous définissez les questions à suivre, vous les regroupez par thème ou par intention, puis l’outil collecte les réponses et agrège les principaux indicateurs.
Commencez par organiser votre panel autour de quelques familles directement liées à votre activité. Par exemple :
conseil ;
comparaison ;
recherche d’un produit ou d’un prestataire ;
recherche locale ;
tendance.
Suivez ensuite, pour chaque famille :
le taux de présence de la marque ;
la part de voix face aux concurrents ;
les questions sur lesquelles la marque apparaît ou reste absente ;
les sources et les URL régulièrement mobilisées.
Cette segmentation permet de repérer rapidement les sujets qui méritent une analyse, sans se limiter à la moyenne générale du projet.
Les outils de monitoring permettent de regrouper les questions par thème ou par intention, puis de suivre la présence de la marque sur chaque ensemble (outil utilisé : Peec.ai)
Le tableau de bord tel que celui présenté ci-dessus signale les évolutions. Pour les interpréter, ouvrez ensuite quelques réponses individuelles, en priorité celles qui concernent une intention stratégique ou présentent une variation importante.
Vérifiez :
comment la marque est présentée ;
quels concurrents sont recommandés ;
quelles pages sont citées ;
si la marque apparaît avec ou sans lien ;
si une information est absente, imprécise ou erronée.
Cette lecture doit conduire à une action identifiable : enrichir une page, créer un contenu manquant, corriger une information officielle, renforcer le maillage interne ou travailler une source tierce déjà mobilisée.
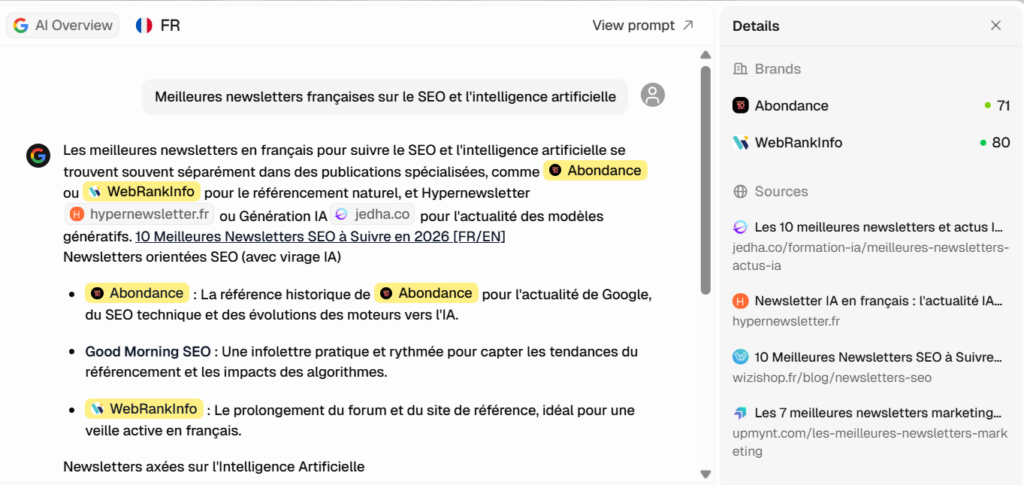
Le prompt ci-dessus concerne les newsletters françaises sur le SEO et l’IA, un territoire que Conseils Rédaction Web cherche à développer. Deux concurrents proches apparaissent, que celle de CRW est absente de la réponse et des sources citées.
Le diagnostic permet de conduire à trois vérifications :
Couverture : existe-t-il une page dédiée qui présente clairement la newsletter, son angle éditorial, sa fréquence et son public ?
Représentation : cette page permet-elle de comprendre immédiatement que la newsletter traite du SEO, de l’IA et de la veille éditoriale ?
Distribution : quelles sélections tierces de newsletters pourraient légitimement mentionner celle de CRW ?
Les actions en découlent directement : créer/renforcer la page dédiée, clarifier le positionnement éditorial et cibler des pages tierces comparables pour obtenir une inclusion argumentée.
Mesurez le trafic attribuable aux assistants IA
Créez dans votre outil d’analyse un segment regroupant les visites provenant des principaux assistants IA.
Suivez notamment :
le nombre de sessions ;
les pages d’entrée ;
les conversions ;
les éventuelles erreurs 404.
Ces données permettent d’identifier les pages qui attirent déjà des visiteurs depuis les assistants IA et d’évaluer la qualité de ce trafic.
Cette mesure reste toutefois partielle. Une personne peut découvrir votre marque dans une réponse, puis revenir plus tard par Google ou en accès direct. Dans ce cas, l’assistant IA n’apparaît pas comme source de la visite.
Pour compléter l’analyse, vous pouvez ajouter une question facultative dans vos formulaires : « Comment avez-vous connu notre organisation ? », avec une option telle que « ChatGPT ou autre assistant IA ».
Conservez un tableau de bord minimal
Conservez un tableau de bord minimal
Pour commencer, suivez quatre indicateurs :
Le taux de présence par famille de questions : part des réponses analysées dans lesquelles la marque apparaît. Il fait ressortir ses territoires de visibilité les plus forts et les plus faibles.
La part de voix face aux principaux concurrents : poids des mentions de la marque par rapport à celles des acteurs suivis sur les mêmes questions.
Les pages et les sources régulièrement citées : d’un côté, les contenus de votre site utilisés dans les réponses ; de l’autre, les sources tierces qui structurent le sujet.
Le trafic et les conversions attribuables aux assistants : visites et résultats commerciaux dont l’origine peut être identifiée dans l’outil d’analyse.
Conseils Rédaction Web est, par exemple, davantage présent dans les réponses liées à la langue française que sur certains sujets auxquels le site consacre pourtant autant de contenus, comme le SEO. Ce décalage révèle un territoire de visibilité déjà établi. Il peut justifier de consolider les contenus existants et de tester des produits ou des offres susceptibles de bénéficier de cette visibilité.
Conclusion : la visibilité du Search se joue désormais avant le clic
L’arrivée des Aperçus IA de Google en France en juillet dernier a définitivement fait basculer le métier du « Search ». Désormais, nous sommes face à des moteurs de réponse qui raccourcissent le chemin entre la question de l’utilisateur et sa prise de décision.
Là où une recherche classique obligeait souvent à ouvrir plusieurs pages, comparer les informations puis reformuler sa requête, une conversation avec une IA permet d’affiner immédiatement son besoin de manière fluide et naturelle, et d’obtenir très facilement une réponse déjà structurée autour des options les plus pertinentes.
Une partie du travail autrefois effectué en ouvrant plusieurs résultats de recherche se déroule désormais directement dans la réponse. Cette évolution déplace ainsi une partie de la valeur en amont du clic.
Les études menées depuis le déploiement des AI Overviews aux États-Unis documentent déjà cette baisse du trafic organique. Mais elle donne aussi davantage de poids à ce qui se passe avant la visite : les marques citées, les solutions recommandées, les arguments retenus et les sources utilisées pour construire la réponse.
Les visiteurs qui poursuivent jusqu’au site peuvent également arriver plus avancés dans leur réflexion. Adobe observait ainsi en mars 2026, dans le retail américain, un taux de conversion supérieur de 42 % pour le trafic issu de sources IA.
Pour les marques, l’enjeu est donc de travailler cette nouvelle couche de visibilité avec méthode, telle que vue dans cet article :
identifier les questions stratégiques,
renforcer les pages capables d’y répondre,
rendre les informations faciles à reprendre,
développer des mentions tierces crédibles,
lever les blocages techniques,
et suivre la présence de la marque par intention.
Pour les équipes SEO, éditoriales et marketing, le prochain chantier consiste donc à étendre la notion de visibilité : suivre non seulement les positions et les clics, mais aussi la place occupée par la marque dans les réponses qui précèdent la décision.
C’est précisément le prolongement que je prépare pour les prochaines semaines avec un playbook AEO conçu pour passer rapidement de l’analyse à l’action. En attendant, merci à vous qui avez lu l’article jusqu’au bout. Et n’hésitez pas à partager vos observations en commentaires.
Ça y est, c’est officiel. C’est finalement fin juillet 2026 que Google aura fini par déployer les Aperçus IA et le Mode IA en France.
Concrètement, sur certaines requêtes, le moteur ne se contente plus d’afficher des liens : il génère une réponse, cite plusieurs sources et permet de poursuivre la recherche sous forme de conversation.
La communication de Google présente la nouvelle fonctionnalité, mais montre peu ce qu’elle change concrètement dans une SERP française. Quelle place les résultats organiques conserveront-ils à terme ? Pour le savoir, j’ai testé des requêtes sur lesquelles Conseils Rédaction Web disposait déjà de pages bien positionnées dans les résultats SEO classiques.
Ces observations ne constituent pas une étude statistique. Elles offrent plutôt un point de départ concret pour examiner ce que les Aperçus IA changent déjà dans les SERP, puis confronter ces constats aux études disponibles et aux mécanismes documentés par Google.
À la clé : mieux comprendre quand ces résultats apparaissent, comment leurs sources se distinguent des classements organiques classiques et quels repères solides en tirer pour travailler sa visibilité (sans prétendre délivrer la nouvelle recette « GEO » à la mode !).
À quoi ressemblent les Aperçus IA dans une SERP française ?
Sur ordinateur, l’Aperçu IA s’affiche d’abord dans un encart de quelques lignes, terminé par un bouton « Afficher plus ». La réponse se développe directement dans la page de résultats. Elle peut occuper une partie ou l’intégralité de l’écran, avant même que l’utilisateur ait atteint le premier lien organique.
Concernant la réponse, il n’y a pas de longueur figée. Lors de mes tests, les réponses développées comptaient généralement entre 15 et 30 lignes, auxquelles pouvaient s’ajouter des listes ou une vidéo, par exemple.
Et systématiquement dans l’Aperçu :
des liens ponctuels en clôture des différents paragraphes,
un panneau de sources plus complet sur la droite de la réponse,
et un champ de discussion pour poser une question complémentaire (et déclencher le « Mode IA » 🤫).
Affichage de l’Aperçu IA de Google
Mes premiers tests des Aperçus IA Google
Voici les observations les plus intéressantes. Mais juste avant, quelques mots sur la manière dont j’ai mené ces tests.
Méthodologie
J’ai sélectionné cinq pages de Conseils Rédaction Web qui bénéficiaient déjà d’une visibilité SEO établie : deux articles consacrés à la langue française, deux à ChatGPT, et un outil.
Les requêtes ont été saisies telles qu’un internaute pourrait les formuler dans Google, sans majuscules ni ponctuation.
J’ai conservé le même navigateur, le même réseau et la navigation privée, puis répété certaines recherches dans plusieurs sessions, pour tester la volatilité des réponses.
Pour chaque SERP, j’ai relevé quatre éléments :
la position de l’Aperçu IA dans la SERP,
le classement organique « classique » de mon article,
les passages et formats des sources utilisés,
puis la présence éventuelle de mon site dans la réponse, et son emplacement.
Qui Google cite-t-il en priorité ?
Sur mes quatre tests principaux, aucune hiérarchie simple ne se dégage. Une bonne position organique reste un avantage évident pour être visible dans Google, mais elle ne suffit pas à prédire la présence dans l’Aperçu IA.
Requête testée
Position organique de mon article
Citation dans l’Aperçu observé
quelles sont les fautes de français les plus courantes
2
Oui, dans le texte et parmi les sources
autant pour moi ou au temps pour moi
8
Non
quels sont les meilleurs prompts ChatGPT pour créer des images
1
Oui, à plusieurs endroits
comment rendre ChatGPT plus fiable
1
Non
L’analyse relève finalement du cas par cas. Par exemple, sur « comment rendre ChatGPT plus fiable », mon article est en première position des résultats organiques classiques. Pourtant, il ne ressort pas dans l’Aperçu IA observé, qui s’appuie plutôt sur des médias spécialisés, des publications LinkedIn et plusieurs vidéos.
Par ailleurs, le fait qu’une page occupe la première position organique ne signifie pas qu’elle domine nécessairement sur tous les signaux susceptibles d’entrer en jeu. D’autres dimensions classiques du SEO (autorité du site, profil de liens, ancienneté ou fraîcheur du contenu, niveau de concurrence…) peuvent différer, tout comme l’adéquation d’un passage précis avec l’information recherchée par l’Aperçu IA.
Ces éléments peuvent donc faire partie des hypothèses expliquant pourquoi une page très bien classée n’est pas forcément citée, sans que l’on puisse pour autant leur attribuer ici un rôle causal.
Ces quatre cas ne permettent donc pas d’isoler le poids éventuel de ces différents facteurs. Ils suffisent cependant à tirer cette conclusion : être premier dans Google ne garantit pas d’être repris dans l’Aperçu IA.
Sur 863 000 SERP et quatre millions d’URL citées, 37,1 % des pages reprises figuraient dans le Top 10 organique de la requête exacte, 26,2 % entre les positions 11 et 100 et 36,7 % n’apparaissaient pas dans les 100 premiers résultats classiques ! Incroyable mais pourtant vrai.
Attention toutefois : cette comparaison porte sur la requête initiale. Une page absente de cette SERP peut notamment être mieux classée sur l’une des recherches connexes effectuées par Google via le query fan-out.
Query fan-out : plusieurs recherches derrière une seule question
Google explique que les Aperçus IA et le Mode IA peuvent lancer plusieurs recherches connexes avant de composer leur réponse. Par exemple, une question sur les prompts d’image peut ainsi être décomposée en des recherches sur la structure du prompt, le style, le cadrage ou la lumière. Ce query fan-out documenté par Google aide à comprendre pourquoi une page absente de la première SERP peut être utilisée pour un sous-thème, tandis qu’une page classée première sur la requête exacte ne l’est pas.
NB : Les sous-requêtes lancées restent toutefois invisibles pour l’utilisateur.
Structure et emplacement des Aperçus IA
Contrairement à ce qu’on pourrait penser, l’Aperçu IA ne s’affiche pas systématiquement en tête de SERP, à la place du « Featured Snippet« .
Par exemple, sur la requête « quelles sont les fautes de français les plus courantes », l’aperçu IA s’est affiché sous les 2 premiers résultats organiques et un bloc d’Autres Questions Posées. Dans cette configuration, Google conservait donc deux liens organiques visibles (dont mon blog) avant sa réponse IA générée.
Une fois déplié, l’Aperçu classait les erreurs par familles : grammaire et accords, conjugaison, puis pièges du langage. Conseils Rédaction Web était cité dans le texte, associé à un passage sur une confusion fréquente, puis présenté dans une carte parmi les sources finales.
Sur la requête « quels sont les meilleurs prompts ChatGPT pour créer des images », l’Aperçu IA s’affichait en tête de page. Déplié, il donnait une réponse très fournie, accompagnée d’une vidéo. Un panneau de huit sources s’affichait également à droite (avec mon article cité en première position).
Cette configuration ressemble davantage à la configuration par défaut.
L’aperçu IA :
prend l’intégralité de la largeur de page,
se positionne au-dessus des résultats organiques traditionnels,
propose un panneau récapitulatif des sources les plus pertinentes.
À noter que mon article apparaissait en top 1 des positions organiques classiques sur cette requête. Mais l’utilisateur doit ici traverser une réponse complète et plusieurs contenus vidéo avant d’atteindre le fameux lien bleu.
L’Aperçu IA peut occuper la première partie de la SERP et repousser visuellement le premier résultat organique
Plusieurs manières d’être cité
Ces deux exemples montrent également qu’être « cité » dans l’Aperçu IA peut recouvrir plusieurs réalités.
Une source peut à la fois être liée :
dans une phrase de la réponse (un vrai lien contextuel en somme),
ou bien signalée par une pastille à côté d’un passage,
ou encore apparaître dans le panneau de droite.
Ou les trois !
Ou aucune. Et ce, même si votre page domine historiquement la SERP sur la requête visée.
Les réponses générées par l’IA de Google ne sont pas figées non plus. Dans les mêmes conditions de recherche, mais en relançant simplement une session, j’ai observé des variations de formulation et des changements dans la manière de faire apparaître mon site.
Cette volatilité des mentions est apparue en fil rouge du protocole. Quand Conseils Rédaction Web était cité, il l’était parfois dès l’introduction, avec ou sans ancre de lien, parfois seulement rattaché à un passage ou à une « carte ».
Dans une analyse de 43 000 requêtes, Ahrefs a mesuré qu’un AI Overview change en moyenne tous les deux jours, et qu’il y a seulement 54,5 % de chevauchement moyen entre les URL citées lors de deux observations successives. Là encore, une prise de recul parlante sur la volatilité des Aperçus IA.
Un simple « comment » peut changer la SERP
Pour ce dernier test, j’ai voulu comparer l’état des résultats de recherche sur deux requêtes très proches.
En l’occurrence : « convertir un texte en markdown » à « comment convertir un texte en markdown ».
Pour la première : pas d’Aperçu IA de déclenché, Google affichait directement les liens vers les différents convertisseurs Texte Markdown, avec mon outil en position 1.
En ajoutant « comment convertir un texte en markdown », un Aperçu IA apparaissait dans ce cas au-dessus des résultats, avec une réponse qui distinguait plusieurs solutions : convertisseur en ligne, outil de conversion de fichier ou application manuelle de la syntaxe Markdown. Lors de la capture, mon site restait premier dans les résultats organiques et devenait aussi une source de la réponse.
Une SERP sans Aperçu IA pour un mot-clé donnéUne légère variation du mot-clé change l’intention perçue, et déclenche un Aperçu IA
Ce test ne prouve pas que le pronom « comment » déclenche systématiquement un Aperçu IA. Il va toutefois dans le sens d’observations réalisées à plus grande échelle. Une étude d’Ahrefs portant sur 146 millions de pages de résultats montre notamment que les requêtes formulées sous forme de questions, informationnelles et plus longues sont davantage susceptibles de déclencher un Aperçu IA.
Les formulations introduites par « comment », « pourquoi » ou « quel » peuvent donc être propices à leur apparition, non pas en raison de ces termes eux-mêmes, mais parce qu’elles traduisent fréquemment une demande d’explication ou d’information.
Lorsque vous optimisez un contenu pour les Aperçus IA
Identifiez les questions précises que les utilisateurs se posent autour du sujet. Traitez celles qui sont les plus pertinentes sur la page.
Lorsqu’une question mérite une section dédiée, formulez un intertitre explicite et apportez avant tout une réponse claire et concise, avant de la développer avec les explications, exemples ou données nécessaires.
L’objectif n’est pas de multiplier artificiellement les questions ou les FAQ, mais de proposer des passages autonomes et suffisamment complets pour répondre à chaque intention de recherche.
Aperçu IA : quel impact attendre sur le taux de clic ?
Les données américaines montrent que la profondeur des réponses fournies dans l’Aperçu IA modifie les comportements. Le Pew Research Center a étudié 68 879 recherches réalisées par 900 adultes américains en mars 2025.
Verdict : lorsqu’un résumé IA apparaissait, les utilisateurs cliquaient sur un résultat classique dans 8 % des visites, contre 15 % sans résumé. Ils ne cliquaient sur une source de l’Aperçu que dans 1 % des visites. Ce périmètre américain ne permet pas de prédire la perte de chaque site français, mais l’écart dépasse un simple changement cosmétique.
Une analyse Ahrefs publiée en février 2026 aboutit à un signal comparable avec une autre méthode. À partir de données Search Console, elle compare 150 000 requêtes informationnelles comportant un Aperçu IA à 150 000 requêtes sans Aperçu. Ahrefs estime que la présence d’une réponse générée est associée à un CTR inférieur de 58 % pour la page classée première. Il s’agit d’une estimation et non d’une baisse garantie : d’autres évolutions de Google ou des usages peuvent contribuer au résultat.
J’analysais déjà les premiers signaux de cette érosion dans mon article sur l’impact des AI Overviews sur le trafic organique. Les nouvelles observations invitent à dépasser l’opposition entre être « cité » et « ne pas l’être ». Une citation est un gain de visibilité supplémentaire, à travers un nom, un favicon ou un lien, mais ne garantit aucunement le clic. Plus l’Aperçu restitue la valeur essentielle d’une page, moins l’utilisateur a de raisons de la consulter. La question stratégique devient alors : qu’apporte encore mon contenu après la lecture de la réponse Google ?
Comment se positionner sans surinterpréter ces premiers tests ?
À ce stade, aucune recette d’optimisation ne peut être déduite de cinq pages testées. Le point de départ reste celui du guide officiel de Google : respecter les fondamentaux du SEO et s’assurer notamment que la page est indexable et éligible à l’affichage d’un extrait dans les résultats de recherche.
Google précise par ailleurs qu’aucun balisage Schema.org spécial, fichier llms.txt ou format de contenu spécifique n’est nécessaire pour apparaître dans ses fonctionnalités d’IA. Les données structurées conservent leur intérêt pour le SEO, mais ne constituent pas un prérequis propre aux Aperçus IA.
Pour optimiser pour les Aperçus IA Google, je me limiterais donc à trois repères :
Raisonner au-delà de la requête principale. Google confirme que ses Aperçus IA peuvent utiliser le query fan-out : le système lance plusieurs recherches connexes pour explorer différents aspects d’une question. Ces sous-requêtes ne sont pas accessibles, mais leur principe invite à dépasser le ciblage d’une formulation unique. Pour une intention donnée, identifiez les questions complémentaires, critères, alternatives, comparaisons ou cas particuliers nécessaires à une réponse complète.
Renforcer ce qui fait de la page une source fiable et utile. Clarifiez les passages ambigus, rendez les réponses importantes explicites, sur le fond comme dans la forme, et étayez les affirmations qui le nécessitent avec des sources, des données, des exemples ou une expertise identifiable. Cherchez surtout à apporter davantage que la reformulation d’informations déjà largement disponibles.
Préserver une valeur que l’Aperçu ne peut pas restituer entièrement. Être cité ne garantit pas le clic : l’Aperçu peut déjà satisfaire une partie du besoin informationnel. Donnez donc une raison de consulter la source avec des données originales, une méthodologie, des exemples détaillés, des retours d’expérience, des outils, des démonstrations ou des analyses propriétaires.
Google précise par ailleurs qu’il n’est pas nécessaire de fragmenter artificiellement les pages et ne fixe aucune longueur idéale. Mon ancienne analyse sur les AI Overviews et les contenus longs reste utile pour comprendre les premiers résultats américains, mais elle ne justifie pas d’allonger un article pour atteindre un volume donné.
À surveiller dans la Search Console : le rapport IA
Google déploie progressivement un rapport sur les performances dans l’IA générative, également accessible directement ici. Il montre les pages et les impressions issues des Aperçus IA et du Mode IA, mais pas encore les requêtes, les clics, le CTR ni la forme de la citation. Ces données doivent donc être complétées par l’observation manuelle des SERP.
Voici celui de Conseils Rédaction Web :
Le rapport IA génératif dans la Google Search Console
Aperçus IA : ce que je retiens de ces premiers tests
Le classement organique reste un repère utile, mais les observations présentées dans cet article et les études menées à plus grande échelle conduisent au même constat : être premier sur Google ne garantit ni la citation ni le lien dans les Aperçus IA, et encore moins le clic !
La réponse à cela n’est pas de réécrire tout son site pour l’IA. Elle consiste à suivre les SERP concernées, à comprendre ce qui est extrait et à publier des contenus qui conservent une valeur plus forte que la simple synthèse.
Les Search Agents annoncés par Google prolongeront cette logique dans le temps : certains pourront fonctionner en arrière-plan et surveiller le Web pour détecter les nouvelles informations correspondant à un besoin donné.
Le SEO restera un socle de visibilité, mais l’enjeu s’élargit : produire des sources accessibles, fiables, suffisamment originales et, lorsque le sujet l’exige, actualisées pour être découvertes et mobilisées par des systèmes qui ne se contentent plus de répondre à une requête ponctuelle.
Vous êtes comme la majorité des professionnels, et vous utilisez ChatGPT sur une base régulière ? Plusieurs fois par semaine, voire plusieurs fois par jour ?
Avec l’expérience, vous avez peut-être développé votre propre méthode. Vous avez identifié vos tâches récurrentes et structuré des « prompts maîtres », des instructions dans un GPT personnalisé, ou encore une bibliothèque bien organisée dans un Google Doc, avec une charte éditoriale et quelques exemples de bons livrables.
Bref, votre manière de bien travailler avec l’IA s’est affinée avec le temps. Par la force des choses, elle s’est sans doute aussi dispersée entre plusieurs outils et documents.
Les Skills ChatGPT peuvent dans ce cas devenir vos meilleures alliées. Cette nouvelle fonctionnalité d’OpenAI permet de formaliser une partie de votre savoir-faire pour que ChatGPT puisse le réutiliser avec agilité lorsqu’il accomplit une tâche.
J’ai récemment créé ma première Skill ChatGPT à partir d’une méthode d’optimisation éditoriale développée dans le cadre de mon activité de consultant. L’expérience m’a permis de mieux comprendre l’intérêt professionnel de cette fonctionnalité.
Je vous en parle dans cet article, et je vous explique où et comment créer votre première « Compétence ChatGPT ».
Qu’est-ce qu’une Skill (Compétence) dans ChatGPT ?
OpenAI définit une Skill (« compétence » en français dans le texte) comme un processus de travail réutilisable et partageable qui indique à ChatGPT comment accomplir une tâche spécifique. La « Skill » peut ainsi réunir des instructions, des exemples, des ressources et du code, sous quelque format que ce soit.
À noter que lesdites instructions peuvent être :
des instructions que vous lui donnez dans le chat
des instructions présentes dans les documents fournis
des instructions que ChatGPT aura inférées pour optimiser son fonctionnement lors de la création de la Skill
Une fois créée et installée, ChatGPT peut mobiliser la Skill (ou même plusieurs) lorsque l’utilisateur en a besoin, dans un espace de travail dédié appelé… « Work ».
Dans l’interface ChatGPT par défaut, vous avez désormais le choix entre l’onglet « Chat » et l’onglet « Work ».
Work dans ChatGPT, qu’est-ce que c’est ?
Work est un espace de travail qui fournit un cadre agentique pour mener une tâche complexe de bout en bout. Dans cet environnement d’exécution, les Skills sont des méthodes et des savoir-faire réutilisables et compilables avec d’autres ressources.
Quel est l’avantage des Skills dans ChatGPT ?
L’avantage d’une Skill réside dans le fait de créer une compétence réutilisable, issue de vos ressources, afin que ChatGPT puisse la mobiliser et l’appliquer dans n’importe quel contexte, au besoin, sans que vous ayez à tout réinjecter à chaque nouvelle demande.
Pour quel type de tâche les Skills sont utiles ?
OpenAI destine la fonctionnalité des Skills aux tâches dont la qualité dépend d’une approche répétable : plusieurs étapes à suivre, un format structuré, des exigences précises ou des standards métier à respecter. Elles peuvent aussi être partagées au sein d’une organisation et sont prises en charge dans Codex et dans l’API.
Les applications des Skills dépassent largement la création de contenu (même si c’est ce qui nous intéresse en premier lieu sur ce blog). Préparation de synthèses, reporting, workflows commerciaux, projets RH, développement informatique sont autant de cas d’usage possibles.
Dit autrement : dès qu’une méthode de travail peut être formalisée, elle peut potentiellement donner lieu à une Skill.
Les Skills reposent sur un standard ouvert
Les Skills ne sont pas limitées à l’écosystème OpenAI. Le concept existe notamment chez Anthropic avec les Agent Skills de Claude. Anthropic a publié Agent Skills comme standard ouvert, et OpenAI indique que ses propres Skills suivent ce standard. Celui-ci s’appuie sur un fichier central SKILL.md, auquel peuvent s’ajouter des scripts, de la documentation ou d’autres ressources.
OpenAI précise qu’une Skill conforme peut être téléchargée depuis un produit et installée dans un autre. Le savoir-faire formalisé dans une Skill peut donc devenir portable entre différents environnements compatibles, même si les capacités et les modalités d’exécution peuvent varier selon les plateformes.
Pourquoi créer une Skill quand on utilise déjà beaucoup ChatGPT ? Un exemple
Pour un utilisateur régulier, l’intérêt principal de cette nouvelle fonctionnalité est de capitaliser sur une méthode de travail déjà construite.
Dans mon cas, j’avais un exemple parfait à disposition, à travers une mission d’optimisation éditoriale. Elle reposait sur plusieurs ressources, dispersées mais complémentaires :
un GPT personnalisé et ses instructions ;
un Google Doc méthodologique approfondi ;
des prompts complémentaires de pilotage ;
des exemples de contenus déjà optimisés.
Selon la mission, je pouvais avoir besoin de retrouver une ressource, de transmettre à nouveau certaines règles ou de reconstruire suffisamment de contexte pour obtenir le comportement attendu.
La Skill m’a rendu cette méthode disponible plus facilement.
Très important : elle a aussi défini automatiquement comment utiliser les ressources en question :
quelle procédure suivre,
quelles règles mobiliser selon la situation,
et jusqu’où le modèle peut agir de manière autonome.
C’est là que se situe une partie de sa valeur ajoutée, et qui la dissocie d’un Custom GPT classique par exemple. En comprenant le contexte de votre savoir-faire, la Compétence construite formalise des règles de comportement robustes, pour arriver au livrable le plus satisfaisant possible.
Dans ma Skill, par exemple, ChatGPT doit sélectionner les consignes pertinentes, préparer son plan de travail, détecter certaines opportunités d’optimisation SEO et conduire la tâche jusqu’au livrable.
Il peut aussi se concentrer sur une partie spécifique du travail d’optimisation. Dès lors que la consigne est formalisée dans la Compétence, il pourra l’utiliser de manière très fiable, sans risque d’amalgame avec les autres consignes des ressources mobilisées.
Par exemple, l’amélioration des informations éditoriales à des fins de « chunking » destiné aux LLM, fait partie de mon process d’optimisation. Sans entrer dans le détail des consignes, ChatGPT doit respecter un ensemble de règles qui l’aident à identifier les informations suffisamment fortes ou uniques dans le contenu travaillé, pour les transformer en des unités de réponse plus autonomes.
Dès que je le sollicite sur ce point, il va en toute autonomie rechercher les éléments structurants et les appliquer au contenu. Je peux ainsi demander une optimisation sans identifier moi-même chaque règle à appliquer ou chaque passage candidat.
Skill, Projet, GPT personnalisé : quelle différence ?
OpenAI a tendance à multiplier les fonctionnalités dans ChatGPT, au point qu’il devient parfois difficile de comprendre leurs différences et de savoir laquelle utiliser. D’autant que certaines se chevauchent en partie. C’est le cas des Skills, des Projets et des GPT personnalisés par exemple.
Leur usage principal reste toutefois différent.
Outil ChatGPT
Usage principal
Prompt
Formuler une demande ponctuelle
Projet
Conserver le contexte, les fichiers et les conversations liés à un travail dans la durée
Créer une version de ChatGPT configurée autour d’un objectif spécifique
Skill
Faire appliquer une méthode ou un workflow réutilisable avec ses instructions et ressources
OpenAI présente ainsi les Projets comme un moyen de travailler avec un contexte commun entre plusieurs conversations, tandis que les Skills transforment des tâches récurrentes en workflows réutilisables.
Un Projet peut donc centraliser le contexte d’un client. Une Skill peut formaliser une méthode de travail applicable dans ce projet, mais aussi ailleurs lorsqu’elle reste pertinente.
Comment créer une Skill dans ChatGPT ?
Le chemin le plus simple pour créer votre première Skill ChatGPT, est de passer par le mode Work et de prompter une demande très simple :
« Aide-moi à créer une compétence. »
ChatGPT vous aide alors à cadrer le besoin avec ce type de questions :
Avant de créer votre Skill
1. Quelle tâche doit-elle savoir accomplir ? 2. Quelle demande allez-vous typiquement lui adresser ? 3. Quelles ressources doit-elle pouvoir utiliser ? 4. Jusqu’où peut-elle agir sans votre validation ?
Il est également possible de créer et gérer une Skill depuis l’interface dédiée. OpenAI permet notamment de créer une Skill avec le chat, avec l’éditeur ou en important une Skill existante depuis son ordinateur.
Une fois créée, votre nouvelle Skill est facilement retrouvable en utilisant le « + » en bas à gauche du champ de prompting, ou en l’appelant à l’aide du signe « @ » (veillez à bien être dans l’onglet « Work », sinon, vous ne la retrouverez pas).
Que peut-on mettre dans une Skill ?
Une Skill peut contenir ses instructions de fonctionnement et s’appuyer sur des ressources comme des prompts, des procédures détaillées, des règles métier, des templates, des exemples ou n’importe quel document de référence.
Pour préparer la vôtre, commencez par inventorier ce que vous utilisez déjà.
Vos prompts existants. Prompts maîtres, séquences récurrentes, instructions d’un ancien GPT personnalisé.
Vos méthodes. Workflows, checklists, processus et critères de décision.
Vos règles métier. Charte éditoriale, exigences client, standards de qualité ou formats attendus.
Vos exemples. Livrables réussis, templates, cas représentatifs.
Vos retours d’expérience. Les corrections que vous apportez régulièrement à ChatGPT et les comportements que vous avez appris à mieux cadrer.
Il n’est pas indispensable de transformer préalablement cet ensemble en une documentation parfaitement homogène. Dans mon cas, j’ai fourni des ressources de nature différente. ChatGPT les a ensuite organisées dans la Skill.
À quoi ressemble l’intérieur d’une Skill ?
Quand on demande à ChatGPT de créer ou modifier une Skill, il utilise automatiquement une Skill système appelée skill-creator pour la générer, la mettre à jour ou la dépanner.
Une fois créée, chaque Skill s’appuie sur un fichier central appelé SKILL.md.
Ce fichier porte les instructions du workflow et peut renvoyer vers des ressources complémentaires utilisées selon les besoins. C’est également le principe décrit par le standard Agent Skills.
Dans mon cas, ChatGPT a créé une architecture en plusieurs couches, que je détaille juste en-dessous.
NB : ce travail d’ingénierie de la Compétence est automatiquement fait par ChatGPT. Vous n’avez rien d’autre à faire que de préparer vos ressources et de les lui fournir en amont de la création.
SKILL.md : l’orchestration générale
Le fichier central définit la mission de la compétence et organise les différentes sources de savoir-faire.
Il articule plusieurs couches issues de mon ancien système de travail, fixe leur ordre de priorité et indique quels sous-fichiers consulter selon la tâche. Il définit également noir sur blanc le degré d’autonomie attendu. Voici un court extrait du fichier SKILL.md ci-dessous.
core-workflow.md : la méthode opérationnelle
Ce fichier décrit le processus complet : collecte des informations, cadrage, audit, programmation des interventions, optimisation et fact-checking.
Il prévoit aussi deux modes. Le mode autonome exécute la méthode jusqu’au livrable ; le mode accompagné permet de reprendre le contrôle étape par étape.
regimes.md : l’adaptation à différentes missions
La Skill adapte son niveau d’intervention au type de travail demandé : optimisation éditoriale, page e-commerce, migration ou audit, par exemple.
Les mêmes règles ne sont donc pas appliquées mécaniquement à chaque situation.
quality-rules.md : les standards transversaux
Un autre fichier centralise les exigences qui doivent encadrer le travail : qualité rédactionnelle, précision des informations, fact-checking, SEO, optimisation GEO ou contrôle final.
Les règles GEO prévoient par exemple de structurer certaines informations en unités autonomes, mais sans imposer ce format partout.
implementation-patterns.md : apprendre à partir d’exemples
Enfin, la Skill dispose d’exemples de contenus déjà optimisés.
Ils servent à reconnaître les effets recherchés — hiérarchie de l’information, réponses directes, expertise, preuve — avec une consigne explicite : ne pas les copier comme des gabarits obligatoires.
Cette arborescence n’est pas imposée à toutes les Skills. L’organisation des ressources dépend de la tâche et du savoir-faire à formaliser.
Comment utiliser une Skill dans un travail réel ?
Une fois installée, une Skill peut être sélectionnée explicitement dans une conversation « Work ». ChatGPT peut également utiliser automatiquement une ou plusieurs Skills lorsqu’elles sont jugées utiles.
Le cas échéant, la Skill apparaît parmi les sources disponibles pour le travail en cours. Ledit travail vous permet donc également de mobiliser d’autres ressources pour avancer sur votre tâche.
La Skill vient ainsi apporter sa méthode et ses règles à un environnement de travail bien plus large. C’est toute la puissance de cette fonctionnalité !
Work permet également de choisir le modèle mobilisé pour réaliser la tâche. Les nouveaux modèles GPT-5.6 (Luna, Terra et Sol) proposent différents niveaux de capacité et d’effort de raisonnement.
Pour les travaux les plus complexes, cette articulation prend tout son sens : la Skill apporte la méthode et les règles à suivre, tandis que le modèle fournit les capacités de raisonnement nécessaires pour les mobiliser avec discernement au fil de la tâche.
Dans l’exemple ci-dessous, le panneau latéral de Work permet de suivre la progression de la tâche, de retrouver les sources consultées en ligne et les livrables produits, tout en visualisant l’utilisation du navigateur cloud (nécessaire à ce moment précis de la tâche).
La tâche est très complexe, et pourtant le suivi reste accessible, clair et contrôlable.
En résumé, l’articulation dans ChatGPT se veut assez bien pensée :
la Skillapporte un savoir-faire puissant, structuré et réutilisable
Work fournit l’environnement dans lequel ChatGPT peut mobiliser ce savoir-faire avec les autres ressources et capacités nécessaires à la tâche.
Retour d’expérience
Dans mes premiers tests, j’ai ainsi sollicité la même compétence sur plusieurs dimensions d’un travail : optimisation globale, intervention ciblée ou vérification d’une règle particulière. ChatGPT a toujours commencé par contrôler le contenu de la Skill pour y trouver les instructions correspondantes et se mettre sur les rails attendus d’exécution.
Pour commencer avec les Skills de ChatGPT
Identifiez une tâche que vous réalisez régulièrement avec ChatGPT, sur laquelle vous avez assez de maturité dans la collaboration.
Rassemblez les méthodes, prompts et ressources que vous utilisez déjà. Dans la mesure du possible, prenez le temps de les formaliser clairement et de combler les zones de flou. Sinon, ChatGPT risque de les interpréter ou de les compléter à votre place.
Définissez le résultat attendu et le niveau d’autonomie souhaité.
Demandez directement à ChatGPT, dans une conversation « Work », de créer une Skill. ChatGPT pose alors des questions complémentaires et propose ensuite de l’installer.
Le générateur d’images de ChatGPT n’arrête pas d’évoluer. Dans l’interface, le changement le plus perceptible concerne à présent la vitesse de génération, portées par la nouvelle évolution ChatGPT Images 2.5.
Mais attention, les possibilités créatives offertes par ChatGPT Images 2.0 restent néanmoins d’actualité : les 32 exemples et les prompts présentés dans cet article peuvent toujours être utilisés avec le modèle le plus récent.
Le socle reste le même : générer du texte lisible, suivre des mises en page complexes et préserver une cohérence visuelle entre plusieurs images ou variantes. Ces capacités permettent de créer des supports visuels de qualité : couvertures de magazines, des catalogues, des infographies, des planches de bande dessinée ou encore des scènes narratives.
Cette sélection réunit d’abord les principales tendances d’images IA qui circulent sur les réseaux sociaux et dans les communautés de créateurs. Elle propose ensuite des prompts plus ambitieux pour tester les capacités de composition du générateur.
💡 Si vous cherchez moins l’inspiration que des applications directement exploitables dans un cadre professionnel, j’ai également testé neuf idées de visuels et leurs prompts dans ChatGPT : infographie, support commercial, retouche photo, adaptation linguistique, miniature YouTube ou encore visualisation de stand professionnel.
Toutes les idées de visuels IA à consulter dans le carrousel ci-dessous
Pas le temps de parcourir l’article tout de suite ? Faites défiler le carrousel ci-dessous pour découvrir les 32 tendances de génération d’images IA à tester avec ChatGPT Images 2.0. Si l’une d’elles vous inspire, poursuivez votre lecture : chaque idée est accompagnée d’explications, d’exemples et d’un prompt prêt à l’emploi à copier.
01La rencontre de son soi enfant
01 / 32
Les 9 tendances de visuels IA qui font actuellement parler d’elles
1. La rencontre de son soi enfant
L’une des tendances IA les plus émouvantes du moment consiste à faire dialoguer son « moi » adulte avec son « moi » enfant à partir de deux photos. Popularisé sur Instagram avant d’être largement relayé sur les réseaux sociaux, ce montage est rendu crédible par les progrès des nouveaux modèles dans la cohérence des visages, des expressions et de la mise en scène.
Il suffit de fournir une photo de vous enfant et une photo actuelle : ChatGPT Images 2.0 recompose automatiquement une scène cohérente, même si les clichés d’origine sont très différents.
Voir le prompt utilisé
Using the two uploaded images, create a black-and-white portrait.

On the left, place the childhood version facing right.
On the right, place the adult version facing left.

They are sitting across from each other at a small table with a birthday cake in the middle showing the current age.

The image should feel emotional, realistic and cinematic, with soft studio lighting and natural facial expressions.

Do not make the scene fantastical.
Keep both faces recognizable and photorealistic.
(Merci ChatGPT, mais je n’ai plus 32 ans depuis longtemps…)
2. Le dessin « Paint » volontairement raté
À contre-courant des images IA ultra-réalistes, cette tendance consiste à transformer une photo en un dessin volontairement maladroit, commes’il était réalisé sous Microsoft Paint avec une souris. Popularisée sur Threads puis rapidement reprise sur X et Instagram, elle séduit par son humour et son côté nostalgique, en détournant les prouesses techniques des nouveaux modèles pour produire un résultat… volontairement imparfait.
Voir le prompt utilisé
Remake this image as an inexpert, childish doodle scribbled on MS Paint using a mouse alone.
3. La caricature psychologique personnalisée
Cette tendance est apparue avec les nouvelles fonctionnalités de mémoire de ChatGPT. Elle consiste à demander à l’IA de résumer votre personnalité sous la forme d’une caricature, en s’appuyant sur vos conversations passées. Rapidement devenue virale, elle a été largement partagée sur les réseaux sociaux, les utilisateurs découvrant avec amusement – ou parfois inquiétude – la façon dont ChatGPT les perçoit.
Voir le prompt utilisé
Create a caricature of me and my job based on everything you know about me.

Fill the scene with objects, tools, projects, recurring topics, hobbies, goals, achievements and personality traits that represent me.

Make the caricature humorous but accurate. Include meaningful visual references connected to my work and interests.

Highly detailed illustration, colorful editorial caricature style, professional quality.
4. Le scrapbook narratif
Inspirée de l’esthétique scrapbook popularisée par Pinterest, cette tendance consiste à transformer une ou plusieurs photos en un collage mêlant polaroids, tickets, annotations manuscrites, autocollants et souvenirs de voyage. Les nouveaux modèles excellent dans cet exercice, capables de composer des images complexes tout en intégrant du texte et de nombreux éléments graphiques de façon crédible.
Voir le prompt utilisé
Transform the uploaded photo into a nostalgic scrapbook-style collage.

Preserve my face, hairstyle and expression accurately.

Create a handcrafted memory page using:
- overlapping Polaroid photos
- torn paper textures
- washi tape
- handwritten notes
- travel tickets
- postage stamps
- pressed flowers
- cute stickers
- small doodles
- date labels

Use warm vintage colors, soft film grain and realistic paper textures.

The page should look like a real scrapbook assembled by hand, with a balanced composition and dozens of small details to discover.

High-end editorial quality.
5. La couverture de magazine
Les fausses couvertures de magazines figurent parmi les usages les plus populaires des nouveaux modèles de génération d’images. Grâce à leurs progrès en mise en page et en rendu du texte, il est désormais possible de créer des unes d’un réalisme saisissant, avec des titres, accroches et éléments graphiques parfaitement lisibles. Une simple photo suffit pour se glisser dans la peau d’une personnalité faisant la couverture d’un magazine.
Voir le prompt utilisé
Turn the uploaded portrait into the cover of a premium business and technology magazine called "AI INSIDER".

Create a realistic editorial cover with:

- a bold, modern masthead
- a main cover story featuring me
- six short, believable cover headlines related to AI, innovation and digital marketing
- a barcode
- issue date
- price
- premium magazine typography
- professional editorial layout

Use dramatic studio lighting, realistic skin tones and a confident pose.

The cover should be indistinguishable from a real magazine sold in a bookstore.

Avoid gibberish text. Every headline must be readable, coherent and professionally written.
6. Le portrait qui traverse le temps
L’une des grandes avancées des nouveaux modèles réside dans leur capacité à maintenir une cohérence visuelle entre plusieurs images. Ils peuvent désormais faire évoluer un même sujet au fil du temps, sous différents angles ou dans des contextes variés, sans perdre les éléments qui le rendent immédiatement identifiable.
Voir le prompt utilisé
Using the uploaded front-facing portrait as the identity reference, create a premium five-panel chronological portrait showing the same person at different stages of life.

The five portraits should represent:

1. 5 years old
2. 15 years old
3. 30 years old
4. 40 years old
5. 70 years old

Important requirements:

- Preserve the person's facial identity consistently across all five ages.
- Keep recognizable facial structure, eyes, nose, smile and overall personality.
- Adapt hairstyle, skin texture, facial proportions and age-related details naturally for each stage of life.
- Use the same camera angle, framing and neutral background for every portrait.
- Keep identical lighting and photographic style across the five images.
- Show subtle evolution rather than exaggerated aging.
- Avoid caricature, excessive wrinkles or unrealistic age transformations.
- Keep the same facial expression with only subtle emotional maturity changes across the five portraits

Arrange the five portraits side by side in chronological order with elegant labels:
"5 years", "15 years", "30 years", "40 years", "70 years".

The final result should resemble a premium editorial feature illustrating the evolution of the same person through life, with highly realistic photography and perfect identity consistency.
7. Le même paysage à différentes heures de la journée
Cette capacité de cohérence du sujet ne s’applique pas uniquement aux personnages. Les nouveaux modèles savent également conserver la composition, les objets et l’ambiance générale d’une scène tout en faisant évoluer un seul paramètre, comme la lumière, la météo ou la saison. L’exemple ci-dessous, que je trouve encore plus convaincant que le précédent, illustre cette continuité visuelle à travers trois moments clés d’une même journée.
Voir le prompt utilisé
Create a premium three-panel editorial composition showing the exact same Italian village square at three different moments of the same day.

The three panels should represent:

1. Sunrise
2. Golden hour (late afternoon)
3. Blue hour (just after sunset)

Important requirements:

- The viewpoint must remain absolutely identical in all three panels.
- Every building, window, café terrace, fountain, tree and street element must remain in exactly the same position.
- Keep the same people, bicycles, tables and objects, allowing only natural changes in posture or activity.
- The only significant evolution should come from the passage of time:
  - lighting
  - shadows
  - sky colors
  - atmosphere
  - shop lights
  - human activity

The progression should feel completely natural, as if the same camera had remained fixed throughout the day.

Arrange the three images side by side with elegant captions:

Sunrise
Golden Hour
Blue Hour

Ultra-realistic editorial photography, natural colors, subtle cinematic atmosphere, perfect visual continuity between all three panels.
8. Le voyage temporel photographique
Les nouveaux modèles excellent dans la reconstitution de photographies d’époque. À partir d’un simple portrait, ils peuvent recréer une scène crédible en adaptant les vêtements, la coiffure, les couleurs, le grain de la pellicule et même l’environnement pour donner l’illusion d’un véritable cliché ancien. Le résultat va bien au-delà d’un simple filtre vintage et plonge le sujet dans une autre époque.
Voir le prompt utilisé
Transform the uploaded photo into an authentic photograph taken in Paris in 1978.

Keep my face clearly recognizable while adapting my hairstyle, clothing and accessories to the late 1970s.

Use the visual characteristics of a real 35mm analog camera:
- subtle film grain
- slightly faded colors
- realistic lighting
- soft contrast
- minor lens imperfections
- tiny dust particles
- authentic photographic texture

Avoid modern objects, logos, clothing or architecture.

The final image should look like a genuine photograph discovered in a family photo album from 1978, not a modern AI illustration.
Le cœur du prompt se situe ici : « transform this photo into a photo taken in… ». J’y ajoute trois optimisations inspirées des retours des utilisateurs sur les réseaux sociaux :
Préciser le type d’appareil (« 35mm analog camera ») améliore nettement le rendu photographique.
Interdire explicitement les éléments modernes évite les anachronismes qui cassent l’illusion.
Comparer le résultat à une photo retrouvée dans un album de famille pousse ChatGPT à produire une image moins « cinématique » et plus crédible.
9. L’esthétique photo imparfaite
À contre-courant des images ultra-lisses générées par l’IA, cette tendance revendique l’imperfection. Inspirée des appareils jetables et des pellicules des années 1990-2000, elle reproduit les défauts qui donnent du caractère à une photographie : flash frontal, grain, couleurs délavées, flou léger ou cadrage approximatif. Les nouveaux modèles excellent désormais à recréer ces imperfections, pour un rendu qui évoque davantage un véritable souvenir qu’une image artificielle.
Voir le prompt utilisé
Turn the uploaded photo into a faded late-90s disposable camera memory.

Keep the person recognizable, but make the image feel spontaneous, imperfect and unplanned.

Add:
- visible dusty film grain
- slight motion blur
- harsh direct flash
- warm oversaturated colors
- uneven lighting
- tiny scratches
- subtle light leak in one corner
- imperfect off-center framing

Make it look like a real photo found years later in an old shoebox, not a polished AI image.

No glossy retouching, no perfect skin, no cinematic color grading.
Vous cherchez des idées de visuels qui attirent immédiatement l’attention ? Retrouvez une sélection de 10 prompts prêts à l’emploi pour créer des images percutantes avec ChatGPT Images, inspirées des tendances qui fonctionnent le mieux sur les réseaux sociaux.
Les nouvelles capacités de ChatGPT Images 2.0 ouvrent la voie à des visuels inédits
Ces tendances ne sont que la partie visible de l’iceberg. Les derniers modèles de text-to-image excellent désormais dans la génération d’images qui intègrent du texte, ou respectent une mise en page ou une narration particulière.
La fiche personnage (Character Sheet)
Très populaire chez les illustrateurs, auteurs et créateurs de jeux vidéo, la character sheet s’impose avec les nouveaux modèles de génération d’images. L’objectif n’est plus de produire un simple portrait, mais une véritable fiche de référence regroupant poses, expressions et accessoires. Le prompt ci-dessous compile les éléments les plus fréquents des tutoriels consacrés à cette nouvelle capacité de ChatGPT Images.
Il n’existe pas de prompt viral unique. En revanche, les formulations partagées reprennent presque toujours les mêmes éléments :
une vue de face du personnage ;
plusieurs expressions faciales ;
plusieurs poses ;
les tenues et accessoires ;
une palette de couleurs ;
des annotations ou fiches descriptives.
Voir le prompt utilisé
Create a professional character reference sheet for the person in the uploaded photo.

Include:
- a full-body front view
- a full-body back view
- six facial expressions
- three dynamic poses
- the character's signature outfit and accessories
- a color palette
- small annotated callouts describing key visual traits

Use a clean, professional character sheet layout on a white background, similar to those used in animation and video game studios.
Le moodboard professionnel
Longtemps réservé aux agences de création, le moodboard devient accessible en quelques secondes grâce à ChatGPT Images. Designers, marketeurs et architectes l’utilisent pour explorer rapidement une direction graphique avant de lancer un projet. Cette tendance s’appuie sur la capacité des nouveaux modèles à composer une planche cohérente mêlant références visuelles, couleurs, matières et annotations, comme dans un véritable brief créatif.
Il n’existe pas de prompt « viral » prêt à l’emploi. Les différentes sources convergent toutefois vers une structure commune :
définir un projet ;
préciser l’ambiance recherchée ;
demander une véritable planche de présentation ;
mélanger références visuelles, couleurs, matériaux, typographie et annotations.
Voir le prompt utilisé
Create a professional mood board for a premium AI and digital marketing brand.

Include:
- inspiring photography
- typography samples
- a curated color palette
- textures and materials
- UI inspiration
- logo directions
- keywords describing the brand personality
- layout annotations

Arrange everything on a clean creative presentation board, similar to what a branding agency would present to a client.
L’infographie générée par IA
La génération d’infographies est devenue l’un des cas d’usage phares de ChatGPT Images. Grâce à ses progrès en mise en page et en rendu du texte, l’IA peut désormais produire des schémas lisibles en une seule génération. Ce format séduit particulièrement les créateurs de contenu, qui l’utilisent pour illustrer des articles, des présentations ou des publications LinkedIn sans passer par un logiciel de design.
NB : Ce n’est pas une tendance virale sur les réseaux au sens du Starter Pack. C’est un nouvel usage qui a émergé avec GPT Image 2 grâce à un progrès majeur : la génération de texte enfin lisible dans les images.
Voir le prompt utilisé
Create a clean, modern vertical infographic explaining "How Large Language Models Work".

Include:
- a clear title
- five numbered sections
- simple flat illustrations and icons
- short, readable text for each section
- a consistent blue and white color palette
- clear visual hierarchy
- a professional editorial layout

The infographic should be easy to read at a glance and suitable for publication in a blog article.
La planche de bande dessinée
Les planches de BD comptent parmi les démonstrations les plus impressionnantes de ChatGPT Images. Les nouveaux modèles savent désormais raconter une histoire complète en plusieurs cases, tout en conservant les mêmes personnages, décors et dialogues. Une capacité qui ouvre la voie à la création de storyboards, de mangas ou de bandes dessinées sans maîtriser le dessin.
Pour un résultat convaincant, décrivez le scénario case par case afin de guider précisément la progression de l’histoire
Voir le prompt utilisé
Create a one-page comic telling the story of a medieval knight who accidentally discovers a laptop powered by artificial intelligence.

The story should have a clear narrative arc across six comic panels:
1. The knight discovers a mysterious glowing object.
2. He cautiously opens the laptop.
3. The AI starts answering his questions.
4. The knight uses the AI to improve his battle strategy.
5. He easily defeats a dragon thanks to the AI's advice.
6. Back at the castle, he is celebrated as a legendary hero while secretly thanking his magical laptop.

Keep the same characters throughout all six panels.

Include expressive facial expressions, dynamic action, readable speech bubbles and a satisfying ending.

Use a colorful Franco-Belgian comic style with clean line art and a professional comic page layout.
19 concepts visuels qui exploitent tout le potentiel de ChatGPT Images
Le CV LinkedIn d’un personnage historique
Transformer un personnage historique en candidat du XXIᵉ siècle est un excellent moyen d’exploiter les capacités de mise en page et de génération de texte de ChatGPT Images. Plus le personnage est connu, plus le décalage est amusant.
Voir le prompt utilisé
Create a realistic LinkedIn profile page for Napoleon Bonaparte as if he were applying for executive positions in 2026.

The profile should include:
- a professional profile photo
- a compelling headline
- an "About" section
- work experience
- education
- featured achievements
- top skills
- endorsements
- recommendations
- certifications
- a realistic LinkedIn interface

Keep the tone humorous but believable, with references to Napoleon's real historical achievements adapted to modern corporate language.

The result should be indistinguishable from a genuine LinkedIn profile.
Le catalogue IKEA d’un univers fictif
Les catalogues IKEA reposent sur des codes graphiques immédiatement reconnaissables. Les détourner vers un univers imaginaire permet d’obtenir un visuel riche, crédible et souvent très drôle.
Voir le prompt utilisé
Create a realistic IKEA catalogue page featuring furniture designed for dragons.

Include:
- a genuine IKEA-style page layout
- 6 original pieces of furniture with Swedish product names
- product photos in authentic IKEA studio style
- short product descriptions
- dimensions
- prices
- assembly difficulty icons
- small lifestyle photos showing dragons using the furniture

Use IKEA's clean Scandinavian graphic design, realistic typography and authentic catalogue styling.

The page should look exactly like an official IKEA catalogue.
Le même sujet décliné dans plusieurs styles artistiques
Les nouveaux modèles excellent dans la reproduction de langages visuels complexes. En demandant plusieurs interprétations d’un même sujet, vous mesurez instantanément l’influence du style sur la perception d’une image.
Voir le prompt utilisé
Create a gallery of nine interpretations of the same Parisian café.

Each version must depict the exact same composition, viewpoint and subject, but in a completely different artistic style.

Include:
- Art Nouveau
- Bauhaus
- Impressionism
- Cubism
- Japanese Ukiyo-e
- Pop Art
- Art Deco
- Minimalism
- Vaporwave

Arrange the nine images in a clean 3×3 grid with a small title beneath each style.

Each interpretation should faithfully reproduce the visual language, color palette, composition principles and materials characteristic of its artistic movement.
Un objet revisité par plusieurs designers célèbres
Les nouveaux modèles savent aussi s’inspirer des codes esthétiques propres aux grands designers. En confrontant plusieurs visions d’un même objet, vous obtenez une véritable leçon de design… générée en une seule image.
Voir le prompt utilisé
Create a premium design presentation showing the same espresso machine reimagined by eight legendary designers.

Present each version in its own panel with the designer's name.

Include interpretations inspired by:
- Dieter Rams
- Philippe Starck
- Charles & Ray Eames
- Ettore Sottsass
- Naoto Fukasawa
- Patricia Urquiola
- Marc Newson
- Jonathan Ive

Keep the product's function identical in every version while radically changing its design language, materials, proportions and details according to each designer's philosophy.

Arrange the concepts in a clean exhibition board with studio lighting, neutral backgrounds and elegant typography.

The result should look like a concept presentation prepared for a major international design exhibition.
Le guide touristique d’un monde imaginaire
Les guides de voyage possèdent des codes éditoriaux très forts. Les détourner vers un univers fictif permet de créer un document immédiatement crédible, tout en laissant libre cours à l’imagination.
Voir le prompt utilisé
Create a realistic travel guide double-page spread for the lost city of Atlantis.

Include:
- a stunning cover illustration of Atlantis
- a detailed tourist map
- "Top 10 attractions"
- local food recommendations
- practical travel tips
- a "Best time to visit" section
- a small cultural etiquette guide
- beautiful editorial photography
- captions and short articles

Use the graphic design, typography and layout of a premium Lonely Planet travel guide.

The guide should look authentic, professionally published and entirely dedicated to Atlantis as if it were a real travel destination.
Le manuel utilisateur d’un animal
Et si votre animal était livré avec une notice officielle ? Ce détournement fonctionne particulièrement bien avec ChatGPT Images, qui reproduit fidèlement les codes des manuels techniques tout en laissant place à un humour subtil. « Thank you for choosing your new companion ».
Voir le prompt utilisé
Create a realistic user manual for a domestic cat as if it were a consumer electronic product.

Include:
- a professional front cover
- a product overview
- labeled diagrams of the cat
- setup instructions
- operating modes
- maintenance recommendations
- troubleshooting guide
- safety warnings
- technical specifications
- warranty information
- simple instructional illustrations and icons

Use the clean graphic design and layout of an official user manual from a major electronics manufacturer.

The document should look completely authentic while humorously describing real cat behavior.
Un faux journal télévisé
Les nouveaux modèles excellent désormais dans la reproduction d’interfaces complexes. Transformer un événement totalement improbable en édition spéciale d’un JT donne un résultat très crédible et immédiatement partageable.
Voir le prompt utilisé
Create a realistic breaking news television broadcast announcing that dragons have officially been discovered living in the Alps.

Include:
- a modern TV news studio
- a professional news anchor
- a large "BREAKING NEWS" banner
- a live report window showing dragons flying over snowy mountains
- a scrolling news ticker
- a weather sidebar
- a location tag
- a network logo
- readable lower-third captions
- realistic broadcast graphics

Use the visual identity of a premium international news channel without copying any existing TV network.

The result should look exactly like a genuine live television news broadcast reporting an extraordinary event.
Une vitrine de musée
Les nouveaux modèles reproduisent avec une grande fidélité les codes des expositions muséales. En mettant en scène des objets du quotidien comme de véritables pièces historiques, vous obtenez un visuel élégant, crédible et riche en détails. Plus le thème est familier, plus le décalage fonctionne.
Voir le prompt utilisé
Create a premium museum display case dedicated to the evolution of mobile phones from 1983 to 2025.

Include:
- authentic-looking historical mobile phones displayed chronologically
- museum-style glass display cases
- elegant object labels
- descriptive information panels
- a timeline
- subtle lighting designed for exhibitions
- visitors observing the display
- a refined contemporary museum interior

Use the visual style of a world-class technology museum, with realistic typography, professional exhibition design and highly detailed product presentation.

The final image should look like a genuine museum exhibition celebrating the history of mobile communication.
Un portrait à travers les reflets
Plutôt qu’un portrait classique, ici le personnage n’apparaît jamais directement. On le découvre uniquement à travers les reflets des vitrines, des flaques d’eau, des miroirs, des lunettes ou des objets métalliques. C’est un exercice de composition très fort qui souligne les capacités intrinséques impressionnantes de ChatGPT, et produit souvent des images sophistiquées.
Voir le prompt utilisé
Create a cinematic portrait of a woman walking through Tokyo at sunset.

Never show her face directly.

Reveal her only through reflections in shop windows, puddles, mirrors, polished metal surfaces, passing taxi windows and illuminated signs.

Each reflection should reveal a different angle while remaining perfectly consistent. Perfectly consistent ! Make sure you don't mistakenly create clothes, accessories, or light incoherences.

Use a moody cinematic atmosphere with rain, neon lights and subtle storytelling.

The final image should feel like a frame from an award-winning film.
Le plan éclaté d’un objet impossible
Les plans éclatés mettent particulièrement en valeur la précision des nouveaux modèles. En reproduisant les codes des dossiers d’ingénierie (annotations, repères, nomenclature, vues techniques), ChatGPT Images peut transformer un concept fictif en invention parfaitement crédible.
Voir le prompt utilisé
Create a highly detailed exploded technical diagram of a time machine, as if it were designed by a world-class engineering company.

Show every component separated and precisely aligned in an exploded view.

Include:
- numbered callouts for each part
- technical labels
- cross-sectional details
- internal mechanisms
- power source
- cooling system
- control interface
- material specifications
- assembly notes
- engineering scale references

Use the visual style of a professional engineering blueprint mixed with a premium product design presentation.

The illustration should look like a real technical document created by aerospace engineers, with clean typography, precise linework and highly realistic mechanical details.
Une boîte de jeu de société fictive
Les nouveaux modèles excellent dans la création d’objets complexes mêlant illustration, mise en page et texte. En imaginant un jeu de société complet, vous obtenez un visuel riche qui donne presque envie de l’acheter. Pensez à décrire précisément les éléments du jeu (boîte, plateau, cartes, pions…) pour renforcer l’illusion.
Voir le prompt utilisé
Create a premium board game called "Startup Simulator".

Design a complete retail board game presentation including:

- the game box (front and back)
- an unfolded game board
- playing cards
- player tokens
- dice
- game currency
- a concise rulebook
- the box contents neatly displayed

The game should simulate the life of a startup founder, with humorous challenges, funding rounds, product launches, investor meetings and unexpected crises.

Use modern, premium graphic design with professional typography and realistic product photography.

The final image should look like an official product presentation from a major board game publisher, suitable for sale in a retail store.
La carte d’un lieu réel… comme on ne l’a jamais vu
Les IA excellent désormais dans les vues en coupe, les cartes annotées et les illustrations riches en détails. En dévoilant les parties habituellement invisibles d’un lieu emblématique, vous obtenez un visuel à la fois pédagogique et fascinant. Choisissez un lieu connu du grand public pour renforcer l’effet de surprise.
Voir le prompt utilisé
Create an ultra-detailed cutaway map revealing the hidden infrastructure beneath the Eiffel Tower.

Show both the visible monument and everything normally hidden underground, including:
- maintenance tunnels
- technical rooms
- elevator machinery
- electrical systems
- foundations
- emergency access routes
- storage areas
- engineering equipment

Include clear labels, a legend, subtle annotations and a refined architectural illustration style.

The composition should resemble a premium educational infographic published by National Geographic or a leading architecture magazine, combining technical accuracy with beautiful visual storytelling.
Une scène « Behind the scenes » d’un événement historique
Les nouveaux modèles excellent dans les scènes riches en personnages et en détails. En imaginant les coulisses d’un événement historique, vous obtenez un visuel surprenant qui détourne notre regard habituel sur l’Histoire. Choisissez un événement universellement connu afin que le contraste fonctionne immédiatement.
Voir le prompt utilisé
Create a highly realistic behind-the-scenes photograph of the construction of the Eiffel Tower in 1888, as if a modern documentary crew had been allowed backstage.

Show the workers taking a lunch break, engineers studying blueprints, photographers preparing equipment, cranes in action, stacks of steel beams, and workers chatting between shifts.

The atmosphere should feel authentic, candid and documentary-like, revealing the hidden human side of a historic moment.

Use cinematic natural lighting, realistic period clothing, rich environmental details and a premium photojournalistic style.

The image should look like a rare archival photograph capturing everything that happened just outside the history books.
Un coffret collector
Les coffrets collector sont devenus un excellent terrain d’expression pour les IA génératives. Entre packaging premium, objets soigneusement présentés et finitions haut de gamme, ils donnent immédiatement l’impression d’un véritable produit de collection. Une bonne idée de prompt pour tous ceux qui cherchent à vendre des produits, ou visent un résultat professionnel avec leurs visuels marketings générés par l’IA.
Plus le thème est original, plus le résultat est spectaculaire.
Voir le prompt utilisé
Create a premium collector's edition box set celebrating the art of coffee.

The box should be open, revealing a beautifully arranged collection including:
- a handcrafted espresso cup
- rare coffee beans from around the world
- a vintage coffee grinder
- a tasting journal
- collectible art prints
- an enamel pin
- a premium brewing guide
- exclusive accessories

Use luxury packaging with embossed details, elegant typography, premium materials and carefully designed compartments.

Everything should be photographed like a high-end collector's edition sold in a luxury design store, with cinematic lighting and exceptional attention to detail.
Une bibliothèque monumentale
Les nouveaux modèles excellent dans les compositions gigantesques où chaque recoin raconte une histoire. Ce type de visuel impressionne autant par son échelle que par la quantité de détails à explorer. Choisissez un thème fédérateur pour inviter le regard à voyager dans toute l’image.
Voir le prompt utilisé
Create a breathtaking monumental library dedicated to every major invention in human history.

The library should be immense, with towering bookshelves stretching beyond sight, monumental staircases, suspended walkways, reading galleries and grand skylights.

Each section of the library represents a different era of innovation, featuring beautifully displayed artifacts, illustrated manuscripts, scale models and immersive exhibition spaces.

Populate the scene with historians, engineers, inventors and visitors quietly exploring the collections.

The atmosphere should feel awe-inspiring, timeless and majestic, combining classical architecture with subtle futuristic elements.

Render the scene as an ultra-detailed cinematic wide-angle illustration, filled with hundreds of small details that reward close inspection.
Une fresque en micro-détails
Certaines images donnent envie d’être explorées pendant plusieurs minutes. En multipliant les scènes, les personnages et les anecdotes dans un même décor, ChatGPT Images produit de véritables fresques où chaque zoom révèle une nouvelle histoire. Plus le thème est riche, plus le résultat est captivant.
Voir le prompt utilisé
Create an ultra-detailed panoramic illustration of a bustling futuristic floating city at sunset.

The scene should contain hundreds of tiny stories happening simultaneously, including:

- families enjoying rooftop gardens
- flying public transportation
- street musicians
- open-air markets
- scientists working in glass laboratories
- children playing in parks
- cafés suspended above the clouds
- artists painting murals
- delivery drones
- rooftop sports
- hidden alleyways
- public celebrations
- small humorous situations scattered throughout the city

Every area of the image should tell its own story while remaining part of a coherent world.

Use a vibrant, highly detailed editorial illustration style with warm lighting, cinematic atmosphere and exceptional environmental storytelling.

The image should reward viewers who zoom in and discover new details again and again.
Un diorama miniature hyperréaliste
Les dioramas miniatures font partie des créations les plus bluffantes à réaliser avec ChatGPT Images. En jouant sur le changement d’échelle, l’IA transforme une scène banale en véritable œuvre de collection, avec un niveau de détail qui donne l’impression d’observer une maquette réalisée à la main.
Voir le prompt utilisé
Create an ultra-realistic miniature diorama of a traditional Italian village built entirely inside an old leather travel suitcase.

The suitcase is open, revealing a complete miniature world with:
- narrow cobblestone streets
- tiny cafés with outdoor terraces
- a central village square
- small fountains
- handcrafted houses covered with terracotta roofs
- miniature trees and gardens
- tiny people going about their daily lives
- warm evening lights glowing through the windows

The diorama should look handcrafted by a master model maker, using realistic miniature materials, intricate textures and exceptional attention to detail.

Photograph the scene from a slightly elevated angle with soft natural lighting and a shallow depth of field, making it feel like a real museum-quality scale model.
Une scène vue à travers un bloc de glace
Les nouveaux modèles reproduisent avec une grande finesse les effets de transparence, de réfraction et de lumière. En imposant un point de vue original, vous obtenez une image beaucoup plus cinématographique qu’un simple paysage ou portrait.
Voir le prompt utilisé
Create a breathtaking Arctic scene viewed entirely through a massive block of ancient crystal-clear ice.

The ice should dominate the foreground, revealing subtle cracks, trapped air bubbles, frost patterns and realistic light refraction.

Beyond the ice, show a polar landscape with distant mountains, the aurora borealis and a lone explorer crossing the frozen terrain.

The composition should make the viewer feel as though they are observing the scene from inside the glacier.

Use soft natural lighting, realistic optical distortions and a quiet, contemplative atmosphere.

The result should feel like an award-winning National Geographic photograph.
Une image qui se raconte elle-même
Les nouveaux modèles excellent désormais dans la composition de scènes complexes. En leur demandant de créer une image qui contient sa propre histoire, vous obtenez une œuvre fascinante où chaque niveau de lecture révèle un nouveau détail. Laissez une grande liberté de composition : c’est l’effet de mise en abyme qui fait toute la force du résultat.
Voir le prompt utilisé
Create a surreal visual paradox where a single image recursively contains itself.

The main scene is an artist working in a studio on a large canvas.

On the canvas, depict the exact same studio from a slightly different moment in time.

Inside that painting, show another version of the same studio again, continuing the recursion several times.

At each level, introduce subtle changes:
- different lighting
- evolving objects
- small clues
- changing expressions
- unexpected details that reward close observation.

The transitions should feel seamless and thought-provoking rather than mathematical.

Compose the image as a sophisticated contemporary artwork that invites viewers to explore it repeatedly and discover new stories with every zoom.

The result should feel like an impossible visual paradox exhibited in a modern art museum.
Nous arrivons au terme de cette sélection de tendances et d’idées de prompts pour ChatGPT Images 2.0, Gemini et les autres modèles de nouvelle génération.
Une chose ressort clairement : la génération d’images a changé de dimension. Les IA ne produisent plus seulement de belles illustrations, elles savent désormais gérer du texte, des mises en page complexes, des séries d’images cohérentes ou encore des styles visuels très élaborés.
Tout n’est pas encore parfait pour autant et les prompts les plus ambitieux révèlent encore quelques limites lors de la génération.
Mais ces imperfections se corrigent souvent en affinant le prompt ou en lançant une nouvelle génération. Plus que jamais, la qualité du résultat dépend autant de l’idée que de la manière de la formuler.
Il ne vous reste plus qu’à vous approprier ces exemples, les détourner et expérimenter. Et si vous connaissez d’autres prompts ou tendances qui repoussent les limites de la génération d’images, partagez-les en commentaire : cette sélection ne demande qu’à s’enrichir !