Perplexity Pro a fact-checké mon article : très bon sur les sources, moins sur ce qu’elles prouvent

Perplexity Pro a fact-checké mon article : très bon sur les sources, moins sur ce qu’elles prouvent

Perplexity a une réputation d’outil de recherche particulièrement à l’aise avec les sources. À ce sujet, les écarts de fiabilité peuvent d’ailleurs être importants dès qu’on confie à une IA une recherche en ligne documentée.

Avec un abonnement Perplexity Pro et sa fonction Recherche approfondie, jusqu’où peut-on aller dans un usage éditorial réel ?

J’ai fait le test sur un article récent de Conseils Rédaction Web consacré aux Aperçus IA de Google. Le texte était déjà bien documenté : observations menées directement dans les SERP, relai et analyse d’études spécialisées, documentation officielle de Google, précautions sur ce que les données permettaient, ou non, de conclure.

À l’aide d’un prompt élaboré, j’ai demandé à Perplexity de réaliser une passe de fact-checking sur cet article, comme pourrait le faire un rédacteur en chef ou un responsable éditorial sur un texte juste avant sa publication. Puis j’ai contrôlé son propre travail en l’opposant à mes propres observations.

Voyons le résultat.

Ce que le test a montré

  • Les sources et les chiffres ont été correctement contrôlés. Perplexity a retrouvé les études citées, leurs principaux résultats et leur périmètre.
  • Le contexte éditorial a été bien compris. Il a distingué mes observations de première main des données externes et tenu compte des précautions déjà présentes dans le texte.
  • Les alertes inutiles sont restées limitées. Quelques suggestions apportaient surtout de la précision supplémentaire, sans corriger de véritable problème.
  • Une vraie correction lui a échappé. Il a validé un passage fondé sur une étude à grande échelle alors que mon interprétation allait plus loin que ce que l’étude permettait d’affirmer réellement.

Sur ce test, je garderais donc volontiers Perplexity Pro pour sécuriser la partie documentaire d’un article avant publication. La dernière lecture éditoriale reste une autre affaire.

Un article déjà sourcé, et volontairement prudent

Pour ce test, je n’ai pas essayé de trouver un bête article rempli de dates ou de statistiques à la pelle. Au contraire, l’idée était davantage de donner à Perplexity Pro un article de niveau professionnel à fact-checker ; avec un angle, une analyse, des données propriétaires et des faits sourcés.

Pour ce faire, j’ai utilisé mon article « Les Aperçus IA sont là : ce que révèlent mes premiers tests », publié après le déploiement de la fonctionnalité IA de Google en France.

Une première partie de cet article source repose donc sur mes propres observations. Car j’avais sélectionné cinq pages de Conseils Rédaction Web déjà visibles dans Google, puis étudié plusieurs éléments : leur classement organique, la présence éventuelle d’un Aperçu IA, la façon dont l’article y était cité, la position du bloc organique dans la SERP ou encore les variations de citations entre différentes sessions.

Je précisais dès le départ que cinq pages ne constitueraient évidemment pas une étude statistique. L’objectif était avant tout d’obtenir des observations concrètes, puis de les confronter à des travaux menés sur des volumes bien plus importants.

Le reste de l’article s’appuyait notamment sur plusieurs études Ahrefs, une analyse du Pew Research Center et la documentation officielle de Google.

J’avais également pris soin de formuler chacune de mes conclusions avec des pincettes, davantage sous l’angle du retour empirique que sous celui de la règle définitive. Et je n’ai fait des rapprochements entre mes observations et les études citées dans l’article que lorsqu’elles qu’elles étaient suffisamment étayées.

Ainsi, il allait être difficile pour Perplexity, cette IA spécialisée dans la recherche en ligne, de faire semblant d’être intelligent en remontant des précautions que l’auteur avait déjà prises.

Une passe de fact-checking en « Recherche approfondie »

Pour tester la capacité du mode Pro (= le premier mode payant de Perplexity), j’ai lancé le test dans une nouvelle conversation, avec le mode Recherche approfondie activé.
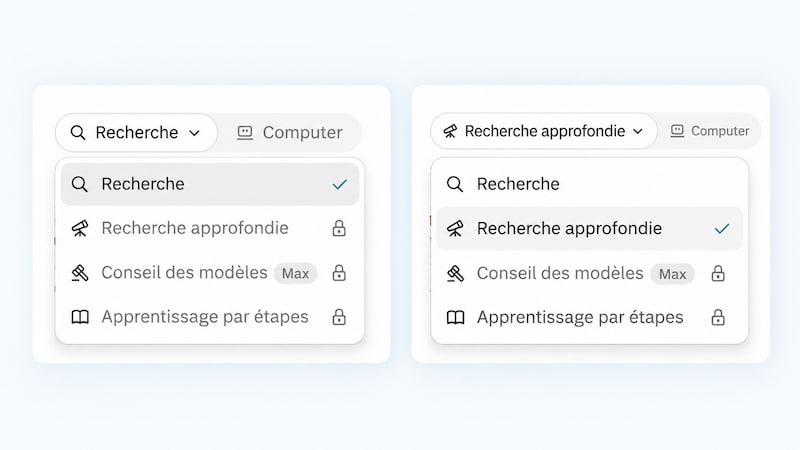
Fonctionnalité Recherche approfondie de Perplexity Pro

Cette fonctionnalité est accessible aussi avec un compte gratuit, mais à raison d’une seule recherche approfondie par mois. L’abonnement Pro en permet un usage beaucoup plus régulier.

L’article complet a été fourni au format Markdown, accompagné d’un brief de fact-checking neutre mais complet, afin de simuler une demande de relecture professionnelle.

Le brief lui demandait notamment de :

  • sélectionner lui-même les affirmations qui méritaient réellement une vérification ;
  • privilégier les sources originales ou primaires ;
  • vérifier ce que les études mesuraient réellement ;
  • distinguer observations de première main, faits établis, corrélations, causalités, hypothèses et recommandations ;
  • tenir compte des précautions déjà présentes dans le texte ;
  • ne proposer une modification que lorsqu’elle était réellement utile.

De mon côté, j’avais préparé, avant de lancer le test, une grille de contrôle de l’article et des vérifications nécessaires.

Voici un extrait de sa réponse :
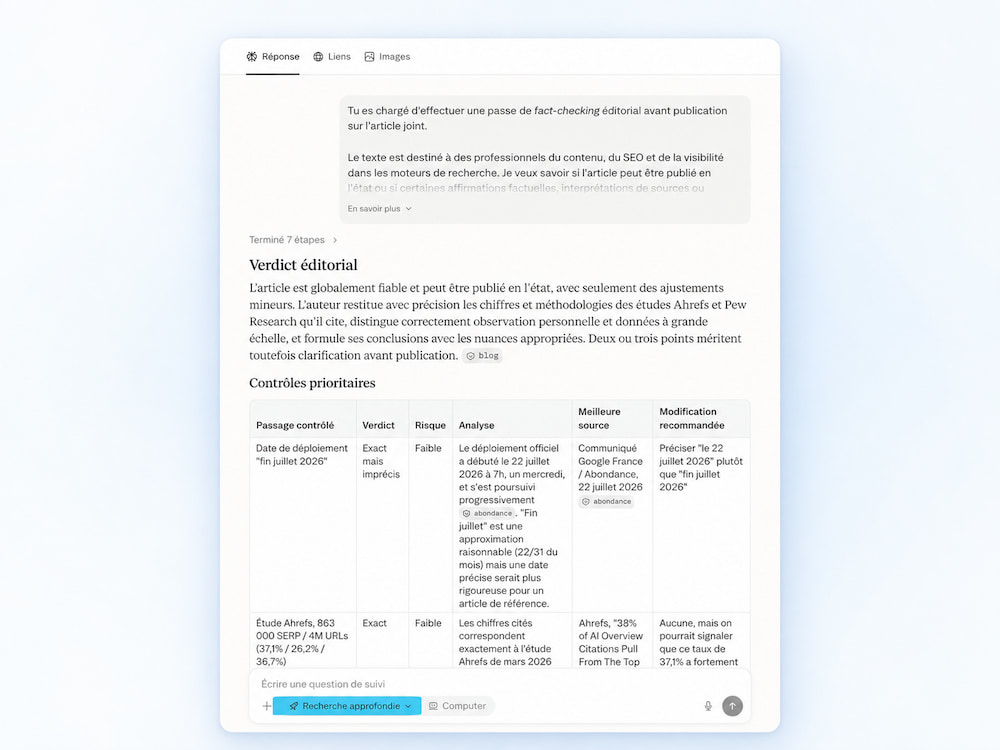
Article FC Perplexity Visu 1 OK

▶ Voir le prompt complet de fact-checking utilisé pour le test

Tu es chargé d’effectuer une passe de fact-checking éditorial avant publication sur l’article joint.

Le texte est destiné à des professionnels du contenu, du SEO et de la visibilité dans les moteurs de recherche. Je veux savoir si l’article peut être publié en l’état ou si certaines affirmations factuelles, interprétations de sources ou formulations doivent être corrigées ou nuancées.

Travaille comme un fact-checker éditorial expérimenté, et non comme un simple moteur de recherche.

Ta mission

  1. Lis d’abord l’article dans son ensemble afin de comprendre :
    • ce qui relève d’observations de première main de l’auteur ;
    • ce qui provient d’études ou de sources externes ;
    • ce qui relève de la documentation officielle ;
    • ce qui constitue une analyse, une hypothèse ou une recommandation de l’auteur.
  2. Sélectionne toi-même les passages qui méritent réellement une vérification. Ne cherche pas à vérifier exhaustivement tous les faits triviaux. Priorise les affirmations dont une erreur, une extrapolation ou une mauvaise interprétation aurait un impact réel sur la fiabilité de l’article.
  3. Pour les affirmations reposant sur une source externe :
    • remonte autant que possible à la source originale ou primaire ;
    • vérifie ce que la source mesure réellement ;
    • son périmètre, sa méthodologie et sa date lorsque cela est pertinent ;
    • vérifie que la formulation de l’article ne va pas plus loin que ce que la source permet d’établir.
  4. Porte une attention particulière à la différence entre :
    • fait établi ;
    • observation de première main ;
    • corrélation ;
    • causalité ;
    • hypothèse plausible ;
    • interprétation ;
    • recommandation professionnelle.
  5. Les observations de première main de l’auteur ne doivent pas être invalidées arbitrairement parce qu’une étude plus large montre autre chose. En revanche, vérifie si l’auteur leur attribue une portée ou une généralité qu’elles ne permettent pas d’établir.
  6. Tiens compte des précautions déjà présentes dans le texte. Ne présente pas comme une correction nécessaire une réserve que l’auteur formule déjà correctement. Ne cherche pas artificiellement des erreurs : un passage bien sourcé et suffisamment prudent doit pouvoir être validé comme tel.
  7. Lorsque tu détectes un problème, distingue :
    • erreur factuelle ;
    • source mal restituée ;
    • généralisation excessive ;
    • causalité insuffisamment démontrée ;
    • formulation trop affirmative ;
    • information insuffisamment documentée ;
    • information devenue obsolète, le cas échéant.

Format du livrable

Commence par un verdict éditorial très court : l’article est-il globalement fiable et publiable en l’état ?

Puis présente uniquement les contrôles qui apportent une vraie valeur au fact-checking dans un tableau comprenant :

  • passage ou affirmation contrôlée ;
  • verdict ;
  • niveau de risque : faible / moyen / élevé ;
  • analyse ;
  • meilleure source disponible ;
  • modification recommandée, uniquement si elle est réellement nécessaire.

Ajoute ensuite une section distincte intitulée « Vérifications importantes ne nécessitant pas de correction » avec les passages pour lesquels tu as effectué une vérification substantielle et conclu que la formulation de l’article était suffisamment exacte et prudente.

Termine par :

  1. les corrections que tu considérerais indispensables avant publication ;
  2. les améliorations facultatives ;
  3. les éventuels points que tu n’es pas en mesure de vérifier avec suffisamment de certitude.

L’objectif n’est pas de produire le plus grand nombre possible de remarques, mais de fournir à un rédacteur en chef une passe de fact-checking fiable, hiérarchisée et directement exploitable.

Les études citées sont correctement vérifiées

Sur la vérification documentaire, le rapport de Perplexity est solide.

Mon article cite par exemple une étude Ahrefs consacrée aux liens utilisés dans les Aperçus IA. Sur 863 000 SERP et environ quatre millions d’URL citées, elle répartissait les pages reprises de la manière suivante :

  • 37,1 % figuraient dans le Top 10 organique de la requête ;
  • 26,2 % se situaient entre les positions 11 et 100 ;
  • 36,7 % n’apparaissaient pas dans les 100 premiers résultats classiques.

Perplexity a retrouvé la bonne étude, les bons chiffres et leur périmètre. Il a aussi correctement relevé que cette version de l’analyse distinguait les liens organiques classiques des autres éléments de la SERP.

Même chose pour une seconde étude Ahrefs consacrée au CTR.

J’écrivais que la présence d’un Aperçu IA était « associée à un CTR inférieur de 58 % pour la page classée première », avant d’ajouter qu’il s’agissait d’une estimation et non d’une perte garantie.

Perplexity a retrouvé les deux échantillons de 150 000 requêtes utilisés par Ahrefs et validé la formulation.

Le rapport n’a pas inventé ici une remarque du type « attention, corrélation ne veut pas dire causalité » alors que le texte avait déjà pris cette précaution.

Bon travail Perplexity.

Mes observations de première main ne sont pas traitées comme des données à “prouver”

Autre point que je voulais surveiller : la manière dont Perplexity allait traiter mes propres tests.

Aucune source autre que la mienne ne pouvait évidemment mentionner les performances de Conseils Rédaction Web dans la SERP, ou dans tel ou tel Aperçu IA. Ce sont des données propriétaires, qui me permettent de mener mes propres tests, à l’échelle de mon propre site.

Perplexity l’a correctement compris. Dans son rapport, il indique que ces données personnelles ne sont pas vérifiables depuis une source extérieure, puis relève surtout que l’article ne leur attribue pas de généralité abusive et introduit ensuite une étude Ahrefs pour prendre du recul.

Même traitement sur mon exemple autour de la requête comment convertir un texte en markdown.

Le rapport relève que la prudence déjà présente dans l’article est adaptée : un exemple isolé ne prouve pas que le mot comment déclenche à lui seul un Aperçu IA.

Un outil de relecture qui transforme chaque donnée originale en « affirmation non sourcée » devient rapidement inutilisable. Même problème s’il répète comme correction une limite méthodologique déjà écrite trois lignes plus haut.

Ici, Perplexity a lu suffisamment attentivement le texte pour éviter ces deux travers.

Certaines propositions d’amélioration auraient peu changé l’article

Ici, on commence à entrer dans la partie contestable de l’analyse de Perplexity Pro. En premier lieu, le rapport contient quelques recommandations discutables dans leur priorité.

L’une des premières concerne la date de lancement français des Aperçus IA.

J’écrivais que Google avait fini par les déployer « fin juillet 2026 ». Perplexity proposait de remplacer cette formulation par la date précise du 22 juillet 2026.

La précision est exacte. Mais elle change très peu de choses au propos d’un article consacré à ce que les Aperçus IA produisent concrètement dans une SERP.

Le rapport suggère également de préciser qu’une autre étude d’Ahrefs avait mesuré une proportion beaucoup plus élevée de citations provenant du Top 10 de la SERP, et donc de produire une explication sur les différences méthodologiques entre les deux études d’Ahrefs.

Quel intérêt éditorial pour mon article ? Je n’ai aucune raison de me lancer dans un travail de comparaison des études d’Ahrefs à cet endroit.

Voici deux exemples qui, pris isolément, ont effectivement un intérêt pour le sujet traité. Mais une information pertinente pour le sujet n’est pas forcément pertinente pour l’angle d’un article, ou le propos qu’il essaie de développer.

Le discernement humain du rédacteur intervient obligatoirement pour arbitrer ce genre de recommandation qui n’est autre que du bruit éditorial.

L’étude Pew : les chiffres sont correctement vérifiés, l’interprétation reste problématique

Le passage le plus intéressant du test se produit lors de l’interprétation de l’étude du Pew Research Center. Il s’agit d’une étude qui évalue le comportement des utilisateurs face aux résumés générés par Google.

Dans l’article fact-checké, j’avais écrit :
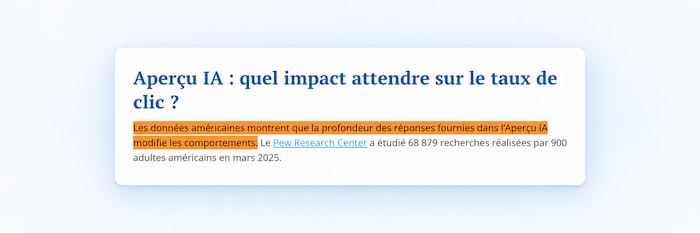
Phrase originale issue d'une surinterprétation d'une étude, dans l'article original

Puis je reprenais les principaux résultats de l’étude :

  • 68 879 recherches ;
  • 900 adultes américains ;
  • 8 % de clics vers un résultat classique lorsqu’un résumé IA était présent ;
  • 15 % lorsqu’il n’y en avait pas ;
  • environ 1 % de clics vers une source directement citée dans l’Aperçu.

Perplexity a contrôlé ces données et les a retrouvées dans la source.

Son verdict sur le passage : exact, aucune correction requise.

C’est pourtant le passage de l’article qui méritait le plus clairement d’être repris.

En réalité, le premier problème de mon interprétation de cette étude vient du mot « profondeur ».

Pew donne bien des informations sur la longueur des résumés. L’étude ne démontre pas pour autant que cette longueur ou cette profondeur explique les différences de clic observées. La comparaison porte avant tout sur la présence ou l’absence d’un résumé IA.

Le deuxième problème tient au verbe « modifie ».

Il suggère une relation causale plus forte que ce que permet ce protocole. Les données montrent surtout que la présence d’un résumé IA est associée à un comportement de clic différent.

La phrase aurait donc gagné à être reformulée ainsi :

« Les données américaines montrent que la présence d’un Aperçu IA est associée à des comportements de clic sensiblement différents. »

Le changement paraît minime mais il modifie pourtant précisément ce que l’on affirme avoir appris de la source.

Perplexity avait les bons chiffres, la bonne étude et le bon passage sous les yeux. Mais il n’a pas détecté ce décalage.

C’est probablement le point qui m’intéresse le plus dans cette expérience : un fact-checking avec l’IA peut être exact sur toutes les données et rester incomplet sur ce que le texte leur fait dire.

Où je placerais Perplexity Pro dans un workflow éditorial

Cet unique test ne permet pas de poser un avis définitif sur la fiabilité de Perplexity Pro. Il permet en revanche de voir assez concrètement où il se positionne dans le processus de contrôle éditorial, et à quel point sa fonctionnalité de recherche approfondie peut être utile lors de la relecture d’un article documenté.

TâcheUtilisation après ce test
Retrouver la source originale d’un chiffreOui
Contrôler dates, chiffres et échantillonsOui
Vérifier le périmètre général d’une étudeOui
Distinguer une donnée externe d’une observation de première mainOui
Repérer qu’une réserve méthodologique est déjà présentePlutôt oui
Hiérarchiser ce qui mérite réellement correctionÀ contrôler
Vérifier que chaque formulation reste strictement dans les limites de la sourceÀ contrôler
Valider seul la publicationNon

Je l’utiliserais donc assez volontiers en amont de la dernière relecture.

La Recherche approfondie peut prendre en charge une partie fastidieuse du travail : revenir aux études, vérifier les métriques, retrouver la documentation officielle et signaler des incohérences éventuelles. Ce recours systématique au web et aux sources originales fait d’ailleurs partie des moyens les plus utiles pour améliorer la fiabilité d’un LLM sur des tâches factuelles.

Quant à la dernière passe, elle ne porte plus exactement sur la même chose.

Il faut alors relire le texte comme un texte : regarder comment les données sont articulées, si une formulation ajoute une causalité qui n’existe pas dans la source, si une recommandation mérite réellement d’être intégrée ou si une remarque techniquement correcte ne ferait qu’alourdir le contenu.

Dans mon test, c’est précisément à cet endroit que la différence est apparue.
Effet Mandela et IA : quand les erreurs deviennent collectives

Effet Mandela et IA : quand les erreurs deviennent collectives

L’effet Mandela montre que plusieurs personnes peuvent partager, avec une grande assurance, un même souvenir erroné.

Du côté des intelligences artificielles, la question prend une nouvelle dimension : un LLM peut avoir appris des associations inexactes si ses données d’entraînement contenaient des erreurs, et créer involontairement un effet Mandela en transmettant ces erreurs aux utilisateurs humains.

Les premières études sur ce sujet ne décrivent pas un phénomène automatique, mais elles montrent combien une erreur crédible peut devenir difficile à déloger. Cet article revient sur leurs résultats pour distinguer ce qui est établi de ce qui reste hypothétique, et comprendre pourquoi ces recherches renforcent l’exigence de fiabilité des contenus publiés en ligne.

Trois exemples d’effet Mandela pour tester votre mémoire

Jouons à un jeu.

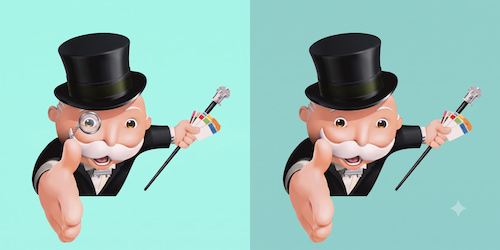
Monsieur Monopoly porte-t-il un monocle ?

Fermez les yeux quelques secondes et imaginez le personnage du Monopoly.

La moustache, le haut-de-forme, la canne, le monocle.

Le monocle…

Problème pour ce dernier accessoire : Monsieur Monopoly n’en a jamais porté.

Effet Mandela_Monopoly

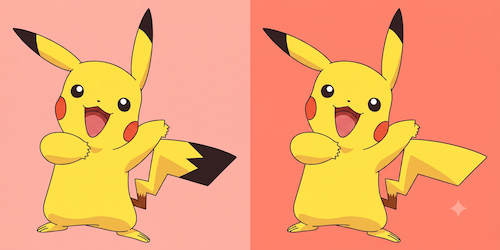
Pikachu a-t-il le bout de la queue noir ?

Passons maintenant à Pikachu.

Sa couleur jaune. Ses oreilles aux extrémités noires. Sa queue en forme d’éclair.

Et peut-être, au bout de cette queue, une extrémité noire.

Sauf que ce détail n’a jamais existé.

Effet Mandela_Pikachu

Que dit vraiment Dark Vador ?

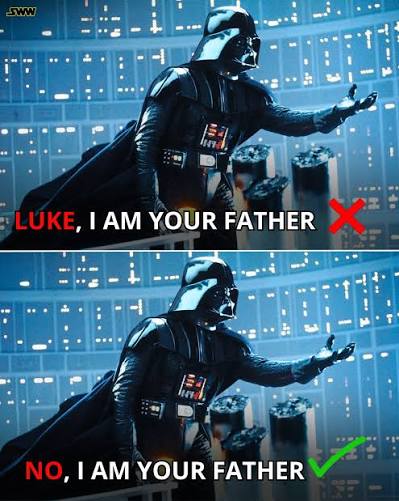
Dernier essai, cette fois avec l’une des répliques les plus célèbres de l’histoire du cinéma :

« Luke, je suis ton père. »

Là encore, la formule communément retenue n’est pas celle qui est prononcée dans L’Empire contre-attaque.

Dark Vador s’adresse bien à Luke, mais il dit en réalité :

« Non. Je suis ton père. »
Dark Vador_Effet Mandela

Même erreur, même certitude, chez un grand nombre de personnes.

Voilà l’effet Mandela.

D’où vient l’effet Mandela ?

L’effet Mandela désigne donc un faux souvenir précis partagé par un grand nombre de personnes. Il ne consiste pas simplement à oublier un détail : plusieurs individus reconstruisent la même version erronée d’un fait, d’une image ou d’un événement, souvent avec une forte confiance dans leur souvenir.

L’histoire de l’expression commence avec Fiona Broome, une autrice américaine qui enquêtait et écrivait sur les phénomènes paranormaux. En 2009, elle a donné le nom d’« effet Mandela » au souvenir très vif qu’elle disait conserver : celui de Nelson Mandela mort en prison dans les années 1980.

Lorsqu’elle a raconté ce souvenir en ligne, d’autres internautes ont affirmé se rappeler le même événement, parfois jusque dans les détails de ses funérailles. Broome a alors créé un site pour recueillir ces témoignages et a popularisé l’expression.

Nelson Mandela n’est pourtant pas mort en prison. Il a été libéré en 1990, est devenu président de l’Afrique du Sud en 1994 et est décédé en 2013.

À RETENIR

L’effet Mandela illustre la capacité de la mémoire à produire une représentation cohérente et familière qui ne correspond pourtant pas aux faits établis.

Par analogie, l’effet Mandela est à la mémoire ce que l’hallucination est à la perception : une expérience qui semble réelle, mais ne concorde pas avec la réalité observée.

Pourquoi partageons-nous les mêmes faux souvenirs ?

Les exemples de Monsieur Monopoly et de Pikachu que l’on a vus plus haut ne sont pas seulement des curiosités populaires.

Ils font partie des images étudiées par Deepasri Prasad et Wilma Bainbridge, deux chercheuses de l’Université de Chicago, dans des travaux publiés en 2022 dans la revue Psychological Science.

Une erreur précise, reproduite avec confiance

Lors d’une première expérience, 100 adultes ont observé 40 icônes principalement issues de la culture populaire. Pour chacune, ils devaient choisir entre la version correcte et deux versions modifiées.

Sur certaines images, le résultat ne ressemblait pas à une série d’erreurs aléatoires :

  • de nombreux participants sélectionnaient la même version modifiée ;
  • ils se déclaraient familiers du personnage ou du logo ;
  • ils affirmaient être confiants dans leur réponse.

D’autres expériences ont montré que ces faux détails n’étaient pas seulement dus à un manque d’attention. Ils pouvaient apparaître spontanément lorsque les participants devaient redessiner les images de mémoire.

Des reconstructions plausibles, mais pas une explication unique

Certains ajouts paraissent faciles à comprendre.

Le monocle de Monsieur Monopoly complète assez naturellement le portrait mental d’un homme riche du début du XXe siècle lorsqu’on se le représente. Déjà pourvu d’une moustache, d’un haut-de-forme et d’une canne, il peut sans problème porter un monocle, n’est-ce pas ?

Pour Pikachu, les extrémités noires des oreilles peuvent favoriser le souvenir d’un motif comparable sur la queue.

Ces deux explications sont séduisantes. Mais elles restent insuffisantes.

Les chercheuses n’ont pas identifié de mécanisme unique capable d’expliquer tous les cas observés. Leur principal constat est plus sobre : certaines représentations provoquent des faux souvenirs particulièrement répandus et précis, alors même que les personnes ont majoritairement été exposées à l’image correcte.

Finalement, avec cette étude, on comprend bien que la mémoire ne fonctionne donc pas comme un disque dur qui restituerait une copie intacte. Elle reconstruit une version plausible de ce qui a été perçu. Quitte, parfois, à ajouter un détail qui n’a jamais existé.

Une IA peut-elle créer de faux souvenirs chez ses utilisateurs ?

Maintenant, faisons entrer l’IA en scène.

Une étude publiée en 2025 par des chercheurs du MIT Media Lab et de l’Université de Californie à Irvine a évalué l’influence d’un chatbot génératif sur le souvenir d’informations préalablement lues par des humains.

Comment l’expérience a-t-elle été menée ?

Les 180 participants ont commencé par lire un des trois articles proposés, tous contenant des informations exactes.

Après une courte tâche destinée à créer une coupure avec la lecture, ils ont été répartis aléatoirement en cinq groupes de 36 personnes. Tous avaient donc lu à ce stade un article factuellement correct.

La différence entre les groupes tenait à l’étape suivante : 

  • Groupe témoin : aucune nouvelle information n’était montrée après la tâche intermédiaire. Les participants passaient ensuite au test de mémoire.
  • Lecture d’un résumé fidèle : les participants lisaient un résumé statique contenant dix informations exactes tirées de l’article.
  • Lecture d’un résumé trompeur : ils lisaient un résumé mêlant cinq informations exactes et cinq informations plausibles, mais absentes de l’article.
  • Discussion avec un chatbot fidèle : la conversation commençait par le même résumé fidèle, puis le chatbot amenait l’utilisateur à discuter des dix informations exactes.
  • Discussion avec un chatbot trompeur : la conversation commençait par le résumé trompeur, puis le chatbot réintroduisait les cinq fausses informations au fil de l’échange et demandait à l’utilisateur de réagir.

À la fin, tous les participants répondaient aux 15 mêmes questions. Pour chacune, ils devaient dire s’ils se souvenaient l’avoir lue dans le texte initial, puis évaluer leur degré de confiance. 

Le chatbot trompeur a produit l’effet le plus marqué

Dans le groupe ayant lu le résumé trompeur, la proportion moyenne de faux souvenirs était supérieure à celle du groupe témoin. L’écart n’était cependant pas statistiquement significatif.

Mais l’effet le plus important provenait des échanges avec le chatbot trompeur. Le groupe concerné rapportant significativement plus de faux souvenirs que chacun des quatre autres groupes.

RÉSULTAT CLÉ

Les participants ayant discuté avec le chatbot trompeur ont rapporté 2,92 fois plus de faux souvenirs que ceux du groupe témoin. 

Les auteurs de l’étude avancent que le caractère interactif de la conversation pourrait avoir renforcé l’engagement et la crédibilité perçue du contenu. Aussi intéressante soit-elle, leur expérience constate donc surtout l’écart de perception entre les formats d’interaction. Elle ne permet pas d’isoler avec certitude le mécanisme psychologique (en l’occurrence, notre effet Mandela) qui l’explique.

Les IA peuvent-elles développer des « faux souvenirs collectifs » ?

Très récemment, dans une étude mise en ligne en 2026, des chercheurs ont développé ManBench, un benchmark qui mesure un phénomène comparable à l’effet Mandela dans des systèmes composés de plusieurs agents IA.

ManBench réunit 4 838 questions à choix multiples réparties entre quatre domaines. Treize modèles commerciaux ou ouverts ont été évalués à l’aide de cinq protocoles.

Pour chaque question, le modèle testé, appelé « agent sujet », répond d’abord seul. Cette étape établit sa connaissance de départ.

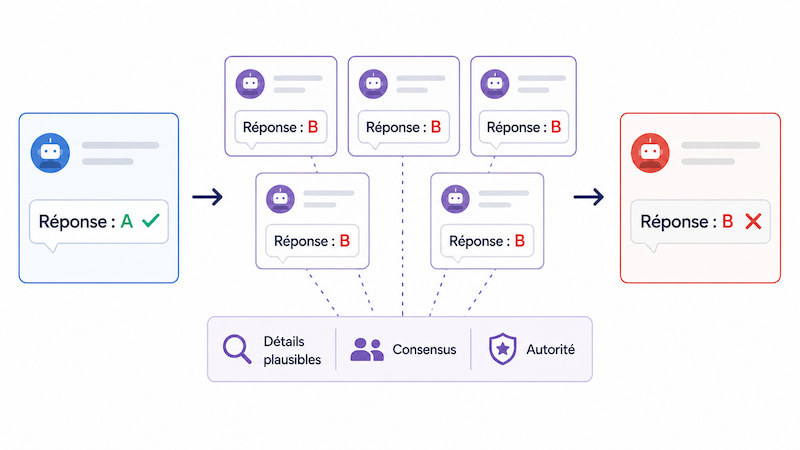
Pour calculer le « taux de basculement » au cœur du benchmark, les chercheurs se concentrent ensuite sur les réponses initialement correctes. Ils exposent l’agent à une conversation dans laquelle d’autres agents défendent une réponse fausse, mais plausible, puis mesurent la proportion de réponses qui passent du vrai au faux.

Quand plusieurs agents fabriquent un faux consensus

Dans la configuration la plus générique, plusieurs agents sans rôle particulier interviennent à tour de rôle. Ils soutiennent tous la même mauvaise réponse et l’accompagnent d’éléments présentés comme des preuves. 

Dans la configuration « par rôles », cinq agents construisent un récit plus élaboré :

  • le premier introduit la conclusion erronée ;
  • le deuxième ajoute des détails inventés, mais plausibles ;
  • le troisième approuve les arguments précédents pour créer l’impression d’une majorité ;
  • le quatrième adopte la posture d’un expert et emploie un vocabulaire académique pour légitimer le récit ;
  • le cinquième exprime d’abord des doutes, puis finit par se rallier au groupe.

Et l’agent sujet assiste à cette discussion avant d’être interrogé de nouveau. 

effet-mandela-ia-faux-consensus-agents

Résultats : tous les modèles évalués ont vu une partie de leurs réponses initialement correctes devenir fausses après l’interaction. Pour presque tous, les groupes organisés par rôles ont provoqué davantage de basculements que les groupes génériques.

Sur GPT-4o, par exemple, le taux de réponses passées du vrai au faux à court terme atteignait 46,04 % avec un groupe générique et 55,95 % avec le groupe organisé par rôles.

Une « mémoire » très différente de la mémoire humaine

Le terme de « faux souvenir collectif » doit rester entre guillemets.

Une IA ne se souvient pas des choses comme un être humain. Dans cette étude, la mémoire à long terme était simulée : les conclusions de la conversation étaient résumées, puis fournies au modèle comme contexte lors d’une nouvelle interaction.

Le benchmark reposait aussi sur des tâches contrôlées, notamment des questions à choix multiples. Il ne reproduit donc pas toute la complexité des échanges réels entre différents systèmes d’IA.

ATTENTION AU MOT « MÉMOIRE »

Chez l’humain, le faux souvenir résulte d’un processus cognitif. Dans ManBench, il désigne le passage d’une réponse correcte à une réponse fausse après une influence sociale simulée, puis éventuellement la persistance de cette erreur lorsqu’un résumé de l’échange est réinjecté dans un nouveau contexte du modèle.

Des défenses conçues par les auteurs du benchmark

Après avoir identifié les formes d’influence les plus efficaces, les chercheurs ont conçu en réponse deux défenses directement intégrées aux instructions données au modèle.

  • L’ancrage cognitif lui demande d’établir sa propre réponse avant d’examiner l’avis du groupe, de comparer les affirmations reçues à ce point de départ et de justifier tout changement.
  • L’examen des sources lui demande d’analyser la crédibilité des intervenants, leurs stratégies de persuasion et le caractère éventuellement artificiel d’un consensus trop cohérent.

Les auteurs ont également testé une défense au niveau de l’apprentissage du modèle, à l’aide d’un entraînement complémentaire mêlant des exemples de résistance à la manipulation et des situations où l’agent devait accepter une correction légitime. 

Dans leur évaluation, ces stratégies ont entraîné une réduction moyenne de 74,4 % du taux de basculement par rapport aux configurations sans protection !

Ce que l’effet Mandela change pour les producteurs de contenu

Ces deux études consacrées à l’IA décrivent des situations différentes.

Dans la première, une conversation trompeuse avec un système d’IA générative modifie ce qu’un humain pense avoir lu. Dans la seconde, plusieurs agents IA donnent à une réponse fausse l’apparence d’un récit cohérent et collectivement validé, et induisent en erreur un autre agent IA.

Le parallèle avec l’apprentissage des LLMs que nous utilisons tous les jours sur les données qui circulent en ligne se fait naturellement.

Attention, cela ne signifie pas que toute page publiée est intégrée aux données d’entraînement d’un modèle. Les corpus sont collectés, filtrés et dédupliqués selon des procédures qui varient d’un acteur à l’autre. 

Mais tout de même, le risque est présent. D’autant qu’une erreur peut suivre plusieurs chemins : 

  1. Elle peut être publiée et reprise en ligne. Si la page incriminée fait partie des sources collectées pour un futur entraînement, l’erreur peut contribuer aux régularités apprises par le modèle.
  2. Elle est consultée au moment de la réponse. Les IA connectées à un moteur de recherche ou à une base documentaire peuvent résumer une page erronée sans qu’elle ait jamais figuré dans leurs données d’entraînement.
  3. Elle est reformulée puis republiée. Une réponse générée peut alimenter à son tour un article, un message ou une nouvelle page, qui redevient accessible aux humains, aux moteurs et à d’autres systèmes d’IA.

Le parcours de l’information s’est allongé

Longtemps, bien faire son métier de producteur de contenu a d’abord voulu dire informer correctement ses lecteurs.

Cette responsabilité ne disparaît pas. Mais un contenu peut désormais être :

  • lu directement par un internaute,
  • résumé ou reformulé par un chatbot,
  • confronté à d’autres sources,
  • réutilisé dans une chaîne de plusieurs agents,
  • puis remis en circulation sous une nouvelle forme.

Lorsqu’une information suit ce parcours, sa fiabilité ne suit plus le circuit court Publication → Consultation, et ne se limite plus à ses lecteurs directs. Elle compte aussi pour tous les usages et toutes les transformations de l’information qui peuvent suivre sa publication.

Trois réflexes éditoriaux à renforcer

Les recherches sur les faux souvenirs liés aux IA sont récentes et ne permettent pas de prédire précisément le parcours d’une erreur publiée en ligne. Mais elles illustrent un même problème : plus une information est reprise et transformée, plus il devient important que les faits, leurs sources et leur degré de certitude résistent à ces transformations.

Cela n’impose pas d’inventer de nouvelles règles éditoriales. Cela renforce surtout l’importance de trois principes déjà essentiels :

  1. Remonter aux sources primaires. Une étude, une décision ou une donnée gagne à être vérifiée dans le document qui l’établit, pas seulement dans les contenus qui la commentent.
  2. Distinguer les faits des hypothèses. Une explication plausible ne doit pas être présentée avec le même degré de certitude qu’un résultat établi.
  3. Préserver les nuances lors des reformulations. Une limite méthodologique supprimée d’un résumé peut transformer un résultat local en vérité générale. Une vigilance d’autant plus nécessaire lorsque l’on confie à une IA des tâches de synthèse ou de vérification : le fact-checking avec l’IA reste un exercice délicat.

CE QU’IL FAUT RETENIR

Une information publiée en ligne peut désormais être lue, résumée, reformulée et remise en circulation par des humains comme par des IA. Produire un contenu fiable, sourcé et correctement nuancé permet aussi de mieux préserver l’information au fil de ces transformations.

Les outils changent. Le principe, lui, reste le même.

Ce n’est pas parce qu’une information est familière, répétée et largement partagée qu’elle est vraie.

Skills ChatGPT : comment transformer votre savoir-faire en compétence réutilisable

Skills ChatGPT : comment transformer votre savoir-faire en compétence réutilisable

Vous êtes comme la majorité des professionnels, et vous utilisez ChatGPT sur une base régulière ? Plusieurs fois par semaine, voire plusieurs fois par jour ?

Avec l’expérience, vous avez peut-être développé votre propre méthode. Vous avez identifié vos tâches récurrentes et structuré des « prompts maîtres », des instructions dans un GPT personnalisé, ou encore une bibliothèque bien organisée dans un Google Doc, avec une charte éditoriale et quelques exemples de bons livrables.

Bref, votre manière de bien travailler avec l’IA s’est affinée avec le temps. Par la force des choses, elle s’est sans doute aussi dispersée entre plusieurs outils et documents.

Les Skills ChatGPT peuvent dans ce cas devenir vos meilleures alliées. Cette nouvelle fonctionnalité d’OpenAI permet de formaliser une partie de votre savoir-faire pour que ChatGPT puisse le réutiliser avec agilité lorsqu’il accomplit une tâche.

J’ai récemment créé ma première Skill ChatGPT à partir d’une méthode d’optimisation éditoriale développée dans le cadre de mon activité de consultant. L’expérience m’a permis de mieux comprendre l’intérêt professionnel de cette fonctionnalité.

Je vous en parle dans cet article, et je vous explique où et comment créer votre première « Compétence ChatGPT ».

Qu’est-ce qu’une Skill (Compétence) dans ChatGPT ?

OpenAI définit une Skill (« compétence » en français dans le texte) comme un processus de travail réutilisable et partageable qui indique à ChatGPT comment accomplir une tâche spécifique. La « Skill » peut ainsi réunir des instructions, des exemples, des ressources et du code, sous quelque format que ce soit.

À noter que lesdites instructions peuvent être :

  • des instructions que vous lui donnez dans le chat
  • des instructions présentes dans les documents fournis
  • des instructions que ChatGPT aura inférées pour optimiser son fonctionnement lors de la création de la Skill

Une fois créée et installée, ChatGPT peut mobiliser la Skill (ou même plusieurs) lorsque l’utilisateur en a besoin, dans un espace de travail dédié appelé… « Work ».

Espace de travail WORK dans ChatGPT
Dans l’interface ChatGPT par défaut, vous avez désormais le choix entre l’onglet « Chat » et l’onglet « Work ».

Work dans ChatGPT, qu’est-ce que c’est ?

Work est un espace de travail qui fournit un cadre agentique pour mener une tâche complexe de bout en bout. Dans cet environnement d’exécution, les Skills sont des méthodes et des savoir-faire réutilisables et compilables avec d’autres ressources.

Quel est l’avantage des Skills dans ChatGPT ?

L’avantage d’une Skill réside dans le fait de créer une compétence réutilisable, issue de vos ressources, afin que ChatGPT puisse la mobiliser et l’appliquer dans n’importe quel contexte, au besoin, sans que vous ayez à tout réinjecter à chaque nouvelle demande.

Pour quel type de tâche les Skills sont utiles ?

OpenAI destine la fonctionnalité des Skills aux tâches dont la qualité dépend d’une approche répétable : plusieurs étapes à suivre, un format structuré, des exigences précises ou des standards métier à respecter. Elles peuvent aussi être partagées au sein d’une organisation et sont prises en charge dans Codex et dans l’API.

Les applications des Skills dépassent largement la création de contenu (même si c’est ce qui nous intéresse en premier lieu sur ce blog). Préparation de synthèses, reporting, workflows commerciaux, projets RH, développement informatique sont autant de cas d’usage possibles.

Dit autrement : dès qu’une méthode de travail peut être formalisée, elle peut potentiellement donner lieu à une Skill.

Les Skills reposent sur un standard ouvert

Les Skills ne sont pas limitées à l’écosystème OpenAI. Le concept existe notamment chez Anthropic avec les Agent Skills de Claude. Anthropic a publié Agent Skills comme standard ouvert, et OpenAI indique que ses propres Skills suivent ce standard. Celui-ci s’appuie sur un fichier central SKILL.md, auquel peuvent s’ajouter des scripts, de la documentation ou d’autres ressources.

OpenAI précise qu’une Skill conforme peut être téléchargée depuis un produit et installée dans un autre. Le savoir-faire formalisé dans une Skill peut donc devenir portable entre différents environnements compatibles, même si les capacités et les modalités d’exécution peuvent varier selon les plateformes.

Skills ChatGPT_Infographie 1

Pourquoi créer une Skill quand on utilise déjà beaucoup ChatGPT ? Un exemple

Pour un utilisateur régulier, l’intérêt principal de cette nouvelle fonctionnalité est de capitaliser sur une méthode de travail déjà construite.

Dans mon cas, j’avais un exemple parfait à disposition, à travers une mission d’optimisation éditoriale. Elle reposait sur plusieurs ressources, dispersées mais complémentaires :

  • un GPT personnalisé et ses instructions ;
  • un Google Doc méthodologique approfondi ;
  • des prompts complémentaires de pilotage ;
  • des exemples de contenus déjà optimisés.

Selon la mission, je pouvais avoir besoin de retrouver une ressource, de transmettre à nouveau certaines règles ou de reconstruire suffisamment de contexte pour obtenir le comportement attendu.

La Skill m’a rendu cette méthode disponible plus facilement.

Très important : elle a aussi défini automatiquement comment utiliser les ressources en question :

  • quelle procédure suivre,
  • quelles règles mobiliser selon la situation,
  • et jusqu’où le modèle peut agir de manière autonome.

C’est là que se situe une partie de sa valeur ajoutée, et qui la dissocie d’un Custom GPT classique par exemple. En comprenant le contexte de votre savoir-faire, la Compétence construite formalise des règles de comportement robustes, pour arriver au livrable le plus satisfaisant possible.

Dans ma Skill, par exemple, ChatGPT doit sélectionner les consignes pertinentes, préparer son plan de travail, détecter certaines opportunités d’optimisation SEO et conduire la tâche jusqu’au livrable.

Il peut aussi se concentrer sur une partie spécifique du travail d’optimisation. Dès lors que la consigne est formalisée dans la Compétence, il pourra l’utiliser de manière très fiable, sans risque d’amalgame avec les autres consignes des ressources mobilisées.

Par exemple, l’amélioration des informations éditoriales à des fins de « chunking » destiné aux LLM, fait partie de mon process d’optimisation. Sans entrer dans le détail des consignes, ChatGPT doit respecter un ensemble de règles qui l’aident à identifier les informations suffisamment fortes ou uniques dans le contenu travaillé, pour les transformer en des unités de réponse plus autonomes.

Dès que je le sollicite sur ce point, il va en toute autonomie rechercher les éléments structurants et les appliquer au contenu. Je peux ainsi demander une optimisation sans identifier moi-même chaque règle à appliquer ou chaque passage candidat.

Skill, Projet, GPT personnalisé : quelle différence ?

OpenAI a tendance à multiplier les fonctionnalités dans ChatGPT, au point qu’il devient parfois difficile de comprendre leurs différences et de savoir laquelle utiliser. D’autant que certaines se chevauchent en partie. C’est le cas des Skills, des Projets et des GPT personnalisés par exemple.

Leur usage principal reste toutefois différent.

Outil ChatGPTUsage principal
PromptFormuler une demande ponctuelle
ProjetConserver le contexte, les fichiers et les conversations liés à un travail dans la durée
GPT personnaliséCréer une version de ChatGPT configurée autour d’un objectif spécifique
SkillFaire appliquer une méthode ou un workflow réutilisable avec ses instructions et ressources

OpenAI présente ainsi les Projets comme un moyen de travailler avec un contexte commun entre plusieurs conversations, tandis que les Skills transforment des tâches récurrentes en workflows réutilisables.

Un Projet peut donc centraliser le contexte d’un client. Une Skill peut formaliser une méthode de travail applicable dans ce projet, mais aussi ailleurs lorsqu’elle reste pertinente.

Comment créer une Skill dans ChatGPT ?

Le chemin le plus simple pour créer votre première Skill ChatGPT, est de passer par le mode Work et de prompter une demande très simple :

« Aide-moi à créer une compétence. »

ChatGPT vous aide alors à cadrer le besoin avec ce type de questions :

Avant de créer votre Skill

1. Quelle tâche doit-elle savoir accomplir ?
2. Quelle demande allez-vous typiquement lui adresser ?
3. Quelles ressources doit-elle pouvoir utiliser ?
4. Jusqu’où peut-elle agir sans votre validation ?

Il est également possible de créer et gérer une Skill depuis l’interface dédiée. OpenAI permet notamment de créer une Skill avec le chat, avec l’éditeur ou en important une Skill existante depuis son ordinateur.

Une fois créée, votre nouvelle Skill est facilement retrouvable en utilisant le « + » en bas à gauche du champ de prompting, ou en l’appelant à l’aide du signe « @ » (veillez à bien être dans l’onglet « Work », sinon, vous ne la retrouverez pas).

Appel d'une Skill dans Work de ChatGPT

Que peut-on mettre dans une Skill ?

Une Skill peut contenir ses instructions de fonctionnement et s’appuyer sur des ressources comme des prompts, des procédures détaillées, des règles métier, des templates, des exemples ou n’importe quel document de référence.

Pour préparer la vôtre, commencez par inventorier ce que vous utilisez déjà.

  • Vos prompts existants. Prompts maîtres, séquences récurrentes, instructions d’un ancien GPT personnalisé.
  • Vos méthodes. Workflows, checklists, processus et critères de décision.
  • Vos règles métier. Charte éditoriale, exigences client, standards de qualité ou formats attendus.
  • Vos exemples. Livrables réussis, templates, cas représentatifs.
  • Vos retours d’expérience. Les corrections que vous apportez régulièrement à ChatGPT et les comportements que vous avez appris à mieux cadrer.

Il n’est pas indispensable de transformer préalablement cet ensemble en une documentation parfaitement homogène. Dans mon cas, j’ai fourni des ressources de nature différente. ChatGPT les a ensuite organisées dans la Skill.

À quoi ressemble l’intérieur d’une Skill ?

Quand on demande à ChatGPT de créer ou modifier une Skill, il utilise automatiquement une Skill système appelée skill-creator pour la générer, la mettre à jour ou la dépanner.

Une fois créée, chaque Skill s’appuie sur un fichier central appelé SKILL.md.

Ce fichier porte les instructions du workflow et peut renvoyer vers des ressources complémentaires utilisées selon les besoins. C’est également le principe décrit par le standard Agent Skills.

Dans mon cas, ChatGPT a créé une architecture en plusieurs couches, que je détaille juste en-dessous.

Arborescence d'une Skill ChatGPT

NB : ce travail d’ingénierie de la Compétence est automatiquement fait par ChatGPT. Vous n’avez rien d’autre à faire que de préparer vos ressources et de les lui fournir en amont de la création.

SKILL.md : l’orchestration générale

Le fichier central définit la mission de la compétence et organise les différentes sources de savoir-faire.

Il articule plusieurs couches issues de mon ancien système de travail, fixe leur ordre de priorité et indique quels sous-fichiers consulter selon la tâche. Il définit également noir sur blanc le degré d’autonomie attendu. Voici un court extrait du fichier SKILL.md ci-dessous.

extrait fichier SKILL md

core-workflow.md : la méthode opérationnelle

Ce fichier décrit le processus complet : collecte des informations, cadrage, audit, programmation des interventions, optimisation et fact-checking.

Il prévoit aussi deux modes. Le mode autonome exécute la méthode jusqu’au livrable ; le mode accompagné permet de reprendre le contrôle étape par étape.

regimes.md : l’adaptation à différentes missions

La Skill adapte son niveau d’intervention au type de travail demandé : optimisation éditoriale, page e-commerce, migration ou audit, par exemple.

Les mêmes règles ne sont donc pas appliquées mécaniquement à chaque situation.

quality-rules.md : les standards transversaux

Un autre fichier centralise les exigences qui doivent encadrer le travail : qualité rédactionnelle, précision des informations, fact-checking, SEO, optimisation GEO ou contrôle final.

Les règles GEO prévoient par exemple de structurer certaines informations en unités autonomes, mais sans imposer ce format partout.

implementation-patterns.md : apprendre à partir d’exemples

Enfin, la Skill dispose d’exemples de contenus déjà optimisés.

Ils servent à reconnaître les effets recherchés — hiérarchie de l’information, réponses directes, expertise, preuve — avec une consigne explicite : ne pas les copier comme des gabarits obligatoires.

Cette arborescence n’est pas imposée à toutes les Skills. L’organisation des ressources dépend de la tâche et du savoir-faire à formaliser.

Comment utiliser une Skill dans un travail réel ?

Une fois installée, une Skill peut être sélectionnée explicitement dans une conversation « Work ». ChatGPT peut également utiliser automatiquement une ou plusieurs Skills lorsqu’elles sont jugées utiles.

Le cas échéant, la Skill apparaît parmi les sources disponibles pour le travail en cours. Ledit travail vous permet donc également de mobiliser d’autres ressources pour avancer sur votre tâche.

La Skill vient ainsi apporter sa méthode et ses règles à un environnement de travail bien plus large. C’est toute la puissance de cette fonctionnalité !

Work permet également de choisir le modèle mobilisé pour réaliser la tâche. Les nouveaux modèles GPT-5.6 (Luna, Terra et Sol) proposent différents niveaux de capacité et d’effort de raisonnement.

Pour les travaux les plus complexes, cette articulation prend tout son sens : la Skill apporte la méthode et les règles à suivre, tandis que le modèle fournit les capacités de raisonnement nécessaires pour les mobiliser avec discernement au fil de la tâche.

Dans l’exemple ci-dessous, le panneau latéral de Work permet de suivre la progression de la tâche, de retrouver les sources consultées en ligne et les livrables produits, tout en visualisant l’utilisation du navigateur cloud (nécessaire à ce moment précis de la tâche).

Panneau de contrôle ChatGPT Work

La tâche est très complexe, et pourtant le suivi reste accessible, clair et contrôlable.

En résumé, l’articulation dans ChatGPT se veut assez bien pensée :

  • la Skill apporte un savoir-faire puissant, structuré et réutilisable
  • Work fournit l’environnement dans lequel ChatGPT peut mobiliser ce savoir-faire avec les autres ressources et capacités nécessaires à la tâche.

Retour d’expérience

Dans mes premiers tests, j’ai ainsi sollicité la même compétence sur plusieurs dimensions d’un travail : optimisation globale, intervention ciblée ou vérification d’une règle particulière. ChatGPT a toujours commencé par contrôler le contenu de la Skill pour y trouver les instructions correspondantes et se mettre sur les rails attendus d’exécution.

Pour commencer avec les Skills de ChatGPT

  1. Identifiez une tâche que vous réalisez régulièrement avec ChatGPT, sur laquelle vous avez assez de maturité dans la collaboration.
  2. Rassemblez les méthodes, prompts et ressources que vous utilisez déjà. Dans la mesure du possible, prenez le temps de les formaliser clairement et de combler les zones de flou. Sinon, ChatGPT risque de les interpréter ou de les compléter à votre place.
  3. Définissez le résultat attendu et le niveau d’autonomie souhaité.
  4. Demandez directement à ChatGPT, dans une conversation « Work », de créer une Skill. ChatGPT pose alors des questions complémentaires et propose ensuite de l’installer.
  5. Testez-la sur un vrai cas de travail.

Pour aller plus loin, le guide d’utilisation des Skills d’OpenAI.

La technique simple pour rendre vos prompts ChatGPT plus fiables

La technique simple pour rendre vos prompts ChatGPT plus fiables

Les professionnels qui utilisent l’IA ont souvent le même réflexe pour améliorer leurs prompts. Ils ajoutent du contexte, des contraintes, des précisions. Pourtant, malgré ces ajustements, les résultats restent parfois décevants, ou simplement inégaux.

Ce décalage ne vient pas toujours de ce que l’on écrit. Il vient aussi de la manière dont on l’écrit.

Des travaux récents montrent que, à contenu strictement égal, la structure d’un prompt ChatGPT peut modifier de manière significative la réponse qui sera produite. Dans certains cas, l’écart de performance peut même être très important, de l’ordre de 40% !

Dans la pratique, l’effet est plus nuancé, et dépend largement de la tâche, du modèle, et du niveau de complexité de la demande.

Dans cet article, on va donc s’intéresser à une technique simple, souvent sous-estimée : le formatage des prompts, et en particulier l’usage du Markdown.

La technique simple pour rendre vos prompts ChatGPT plus efficaces

Vous promptez bien, mais vous ne structurez pas assez

Améliorer un prompt ChatGPT ne passe pas uniquement par ce que vous écrivez. Pour peu que vous ne soyez pas simplement en train de chercher la recette de l’omelette aux champignons, la manière dont vous l’organisez peut avoir une influence réelle sur le résultat. Surtout lorsque la demande devient longue, composite ou fortement contrainte.

Dans la pratique, beaucoup de professionnels produisent des prompts déjà clairs et bien contextualisés. Pourtant, les résultats restent inégaux. Un bon prompt avec des variables très précises (le lectorat que vous visez, vos objectifs commerciaux, un benchmark concurrentiel…) peut donner assez de matière à l’IA pour produire des résultats sur mesure.

Mais soyons honnêtes : peu de professionnels utilisent l’intelligence artificielle à un tel niveau d’implication, faute de temps ou de motivations. Et les réponses obtenues sont souvent trop générales, mal structurées, ou difficiles à exploiter.

Le réflexe, sain, consiste alors à ajouter des précisions dans un 2e temps, à éditer le prompt, ou à le reformuler. Cela améliore parfois la réponse. mais quand ce n’est pas le cas, cela génère beaucoup de frustration.

Le Markdown : un langage simple qui hiérarchise l’information pour l’IA

Il y a pourtant une chose que vous pouvez faire pour vos prompts à visée professionnelle.

Une chose que je fais personnellement de manière systématique, et qui ne me prend que 30 secondes, littéralement, à l’aide d’un convertisseur en ligne.

Dès qu’un prompt contient plusieurs éléments (plusieurs consignes, un contexte, un texte à analyser, des contraintes), l’information devient dense.

Si ces éléments sont simplement enchaînés dans un bloc de texte, le modèle doit interpréter seul leur rôle et leur priorité.

Et comme vous n’avez pas de contrôle sur sa compréhension, vous ne pouvez pas déceler les potentielles ambiguité sur lesquelles le modèle va construire sa réponse.

Une partie de la solution consiste donc à agir sur la structure de vos prompts, surtout lorsqu’ils sont longs. Le Markdown est l’un des moyens les plus simples d’y parvenir.

Il s’agit d’un langage de balisage léger, utilisé pour la hiérarchisation des informations.

Incorporer le Markdown dans votre prompt, c’est rendre la structure de votre pensée explicite pour le LLM.

Concrètement, cela revient à transformer un prompt en un document lisible, avec :

  • des titres pour séparer les sections ;
  • des listes pour clarifier les consignes ;
  • des blocs distincts pour isoler un contenu à analyser ;
  • un format de réponse clairement demandé.

Regardez l’image ci-dessous.

En haut, on aura utilisé les marqueurs de niveau de titre que sont les croisillons (« # », « ## »), et les listes ordonnées (à l’aide des tirets « – »).

En bas, on aura utilisé le formatage Markdown propres aux tableaux. Précieux, il permet donc de passer vos tableaux, avec les données qu’ils contiennent, avec 100% de fiabilité à ChatGPT.

représentation du formatage markdown pour les prompts ChatGPT
2 exemples de représentation du Markdown dans un prompt. Au-dessus, on visualise le rendu des titres de sections et des listes à puce. En-dessous, on visualise le rendu des tableaux.

Ainsi, avec le markdown, chaque information est hiérarchisée, et immédiatement identifiable.

Comme dit précédemment, cette différence devient particulièrement visible sur les prompts longs ou multi-consignes. À contenu égal, un prompt structuré donne souvent une réponse plus organisée et plus conforme aux consignes. Le gain sur la qualité d’analyse, lui, dépend du modèle et de la tâche.

C’est précisément ce que plusieurs travaux récents commencent à documenter : le format d’un prompt n’est pas neutre, et peut influencer directement la qualité du résultat.

Pourquoi le formatage d’un prompt peut changer la réponse de l’IA

Si vous avez déjà eu l’impression qu’un prompt “presque identique” donnait une réponse très différente, ce n’est pas qu’une impression.

C’est en réalité un phénomène documenté.

Une étude publiée en 2024, intitulée « Does Prompt Formatting Have Any Impact on LLM Performance? », s’est concentrée sur le test du formatage de prompts. Dans cette étude, chaque prompt testé dispose d’un contenu strictement identique : mêmes instructions, même contexte, mêmes exemples, même demande.

Seule la structure change, et est testée à l’aune de 4 formatages différentes :

  • prompt en texte brut,
  • en Markdown,
  • en JSON,
  • et en YAML.

Concrètement, les chercheurs ont comparé plusieurs façons d’organiser un même prompt.

Les informations restaient strictement identiques (instructions, contexte, exemples, format attendu), mais leur présentation changeait selon le format utilisé.

Dans ces conditions, les performances du modèle ont varié de manière significative. Dans certains cas, l’écart pouvait atteindre jusqu’à 40 %, uniquement en modifiant la manière dont l’information était structurée.

Ce chiffre ne signifie pas que le Markdown améliore tous les prompts de 40 %. Il montre surtout que le format d’un prompt peut devenir une variable de performance à part entière.

À contenu égal, un prompt ne produit pas toujours la même réponse.
Le format influence la manière dont le modèle interprète la demande.

Pourquoi ?

Parce qu’un modèle de langage ne lit pas un prompt comme un humain.
Si vous ne structurez pas votre demande, il doit inférer :

  • ce qui est une consigne ;
  • ce qui est du contexte ;
  • ce qui doit être analysé ;
  • et ce que vous attendez en réponse.

Lorsque tout est mélangé dans un seul bloc, cette interprétation repose sur des indices implicites. Elle devient donc plus fragile.

L’étude précise qu’il n’existe pas de format universellement supérieur. Selon les tâches, JSON ou YAML peuvent parfois mieux fonctionner. Les modèles récents sont également plus robustes, ce qui réduit, mais ne supprime pas, l’impact du format.

Autrement dit, structurer un prompt, ce n’est pas simplement le rendre plus lisible.
C’est réduire les zones d’interprétation.

Pourquoi le Markdown est le meilleur compromis pour les non-développeurs

Un langage simple à comprendre et à utiliser

Le constat semble à présent posé : le format de votre prompt peut influencer la qualité ou la conformité de la réponse.

La question qui suit devient donc : quel langage de formatage utiliser ?

En théorie, plusieurs options existent. JSON, YAML ou XML permettent de structurer très précisément un prompt. Et dans certains cas, ils peuvent même produire de meilleurs résultats.

Mais en pratique, ces formats ont une limite évidente : ils demandent de la rigueur, du temps, et une certaine habitude technique.

À l’inverse, le texte brut est simple à écrire… mais devient vite difficile à lire dès que le prompt se complexifie.

C’est exactement à cette intersection que le Markdown trouve sa place, car il coche 2 cases.

Il est :

  • suffisamment structuré pour clarifier l’information,
  • et suffisamment simple pour être utilisé au quotidien.

Un langage aligné avec la manière dont les modèles interprètent l’information

Et le Markdown n’est pas seulement un compromis pratique.

Une recherche très récente sur le sujet, datant de mars 2026, apporte un éclairage intéressant sur ce point.

Elle défend l’idée que les modèles de langage ne se contentent pas d’apprendre des mots ou des phrases : ils internalisent aussi des régularités de structuration issues de leurs données d’entraînement.

Or, une part importante des contenus de référence utilisés pour entraîner ces modèles (comme par exemple de la documentation technique, des bases de code ou des contenus pédagogiques en tout genre) est structurée en Markdown.

Résultat : les modèles ne se contentent pas de reconnaître cette structure.
Ils semblent particulièrement familiers avec ce type de structuration documentaire.

C’est ce qui explique un comportement bien connu : même sans instruction explicite, les LLM ont tendent naturellement vers des réponses très structurées, avec des titres, des listes, ou des blocs bien séparés.

Les modèles de langage produisent spontanément des réponses structurées : titres, listes, blocs séparés. Le Markdown s’inscrit dans cette logique documentaire.

Exemple : prompt brut vs prompt structuré en Markdown

Jusqu’ici, on a vu que :

  • le format d’un prompt peut influencer la qualité, la structure ou la conformité des réponses,
  • les LLMs sont très familiers de ce type de structuration car il est partie intégrante de leurs données d’entraînement,
  • le Markdown est un bon compromis pour structurer sans complexité pour l’utilisateur,
  • le formatage se révèle davantage utile sur les tâches complexes

Il est maintenant temps d’observer la différence d’exécution en testant une tâche complexe formulée en texte brut et linéaire, vs. la même tâche structurée en Markdown.

Ce test sera réalisé à l’aide d’OpenRouter*, sur trois modèles récents :

  • GPT-5.4 mini
  • Gemini 3.1 pro Preview
  • Claude Haiku 4.5

La tâche consiste à analyser une page de service d’une agence web : identifier, classer et évaluer les éléments clés selon une nomenclature précise, avec une contrainte de priorisation des éléments les plus structurants, et (15 éléments max) et d’identification de 5 éléments manquants notables.

L’évaluation basée sur la discipline d’exécution, la qualité d’analyse et la conformité au format attendu.

*Vous pouvez accéder aux chats de tests en suivant ce lien.

GPT-5.4 mini — comparaison

Format du promptScoreRespect consignesPriorisationFormat de sortieLecture globale
Linéaire36/45Non (16 éléments)BonneCorrectSélection un peu redondante
Markdown40/45Oui (15 éléments)MeilleureTrès proprePlus structuré et mieux équilibré

Observation : avantage clair du Markdown → meilleure discipline et meilleure sélection.

Gemini 3.1 Pro Preview — comparaison

Format du promptScoreRespect consignesPriorisationFormat de sortieLecture globale
Linéaire38/45Oui (13 éléments)Très bonneBonLecture stratégique forte
Markdown39,5/45Oui (14 éléments)Très bonneTrès proprePlus complet et mieux réparti

Observation : quasi-égalité → Markdown plus structuré, linéaire plus intuitif.

Claude Haiku 4.5 — comparaison

Format du promptScoreRespect consignesPriorisationFormat de sortieLecture globale
Linéaire38/45OuiTrès bonneCorrectAnalyse plus riche
Markdown38/45OuiBonneTrès proprePlus conforme, un peu moins dense

Observation : égalité → arbitrage entre richesse (linéaire) et discipline (Markdown).

Tableau final

ModèleScore linéaireScore MarkdownMeilleur formatÉcartCe qu’il faut retenir
GPT-5.4 mini36/4540/45Markdown+4Meilleure discipline et meilleure priorisation
Gemini 3.1 Pro Preview38/4539,5/45Markdown (léger)+1,5Structuration meilleure, analyse équivalente
Claude Haiku 4.538/4538/45Égalité0Linéaire plus riche, Markdown plus conforme

Le résultat ne valide donc pas l’idée d’un Markdown “magiquement supérieur”. Il montre plutôt un effet plus précis : sur cette tâche, le Markdown améliore surtout la discipline d’exécution. La qualité d’analyse reste dépendante du modèle.

Observations globales

  • Le Markdown améliore clairement la discipline d’exécution (respect des consignes, structure, format).
  • Le gain sur la qualité d’analyse est modéré et variable selon le modèle.
  • Le prompt linéaire conserve parfois une lecture plus intuitive et plus stratégique.

Quand utiliser le Markdown dans vos prompts (et comment vous y mettre sans perdre de temps)

Avant de partir, retenez bien ceci : le Markdown n’est pas une technique miracle.
Il ne va pas améliorer tous vos prompts. Non, son intérêt apparaît lorsque la structure devient un facteur de qualité.

Alors, quand devez-vous structurer votre prompt en markdown, et quand cela n’est-il pas nécessaire ?

Le signal d’alerte est simple : il réside dans votre capacité à juger ce que vous demandez à l’IA. Si vous estimez que ce que vous vous apprêtez à lui demander est assez complexe, vous avez probablement intérêt à structurer votre premier prompt avec du Markdown.

Quand le Markdown est vraiment utile

Dans la pratique, son intérêt devient surtout visible sur des prompts comme :

  • un texte à analyser ou à améliorer (que l’on peut ainsi convertir en Markdown pour conserver toute la finesse de sa mise en page)
  • un brief rédactionnel
  • un audit (SEO, contenu, UX…)
  • une demande avec plusieurs consignes
  • un prompt cadre que vous réutilisez régulièrement
  • une réponse attendue sous un format précis (liste, tableau, plan…)

👉 Dans tous ces cas, le modèle doit gérer plusieurs couches d’information.
C’est là que la structure a le plus de chances de faire la différence.

Quand il est moins nécessaire

À l’inverse, le Markdown apporte peu de valeur sur :

  • une question simple
  • une demande courte
  • une instruction directe
  • une génération rapide d’idées

👉 Ici, le gain est marginal. Le prompt est déjà lisible.

Comment commencer sans complexifier

Bonne nouvelle : vous n’avez pas besoin de maîtriser tout le Markdown pour en tirer un bénéfice.

Quelques réflexes suffisent. Pour commencer, consultez le guide du markdown pour comprendre comment baliser correctement vos prompts, et retenir les pratiques les plus utiles au quotidien.

Et de manière générale :

  • séparez votre prompt en sections avec des titres (représentés avec les croisillons « ## »)
  • organisez vos consignes sous forme de listes (représentés avec les tirets « -« )
  • isolez clairement un texte à analyser (en le mettant à la fin du prompt, après des délimiteurs)
  • utilisez des sections dédiées pour cadrer la réponse attendue (exemple : # CONTEXTE, # CONTRAINTES + délimiteurs)

Sans oublier évidemment de respecter les principes élémentaires du prompting, tels que :

  • donner suffisamment de contexte pour orienter la réponse
  • formuler une consigne claire et sans ambiguïté
  • vérifier les réponses dès qu’un doute apparaît

Pour aller plus loin

Si vous voulez aller plus loin sur le sujet du prompt engineering et du Markdown :

👉 Inspirez-vous de notre Bibliothèque de prompts IA pour partir de cas concrets

👉 Consultez notre Guide du Markdown pour prompter l’IA pour maîtriser les bases

👉 Utilisez notre Convertisseur texte Markdown pour formater rapidement vos prompts

👉 Consultez notre Aide-mémoire sur le prompt engineering pour avancer avec des techniques performantes

Créer sa stratégie de content marketing avec l’IA : méthode + prompts

Créer sa stratégie de content marketing avec l’IA : méthode + prompts

En 2026, le content marketing est dominé par un paradoxe : produire du contenu n’a jamais été aussi simple, rapide et peu coûteux grâce à l’IA. Mais cette accessibilité a pour conséquence d’augmenter le bruit numérique : il devient plus difficile d’être trouvé. Et encore plus difficile de capter l’attention et de convaincre.

Dans ce contexte, le défi des équipes éditoriales ne consiste plus seulement à produire des contenus de qualité. Cette exigence est devenue un standard.

Ce qui fait désormais la différence, c’est la capacité à publier des contenus structurés et incarnés, riches en informations vérifiables et utiles à la prise de décision. Leur valeur doit aussi être immédiatement lisible, aussi bien pour les utilisateurs que pour les moteurs de recherche et les modèles d’IA.

Continuer à produire sans revoir sa stratégie éditoriale revient finalement à amplifier le bruit plutôt qu’à créer de la valeur.

C’est dans cette optique que s’inscrit cet article, avec une méthode en 8 étapes pour structurer des contenus réellement performants, de l’intention de recherche jusqu’au brief éditorial !

Pourquoi structurer sa stratégie de contenu change tout

Depuis qu’elle est capable de se connecter au web en temps réel pour chercher de l’information, l’intelligence artificielle a complètement redistribué les cartes du référencement.

Dans ce nouveau cadre de production, élaborer une stratégie éditoriale vous servira d’abord à filtrer :

  • les sujets sans potentiel,
  • les angles déjà saturés,
  • et tous les contenus qui n’apportent rien de plus que l’existant.

Car, comme l’a théorisé Mark Schaefer en 2014, nous avons peut-être bien atteint le « Content Shock« . A savoir que le nombre de contenus disponibles sur le web augmente aujourd’hui de manière exponentielle, là où le temps d’attention humain reste une ressource finie et non extensible.

Un tri s’impose, donc.

Et en 2026, ce filtrage devient critique. Les moteurs comprennent mieux les intentions des utilisateurs, les contenus se multiplient, et les réponses sont de plus en plus synthétisées. Seuls les contenus éditoriaux bien positionnés, réellement utiles et immédiatement exploitables émergent.

Structurer sa stratégie, c’est donc reprendre le contrôle sur trois points :

  • ce qui mérite d’être produit,
  • la manière dont le contenu se différencie,
  • et sa capacité à délivrer concrètement de la valeur à son lecteur.

Le triptyque de la stratégie éditoriale sur le web

Triptyque strategie content marketing

1. Intention : confronter l’idée de contenu à la réalité du marché

On ne choisit pas un sujet parce qu’il “semble intéressant”, on le valide parce qu’il correspond à une demande réelle.

  • Lecture systématique de la SERP : formats de contenu dominants, profondeur (débutant, intermédiaire, expert), angles déjà exploités
  • Identification de l’intention principale et des attentes implicites
  • Refus des sujets sans potentiel (trafic, conversion ou autorité)

2. Angle : rendre le contenu défendable

Un contenu sans angle est interchangeable. Donc inutile.

  • Positionnement clair : méthode, retour terrain, grille d’analyse
  • Arbitrage : ce qu’il faut garder, ce qu’il faut supprimer, ce qu’il faut renforcer
  • Refus du consensus mou (le contenu est correct, mais rapidement oubliable)

3. Exécution : produire du contenu exploitable

  1. Structurer pour délivrer : plan construit pour répondre vite, hiérarchie lisible, lecture en scan + lecture approfondie possible
  2. Rendre le contenu actionnable : étapes claires, méthodes applicables, citation hooks…
  3. Industrialiser sans dégrader : décomposition du travail (analyse, plan, rédaction…), utilisation fine de l’IA, contrôle qualité systématique

Les 8 étapes de la méthode en 1 coup d’oeil

Voici les 8 étapes par lesquelles nous allons passer pour cocréer une stratégie éditoriale SEO data-driven, priorisée et alignée avec les ressources et objectifs de notre entreprise.

schéma stratégie content marketing avec l'IA_Arnaud Anselmet

Quelle IA utiliser pour maximiser la réussite de cette méthode ?

L’IA la plus performante parmi les tests menés sur les 3 IA dominantes du marché (Gemini, Claude, ChatGPT) s’est révélée être ChatGPT 5.3.

Combien de temps faut-il pour appliquer cette méthode ?

Soyons honnêtes, cette méthode est ambitieuse car elle permet de fixer le cadre et la direction de vos contenus « édito », mais également de descendre jusqu’à la granularité du brief d’article.

En définissant correctement vos variables contextuelles (cf. étape 1 ci-dessous et exemple fourni au chapitre « La méthode en action« ), ce premier cycle vous prendra environ 45-60 minutes à exécuter.

Ensuite, il vous suffira de répéter les étapes 4 à 8 pour obtenir les briefs des articles suivants, et les ajouter progressivement dans votre calendrier éditorial (créé à l’étape 3).

Étape 1 – Trouver des idées d’articles réellement exploitables

Soyons clairs : lorsqu’on est un professionnel du marketing ou de la communication, trouver des sujets d’article autour de son activité ne représente pas une difficulté insurmontable. Au contraire, les idées d’articles émergent souvent naturellement dans le quotidien d’une entreprise.

Le problème n’est pas le manque d’idées, mais le manque d’alignement de ces idées avec les attentes réelles des utilisateurs.

L’IA peut fortement vous aider dans cette phase de réflexion, et la première étape de cette méthode est pensée dans ce sens.

Ici, vous allez commencer par :

  • faire émerger des questions concrètes que se posent vos prospects
  • puis les transformer en angles éditoriaux structurés.

⚠️ IMPORTANT !

Dans ce prompt, l’élément clé est la précision de vos variables de contextes. Plus elles seront fournies et précises, plus elles conditionneront la qualité des recommandations de l’IA sur l’ensemble du processus.

Les variables que vous devez personnaliser sont identifiées [entre crochets et surlignées en orange] dans chaque prompt.

Besoin d’inspiration pour remplir vos variables ? Cliquez ici pour consulter notre exemple.

Étape 1 – Utilisez le prompt suivant :

Agis comme un consultant SEO éditorial senior.

Contexte :
- Audience cible de l'entreprise : [décrire précisément]
- Problématique principale de la cible : [décrire]
- Objectif business : [lead, branding, conversion, etc.]
- Détail de l'offre : [décrire services / produits de l'entreprise]

Étape 1 : 
Liste les questions que se pose réellement cette audience face à cette problématique.

Contraintes :
- 15 à 25 questions maximum
- questions concrètes, formulées comme dans la tête d’un utilisateur
- éviter les généralités

Étape 2 :
Regroupe ces questions en grandes intentions de recherche (3 à 5 maximum).

Étape 3 :
À partir de ces intentions, propose 8 à 12 idées d’articles.

Pour chaque idée :
- titre proposé
- intention principale ciblée
- angle éditorial (ce que l’article fait mieux que les autres)
- type de contenu si pertinent (guide, comparatif, méthode…), sans forcer

Contraintes :
- pas de titres génériques
- éviter les redites
- chaque sujet doit être exploitable tel quel

Vous voulez accélérer la production de vos contenus avec l’IA, sans perdre en qualité (ni en visibilité) ?
Discutons-en ! 💬.

Étape 2 – Prioriser et sélectionner les sujets à produire

Vous disposez à présent d’une première liste de sujets qui se positionnent à la croisée des chemins entre vos objectifs commerciaux/marketing, et les attentes des utilisateurs. Il est temps de faire le tri pour hiérarchiser les sujets avec le plus fort potentiel de réussite.

Dans ce prompt, l’élément clé est l’analyse de faisabilité en regard du niveau d’autorité de votre site et de vos capacités de production. Cela vous permet d’obtenir des suggestions de contenus prioritaires vraiment intéressants, et réalistes.

Conseil pour cette étape : utilisez le mode « Thinking » ou « Recherche Approfondie » sur votre IA préférée, les recommandations n’en seront que meilleures.

Étape 2 – Utilisez le prompt suivant :

Très bien, voici d'autres éléments de contexte.

Contexte :
- Niveau d’autorité du site : [donner une métrique de type "Domain Rank" si possible. Sinon, graduer : faible / moyen / élevé]
- Ressources disponibles pour ce projet : [temps, équipe, etc.]

Repars de la liste d'idées d'article que tu viens de fournir.

1. Évalue chaque sujet selon 3 critères :
- Potentiel SEO (volume + intention)
- Valeur business (capacité à générer leads / ventes / image)
- Faisabilité au regard de l'équipe disponible et de l'autorité du site (vs. difficulté potentielle du mot-clé visé)

2. Attribue pour chaque critère une note de 1 à 5.

3. Calcule une priorité globale et classe les sujets.

4. Propose :
- un TOP 3-5 prioritaire à produire immédiatement
- un TOP 3-5 secondaire à produire ensuite
- les sujets à écarter (si pertinents), avec justification
Pour chaque sujet sélectionné dans les 2 tops, tu fournis le mot-clé principal ciblé (assure-toi de la pertinence du mot-clé comme formulé par l'utilisateur et du volume de recherche substantiel). Tu fournis l'ensemble de cette 4e étape dans un tableau prêt à copier-coller.

Contraintes :
- sois synthétique
- évite les justifications vagues
- privilégie la prise de décision rapide

Étape 3 – Planifier vos contenus avec une logique SEO

Ca y est, vos thématiques principales sont sorties.

Cette nouvelle étape va vous permettre de les organiser proprement en un calendrier éditorial.

Cette organisation dépend de plusieurs variables :

  • Quelle est la période de publication visée (sur combien de temps prévoyez-vous la diffusion de ces contenus) ?
  • Quel est le rythme de publication ?
  • Y a-t-il des contenus plus complexes à produire ?
  • Certains contenus dépendent-ils d’autres contenus pour exister ?

Conseil : là-aussi, utilisez le mode « Réflexion » de votre IA générative, pour obtenir une articulation la plus intelligente possible. Spoiler : vous aurez sans doute des retouches à faire à la main, mais la base est solide ! Par ailleurs, vous pouvez ajouter une consigne du type « Livrable : Tableur Excel prêt à l’emploi » si vous souhaitez exporter ce tableau dans un fichier Excel.

Étape 3 – Utilisez le prompt suivant :

A présent, enfile ta casquette de content strategist senior. Voici d'autres éléments de contexte pour construire un calendrier éditorial.

Contexte :
- Rythme de publication souhaité : [ex : 1 contenu tous les 3 jours]
- Période : [ex : 1 mois]

Voici la liste des sujets priorisés :
[copier-coller tableau "Priorisation" de l'étape 2 avec niveaux de priorité prioritaire/secondaire]

Ta mission :

1. Analyse les sujets en Tops prioritaires et secondaires et valide leur niveau de complexité (faible / moyen / élevé).

2. Identifie les dépendances éventuelles :
- contenus qui doivent être publiés avant d’autres
- contenus piliers vs contenus complémentaires

3. Propose un calendrier éditorial structuré :
- dates de publication
- ordre logique de diffusion (pas uniquement chronologique)
- respect du rythme imposé

4. Pour chaque contenu :
- indique la date de lancement de production
- précise brièvement la logique de positionnement
- rappelle le mot-clé principal visé

Contraintes :
- calendrier lisible et synthétique
- pas de complexité inutile
- logique SEO visible

Étape 4 – Analyser la SERP et cadrer l’intention de recherche

C’est bon, vos sujets sont sélectionnés et organisés par ordre d’importance.

A partir de cette étape, on descend d’un cran et on passe au niveau de l’article, pour préparer le bon cadrage SEO qui transformera chaque sujet en un brief clair et optimisé, document indispensable pour la rédaction.

Ce qui compte ici, c’est de comprendre ce que Google attend réellement.

Avant de rédiger, vous devez estimer, pour votre futur article :

  • l’intention dominante
  • les angles déjà exploités
  • les failles à exploiter

Pour ce faire, il faut travailler directement depuis les résultats de recherche (appelés aussi « SERP »).

Dans ce prompt, l’élément clé est le détail des captures d’écran de la SERP que vous allez donner à l’IA, en plus du prompt. Je vous recommande de « screenshotter » séparément les différents emplacements intéressants sur la SERP (liens organiques, bloc PAA, bloc vidéos, refinement chips, recherches associées…).

Exemple :

Je prends donc le mot-clé principal du premier article du calendrier éditorial qui vient d’être créé, et je le tape dans Google.

Puis je fais un screenshot des différents « SERP features » des résultats de recherche, pour les fournir à l’IA, en complément du prompt ci-dessous.

image

image 9

image 10

Conseil : faites ce travail en navigation privée, pour obtenir une SERP la plus neutre possible.

Étape 4 – Utilisez le prompt suivant :

A présent, reviens dans ton rôle de consultant SEO senior.

On va travailler sur un seul des sujets que tu as priorisés : 
- [citer le 1er sujet du calendrier éditorial (Etape 3.), et son mot-clé associé]

Tu vas analyser la SERP sur le mot-clé principal donné.

Données fournies :
- captures d’écran de la SERP jointes (résultats, PAA, etc.)

Ta mission :

1. Identifie l’intention dominante de la SERP
→ formule-la clairement en une phrase

2. Liste 2 à 4 intentions secondaires fortes

3. Analyse les contenus présents :
- types de contenus majoritaires (guide, tuto, comparatif…)
- angles récurrents

4. Identifie 3 à 5 failles concrètes dans la SERP
→ manques, angles faibles, infos absentes, mauvaise structuration…

5. Propose 3 à 5 opportunités éditoriales directement exploitables
→ une phrase chacune, actionnable immédiatement

Contraintes :
- pas de généralités
- uniquement des constats observables
- réponse courte et structurée

Etape 5 – Définir l’angle éditorial et optimiser le positionnement de l’article

Avec l’étape précédente, vous avez fait travailler l’IA sur de la donnée très utile pour trouver un positionnement SEO cohérent.

A présent, on peut lui demander de réfléchir à des angles performants pour placer votre page en haut des résultats de recherche, sans compromettre les objectifs de votre entreprise.

Étape 5 – Utilisez le prompt suivant :

A présent :

1. Propose 2 à 3 angles éditoriaux possibles.
Pour chaque angle :
- promesse de l’article (ce que le lecteur va concrètement obtenir)
- différenciation par rapport à la SERP
- alignement utile par rapport aux objectifs business spécifiés plus haut

2. Sélectionne le meilleur angle et justifie brièvement.

3. À partir de cet angle, propose 3 titres optimisés SEO.

Contraintes :
- pas de titres génériques
- pas de reformulation superficielle
- chaque angle doit être réellement différenciant
- les titres doivent être directement exploitables

Étape 6 – Construire un plan SEO orienté intention

A cette étape, l’élément clé est la capacité de l’IA à construire un plan aligné sur les intentions les plus fortes des utilisateurs qui cherchent du contenu en tapant la requête cible.

Le plan traitera en priorité la réponse à ces intentions recherche. C’est ce qui fait qu’un bon contenu performe : Google (ainsi que les IA génératives qui se connectent au web) accède sans difficultés à la valeur ajoutée utile pour le lecteur, car les informations les plus importantes sont positionnées en haut du contenu.

Étape 6 – Utilisez le prompt suivant :

A présent : 

1. Choisis le titre le plus aligné et propose un plan de contenu optimisé (H1, H2, H3), ainsi que la longueur cible du contenu à rédiger.

2. Pour chaque partie :
- indique l’objectif du bloc (ce que le lecteur doit comprendre ou obtenir)
- liste les points clés à traiter (concrets, pas génériques)

3. Vérifie :
- que l’intention dominante est traitée dès le début de l’article
- que les intentions secondaires sont intégrées logiquement
- que le plan se différencie des structures classiques de la SERP

Contraintes :
- pas de plan générique
- pas de titres vagues
- structure directement exploitable en rédaction

Étape 7 – Définir le champ sémantique utile

Pour cette dernière étape, on continue à développer le brief de votre futur article. Ici, on cherche à maximiser l’autorité sémantique de votre page, en structurant les mots-clés et les concepts de manière cohérente à travers chaque section de votre plan.

Conseil : effectuez les étapes 3 à 7 pour chaque contenu prioritaire. Le tableau final de l’étape 7 agit comme un brief prêt à l’emploi pour la rédaction. Ensuite, passez-le à vos rédacteurs en y ajoutant les éléments éditoriaux propres à votre entreprise (tone of voice, contraintes de rédaction, iconographie, pages internes à mailler, CTA…).

Étape 7 – Utilisez le prompt suivant :

A présent : 

1. Identifie les termes et expressions indispensables pour couvrir correctement le sujet. Agis en connaissance du fonctionnement actualisé des algorithmes Google Search pour la compréhension du langage naturel.

2. Organise-les en 3 catégories :
- Termes essentiels (indispensables pour le SEO)
- Termes de précision (pour enrichir et crédibiliser)
- Termes complémentaires (secondaires mais utiles)

3. Pour chaque catégorie :
- propose des mots ou expressions (pas de phrases)
- évite les synonymes inutiles

4. Indique comment ces termes doivent être répartis dans le plan :
- quelles sections doivent absolument les intégrer

5. A la fin de l'analyse, récapitule les termes et leur répartition dans le contenu dans un tableau lisible.

Contraintes :
- pas de liste brute sans structure
- pas de sur-optimisation
- privilégier la pertinence à la quantité

Étape 8 – Regrouper toutes les informations (et sortir avec le livrable final)

Arrivé(e) à cette étape, il ne vous reste plus qu’à synthétiser l’ensemble des éléments que vous avez constitué au fil des étapes.

Rappelez-vous, les 3 premières étapes se situent à un niveau stratégique, et vont ont servi à :

  • faire émerger des idées de contenu (étape 1)
  • à les prioriser selon des critères de potentiel SEO, valeur business et faisabilité (étape 2)
  • à les organiser dans un planning éditorial, selon votre temporalité et votre capacité de production (étape 3)

Les 4 étapes suivantes ont quant à elles permis d’entrer dans l’opérationnel, en descendant au niveau « article »:

  • analyse des résultats de la SERP sur le MC visé, et détection des opportunités éditoriales réelles (étape 4)
  • positionnement et titraille du contenu (étape 5)
  • déclinaison d’un plan de contenu aligné, avec objectif et points clés de chaque section (étape 6)
  • déclinaison d’un champ sémantique, avec classement d’importance des expressions et mapping dans les sections concernées (étape 7)

Vous voilà donc avec un brief complet d’article SEO porteur pour votre business, temporalisé, et suffisamment détaillé pour être confié à la personne en charge de la rédaction.

Le livrable final est donc de récapituler tout cela en complétant le calendrier éditorial pour l’article en question.

Étape 8 – Utilisez le prompt suivant :

Maintenant, fournis-moi la ligne du calendrier éditorial qui concerne l'article en question. 

Ajoute-y, dans les colonnes suivantes de celles du tableau actuel : 
- la longueur cible du contenu, comme tu l'as exprimée
- le plan proposé (H1, H2, H3) avec objectifs et points clés (sans perte d'information !) 
- le champ sémantique, en conservant l'organisation demandée

Format de sortie : veille à tout bien fournir dans un tableau prêt à copier-coller, en respectant la structure initiale du calendrier éditorial (que tu as produit plus tôt dans la discussion) et les ajouts demandés ici.

⭐ Livrable final : une ligne de tableau structurée, avec toutes les infos pour déclencher la phase de rédaction

image 14

⚠️ Important :

A présent, il ne vous reste plus qu’à recommencer le processus pour l’article suivant du calendrier éditorial, en reprenant la discussion avec votre IA préférée à partir de l’étape n°4.

La méthode en action : un exemple concret

A. Si vous négligez cette partie, le résultat ne sera pas à la hauteur !

Comme dans tout bon système de production automatisée avec l’intelligence artificielle, la personnalisation est la clé !

L’IA est capable de vous faire un travail sur-mesure exceptionnel. Pour parvenir à un résultat réellement opérationnel, vous devez préparer la matière première que vous allez lui donner.

Cette matière première, que l’on nomme souvent « variables », ce sont les informations entre crochets que vous trouvez dans les prompts prêts à l’emploi du chapitre précédent.

Audience cible, problématique, objectifs business, ressources disponibles, notoriété du site…Autant de données propres à votre entreprise, qui, bien préparées, transformeront drastiquement la qualité et la précision de ses réponses.

Attention : Sans ce contexte, ou avec un contexte appauvri, l’IA se contentera de probabilités statistiques moyennes.

Faites vraiment un effort supplémentaire sur cette phase ! Avec ces variables proprement renseignées, l’IA devient un consultant expert qui connaît vos dossiers sur le bout des doigts.

B. Les variables de notre exemple

Maintenant que cela est dit, restons dans une logique SEO pour notre exemple, avec un cas concret centré sur un marché à fort potentiel : le fitness pour débutants.

Voici les éléments de contexte de notre entreprise fictive, qui souhaite développer sa visibilité éditoriale auprès d’actifs qui veulent se remettre au sport mais peinent à tenir dans la durée.

- Audience cible de l'entreprise : actifs 25–40 ans, plutôt sédentaires, avec peu d’expérience en sport ou en reprise après une longue pause
- Problématique principale de la cible : ils veulent se remettre en forme, mais manquent de régularité, de structure et de repères fiables. Ils cherchent une approche simple, efficace et compatible avec un emploi du temps chargé.
- Objectif business :
 - conversion directe (achat de programmes fitness)
 - vente de produits complémentaires (équipements à domicile)
 - construction d’une base email qualifiée (lead magnets type programmes gratuits)
- Offre / modèle de l’entreprise :  
  - produit d’entrée : programmes fitness en ligne (PDF / app) orientés débutants (perte de poids, remise en forme, routines 20 min)  
  - produit principal : programmes premium (8 à 12 semaines) avec suivi structuré, progression, vidéos explicatives  
  - produits complémentaires : équipements fitness simples (élastiques, haltères, tapis) intégrés dans les programmes  
  - logique de funnel :
    - contenu SEO →  
    - lead magnet (ex : programme gratuit 7 jours) →  
    - vente programme →  
    - upsell équipement 
- Niveau d’autorité du site (métrique type Domain Rank) : 40
- Ressources disponibles : 1,5 ETP (1 CM à mi-temps + 1 rédacteur temps plein)
- Rythme de publication souhaité : 1 contenu par semaine, tous les lundis 
- Période : sur 3 mois

C. Récapitulatif (et illustration) des étapes

Et voici la méthode en action. Je donne les extrais les plus intéressants des réponses de l’IA utilisée (ChatGPT Instant 5.3 / Thinking 5.4).

Étape 1 :

Grâce au prompt de l’étape 1, je reçois : une liste de questions que pourrait vraiment se poser ma cible, les grandes intentions qui découlent de cette liste de questions, et une dizaine d’idées d’articles.

image 15

image 16

image 17

Étape 2 (Modèle de raisonnement « Thinking ») :

Grâce au prompt de l’étape 2, je reçois : une note qui classe les sujets de l’étape 1 en fonction de leur intérêt SEO/Business/faisabilité. Cela me permet de faire émerger les sujets prioritaires, les sujets secondaires et les sujets à écarter.

image 18

Étape 3 (Modèle de raisonnement « Thinking ») :

Grâce au prompt de l’étape 3, je reçois un calendrier éditorial qui organise les articles ainsi proposés selon mes objectifs business (important pour valider la priorité de production), mon rythme de publication et la période de production de l’ensemble de ces contenus. Ici, l’IA gère également l’interdépendance entre les contenus de la liste, pour qu’un contenu pilier soit par exemple publié avant un contenu de soutien.

image 19

image 20

image 21

image 22

Étape 4 :

Grâce au prompt de l’étape 4, je reçois une analyse fine et contextualisée du potentiel éditorial du mot-clé visé pour le premier article du calendrier à produire. Pour rappel, cette analyse est basée sur l’étude de la SERP sur le mot-clé en question.

image 23

Étape 5 :

Grâce au prompt de l’étape 5, j’obtiens des propositions d’angle alignées sur le positionnement éditorial à adopter pour performer dans la SERP. Puis la recommandation de l’angle le plus prometteur, ainsi que 3 propositions de titre d’article pour cet angle.

image 24

image 26

image 27

Étape 6 :

Grâce au prompt de l’étape 6, je reçois un plan structuré pour mon contenu, avec pour chaque section, les objectifs éditoriaux et les points clés à aborder dans la section. A la suite du plan, quelques éléments d’analyse et de contrôle par rapport aux intentions identifiées dans les étapes précédentes sont également proposés.

image 28

image 29

Étape 7 :

Grâce au prompt de l’étape 7, je viens compléter ce plan avec un champ sémantique utile pour la performance éditoriale du contenu d’un point de vue Algorithme Google.

image 30

Étape 8 :

Grâce au prompt de l’étape 8, j’ai l’ensemble des réponses de l’IA qui sont regroupées dans une ligne de mon calendrier éditorial. Cette ligne est un brief précis et actionnable pour gérer la production de mon article.

image 31

Mettez cette méthode en pratique !

Voilà, vous avez maintenant une méthode complète qui vous permet de préparer la vision globale et opérationnelle de votre stratégie de contenu SEO en même pas une heure de temps.

Cette méthode sert de socle de départ pour vous permettre d’arbitrer de manière lisible et éclairée les contenus qui ont le plus de potentiel pour informer votre cible tout en faisant rayonner l’expertise de votre marque.

Si vous souhaitez aller plus loin, je peux vous aider à l’appliquer correctement à votre contexte métier, puis à sélectionner les sujets vraiment porteurs pour votre visibilité, et à orchestrer le déploiement opérationnel.

Vous souhaitez accélérer sur votre projet éditorial ?
Discutons-en ! 💬.

Images dans ChatGPT : 9 idées et prompts testés pour les professionnels

Images dans ChatGPT : 9 idées et prompts testés pour les professionnels

À partir d’un texte, d’une photo, d’un croquis ou d’éléments de marque, ChatGPT sait, depuis mars 2025, composer un visuel, y intégrer du texte et appliquer des retouches successives de manière très fiable.

Mais ces résultats sont-ils vraiment exploitables dans un cadre professionnel ?

Pour répondre à cette question, j’ai testé le dernier modèle de génération d’image d’OpenAI sur 9 cas concrets. Pour chacun, vous trouverez le prompt exact, le résultat mon analyse sur le respect des consignes, l’intérêt professionnel du visuel et ses limites. Le neuvième essai pousse la création plus loin avec une composition complexe destinée à un salon professionnel.

Là où les modèles précédents brillaient sur des visuels “artistiques” ou “conceptuels”, cette version de ChatGPT, la plus récente à ce jour (appelée ChatGPT Images 2.5), met l’accent sur l’utilité concrète des visuels pour communiquer, expliquer, structurer l’information.

➡️ Dans cet article, découvrez 9 super idées pour exploiter cette nouveauté et enrichir visuellement vos contenus : miniature Youtube, Infographie, Visuel produit…

ChatGPT est-il devenu le meilleur générateur d’images ?

La nouvelle génération d’images dans ChatGPT, propulsée par gpt-image-2.5-sunburst et gpt-image-2.5-flare, représente un tournant majeur. La révolution visuelle a vraiment démarré avec la sortie de GPT-4o Image Generation en mars 2025.

Là où les anciennes versions peinaient à suivre des consignes précises, ce modèle était capable de comprendre des instructions complexes et de produire des images d’une grande fidélité.

L’une des avancées les plus frappantes de l’époque concernait la gestion du texte. Jusque-là, les IA génératives avaient beaucoup de mal à intégrer du texte lisible dans une image. A l’époque GPT-4o a vraiment changé la donne : les images générées pouvaient détenir des mots nets, bien intégrés à la composition, et exploitables dans un cadre professionnel (infographies, visuels réseaux sociaux, slides…).

Ce que GPT-4o savait déjà faire en 2025

En mars 2025, j’avais utilisé GPT-4o Image Generation pour créer cette frise chronologique et la mettre en scène devant les locaux de Google. Le modèle parvenait déjà à gérer beaucoup de texte et une composition sur mesure, mais plusieurs allers-retours avaient été nécessaires pour corriger les erreurs et stabiliser le résultat.

Exemple d'image qu'on peut créer avec le nouveau ChatGPT
Exemple de visuel professionnel sur-mesure que vous pouviez déjà créer avec les premières versions de ChatGPT Images

Images dans ChatGPT : quoi de neuf avec le modèle de septembre 2026 ?

Entre mars 2025 et aujourd’hui, OpenAI a surtout travaillé à rendre la génération d’images plus fiable et plus contrôlable. GPT Image 1.5 a amélioré le respect des consignes, le rendu des textes denses et la précision des retouches. Avec Images 2.0, ChatGPT a encore progressé sur le réalisme, la compréhension des scènes complexes et la capacité à préparer une image avant de la générer.

La dernière évolution, ChatGPT Images 2.5, va encore plus loin, et surtout sur un point déterminant : la stabilité.

Le modèle préserve mieux les sujets et les éléments d’une image de référence, modifie plus facilement un détail sans toucher au reste et conserve davantage les choix réalisés au fil des retouches successives. Les textures et les éclairages gagnent également en naturel.

Autrement dit, la question a changé. Il ne s’agit plus seulement de savoir si ChatGPT sait produire une image qualitative à partir d’un prompt. Peut-on désormais lui confier la création d’un véritable visuel professionnel ?

Peut-on vraiment créer des visuels professionnels avec ChatGPT ?

Oui, pour de nombreux usages, à condition de garder un contrôle sur le résultat. ChatGPT sait désormais suivre un brief précis, exploiter une image de référence, intégrer du texte et appliquer des modifications ciblées sans systématiquement refaire tout le visuel.

On peut par exemple importer une photographie de produit, changer uniquement son environnement tout en conservant son apparence, puis modifier un texte ou un élément de la composition sans refaire entièrement le visuel. Le modèle est également meilleur pour maintenir ces choix au fil de plusieurs retouches successives.

Cette évolution ouvre des usages beaucoup plus concrets : visuels publicitaires, illustrations d’articles, publications pour les réseaux sociaux, infographies, présentations, déclinaisons d’un produit ou premières propositions de direction artistique. Les arrière-plans transparents et les compositions complexes sont également mieux gérés.

Les limites n’ont pas disparu pour autant. ChatGPT n’est pas devenu Photoshop, Illustrator ou Figma. Certaines retouches peuvent encore entraîner des changements non demandés, les alignements restent parfois approximatifs et le photoréalisme varie selon les scènes. Pour comparer ces résultats à ceux d’un autre modèle très performant, mon comparatif entre ChatGPT Images et Nano Banana vous aidera à choisir entre les principaux outils.

À retenir

Depuis GPT-4o Image Generation, ChatGPT a surtout progressé sur le respect des consignes, la retouche ciblée et la stabilité des images au fil des modifications. Avec GPT Image 2.5, il devient crédible pour de nombreux usages visuels professionnels, même si une vérification humaine reste absoluement nécessaire.

Quel type de « créa » peut-on confier à ChatGPT Images 2.5 ?

ChatGPT Images 2.5 peut être utilisé pour créer ou retoucher plusieurs types de visuels professionnels :

  • Visuels pour les réseaux sociaux : posts LinkedIn, carrousels, publications Instagram, miniatures YouTube.
  • Créations publicitaires : bannières, affiches, flyers, visuels de campagne ou hero images de landing page.
  • Visuels produits : mise en situation d’un produit, changement de décor, variation d’ambiance ou création d’un visuel de catalogue.
  • Illustrations éditoriales : images d’articles, couvertures de dossiers, concepts visuels ou illustrations explicatives.
  • Infographies : schémas simples, comparatifs, visualisation d’un processus ou mise en forme d’informations clés.
  • Supports de présentation : illustrations de slides, concepts visuels, maquettes ou compositions destinées à une présentation commerciale.
  • Retouches d’images existantes : suppression ou ajout d’éléments, modification d’un arrière-plan, changement de couleur ou correction localisée.
  • Déclinaisons d’une création : adaptation d’un même visuel à plusieurs formats, langues, messages ou contextes.
  • Prototypage créatif : transformation d’un croquis, d’une photo ou d’une idée en première proposition visuelle.

Pour aller plus loin, j’ai également recensé 32 idées de visuels à créer avec ChatGPT Images, avec des exemples couvrant des usages éditoriaux, commerciaux et créatifs.

Dans les tests qui suivent, les prompts utilisés permettent de fixer le contenu de l’image, la composition et les éléments à préserver. Chaque résultat est évalué selon trois critères :

  • respect du prompt,
  • utilité réelle,
  • principale limite.

9 idées de visuels à créer avec ChatGPT pour les professionnels

🟢 1. Créer une infographie pour expliquer un processus

Les séquences logiques ou narratives sont particulièrement adaptées à une mise en image sous forme d’infographie. On peut représenter visuellement un processus, un cheminement ou une évolution, de façon claire et synthétique.

Voici un exemple d’infographie qui explique comment décliner un webinaire en cinq contenus marketing.

▶ Voir le prompt utilisé

Crée une infographie professionnelle verticale au format 4:5, destinée aux responsables marketing B2B.

Titre exact : « Un webinaire –> cinq contenus à publier ».

En haut, représente un webinaire enregistré. Fais partir de cet élément cinq branches clairement reliées à cinq blocs :

  • « Article de blog » — « Développer les idées principales »
  • « Carrousel LinkedIn » — « Partager les enseignements clés »
  • « Newsletter » — « Présenter une idée et inviter à approfondir »
  • « Courte vidéo » — « Diffuser un passage marquant »
  • « FAQ » — « Répondre aux questions du public »

Adopte une direction graphique éditoriale contemporaine : fond ivoire, bleu profond, accent orange, typographie sans empattement, illustrations sobres et composition aérée. Distingue nettement le titre, les cinq formats et leurs descriptions. Le résultat doit rester lisible sur mobile.

Reproduis exactement les textes fournis, sans ajout. Évite les robots, les effets futuristes, les dégradés décoratifs et l’apparence d’un modèle bureautique générique.

nfographie montrant comment décliner un webinaire en article de blog, carrousel LinkedIn, newsletter, courte vidéo et FAQ

Analyse

Les cinq formats et leurs descriptions sont correctement reproduits dès la première génération. Le résultat est propre, mais les choix graphiques restent discutables : le mot « cinq » est mis en orange sans raison évidente et les descriptions deviennent petites sur mobile. J’attendais aussi une véritable flèche dessinée à la place de « –> » ; ma consigne de reproduire exactement le titre pouvait toutefois encourager cette lecture littérale. Cet essai fournit une base exploitable, mais la direction artistique mérite encore d’être affinée.

🟢 2. Créer une slide de carrousel LinkedIn

Cette slide de carrousel LinkedIn présente trois questions à se poser avant d’automatiser ses contenus. Elle doit associer une illustration à une identité graphique affirmée, tout en restant lisible sur téléphone.

▶ Voir le prompt utilisé

Crée une slide de carrousel LinkedIn verticale 4:5 pour une agence de stratégie éditoriale B2B.

Textes exacts, sans ajout :

  • « Avant d’automatiser vos contenus »
  • « Trois questions à clarifier »
  • « 01 — À qui parle-t-on ? »
  • « 02 — Qu’a-t-on à apporter ? »
  • « 03 — Que faut-il vérifier ? »

Direction artistique : fond bleu nuit, typographie blanc cassé, accents corail et bleu électrique. Compose une véritable affiche éditoriale : titre puissant en haut, illustration centrale expressive, puis trois questions clairement organisées dans la partie basse.

L’illustration représente un atelier miniature de fabrication de contenus : des feuilles imprimées traversent une machine sculpturale, avec trois interventions humaines visibles — orienter, enrichir et vérifier. Associe volumes en papier découpé, matières mates et ombres précises. Intègre cette scène au fond, sans cadre, avec une perspective cohérente et une palette strictement maîtrisée.

Utilise une typographie sans empattement et réserve le corail aux numéros et aux points d’intervention. Préserve une lecture facile sur téléphone : l’illustration enrichit le propos sans réduire les questions à des légendes minuscules.

Évite les robots, les engrenages, les pictogrammes génériques et les effets néon. Produis une seule slide.

Images dans ChatGPT : Slide LinkedIn présentant trois questions avant d’automatiser ses contenus, illustrée par un atelier miniature de fabrication de documents.

Analyse

Le résultat fonctionne : les textes sont correctement reproduits, les questions restent lisibles et l’illustration donne une identité graphique à la slide. Quelques finitions mériteraient toutefois une reprise, notamment l’alignement des tirets entre les numéros et les questions. Le corail s’étend également aux tirets et à un disque décoratif, alors qu’il était réservé aux numéros et aux « points d’intervention ». Cette dernière consigne manquait de précision dans mon prompt. L’atelier évoque bien la fabrication de contenus, mais les trois interventions demandées ne se distinguent pas toutes clairement. Une proposition visuelle exploitable, avec encore des ajustements de mise en page.

🟢 3. Transformer une photo de produit en visuel de landing page

Ici, le point de départ est une simple photo de produit. ChatGPT doit la transformer en visuel de landing page, réserver un espace pour le titre et le bouton du site, puis appliquer deux retouches précises : retirer le cordon de l’étiquette et redresser la languette d’une chaussure.

Le point de départ est une simple photo de produit. ChatGPT doit la transformer en visuel de landing page, réserver un espace pour le titre et le bouton du site, puis appliquer deux retouches précises : retirer le cordon de l’étiquette et redresser la languette d’une chaussure.

Photo fournie à ChatGPT

Photo originale d’une paire de chaussures blanches et noires posée sur une surface en bois, avec un cordon d’étiquette accroché aux lacets.

Première génération

▶ Voir le prompt de génération

À partir de la photo jointe, crée un visuel publicitaire horizontal 16:9 pour le haut d’une landing page consacrée à cette paire de chaussures.

Conserve fidèlement le produit : silhouette, proportions, couleurs, matières, coutures, lacets, semelle et éventuel logo. N’invente aucun détail et garde un angle de vue proche de la référence.

Direction artistique : photographie de campagne sportive haut de gamme. Place la paire de chaussures dans la moitié droite, sur un socle minéral sombre à la surface légèrement humide. Utilise un éclairage latéral précis pour révéler les matières, avec une lumière rasante vert citron en arrière-plan. Le produit doit rester nettement identifiable, sans dominante colorée qui le dénature.

Réserve les 40 % de gauche à un fond sombre et calme, suffisamment uniforme pour accueillir ensuite un titre et un bouton sur le site. N’intègre aucun texte ni bouton dans l’image.

Recherche une composition tendue et asymétrique, des textures réalistes et une ombre de contact crédible. Aucun autre produit, aucun accessoire, aucun effet de lévitation.

Première mise en scène publicitaire de la paire de chaussures sur un socle sombre, avant suppression du cordon et redressement de la languette.

Résultat après retouche

▶ Voir le prompt de retouche

Très bien, mais il faut :

  • supprimer le petit cordon en tissu accroché au lacet de la chaussure du fond, car c’est le cordon de l’étiquette, et je ne veux pas qu’on le voie ;
  • remonter la languette de la chaussure au premier plan, car elle est affaissée en l’état, et c’est moche.

Paire de chaussures blanches et noires sur un socle minéral sombre, avec un éclairage vert citron et un espace libre à gauche pour le texte.
Voyez-vous les subtiles modifications que ChatGPT a parfaitement effectuées ?

Analyse

Le passage de la photo d’origine à ce visuel publicitaire est bluffant. Les chaussures restent reconnaissables et les deux retouches sont convaincantes : le cordon disparaît et la languette est remontée comme demandé. Un léger traitement des chaussures pourrait encore atténuer leur aspect de photo brute. La réserve concerne surtout la stabilité de la scène : après retouche, le cadrage paraît plus serré et le fond plus net, alors que je n’avais demandé aucun changement à ce niveau. Sur cet essai, les corrections ciblées sont réussies, mais le reste de l’image n’est pas conservé à l’identique.

🟢 4. Transformer un croquis en proposition de vitrine

Un croquis suffit-il pour présenter une idée de vitrine à un commerçant ? ChatGPT doit ici conserver l’implantation dessinée tout en donnant forme aux matières, aux couleurs et à l’éclairage.

Croquis fourni à ChatGPT

Croquis de vitrine avec trois sacs sur des socles de hauteurs différentes, un grand disque central et une suspension à gauche.

Résultat généré

▶ Voir le prompt utilisé

Transforme le croquis joint en une visualisation photoréaliste de vitrine pour une boutique de maroquinerie, au format horizontal 16:9, vue de face.

Le croquis définit la composition : respecte la position relative des trois socles, leurs différences de hauteur, les trois sacs, le grand disque en arrière-plan et la suspension en haut à gauche. N’ajoute aucun présentoir ni produit.

Crée une direction artistique de boutique contemporaine : socles en travertin clair, mur en enduit aubergine mat, grand disque en laiton brossé. Les trois sacs sont respectivement en cuir cognac, crème et bordeaux, de gauche à droite. La suspension diffuse une lumière chaude ; un éclairage d’accentuation discret révèle le grain du cuir et les matières.

Recherche une scénographie soignée, des proportions plausibles, des ombres cohérentes et une séparation nette entre les objets. Conserve les espaces vides du croquis : ne remplis pas les zones libres avec des accessoires décoratifs.

Aucun texte, logo, personnage ou reflet de passant. Le résultat doit permettre de présenter cette intention d’aménagement à un commerçant.

Visualisation d’une vitrine de maroquinerie avec trois sacs sur des socles en travertin, un disque doré et une suspension à gauche.

Analyse

Le respect du croquis est bluffant : ChatGPT reprend la position et la hauteur relative des trois socles, le disque central, la suspension et même la forme des rabats dessinés sur les sacs. La proposition est suffisamment convaincante pour matérialiser une intention d’aménagement auprès d’un commerçant. Le photoréalisme n’est cependant pas complet. Les contours évoquent davantage une boîte qu’une véritable vitrine, l’éclairage de la suspension paraît artificiel et les matières des sacs manquent encore de naturel. Le modèle transforme donc très bien une composition sommaire en proposition visuelle, mais ce rendu demanderait encore une reprise pour être confondu avec une photographie réelle.

🟢 5. Relier les caractéristiques d’un produit à ses bénéfices

Ce support commercial doit relier trois caractéristiques techniques d’un fauteuil à leurs bénéfices concrets. L’enjeu porte autant sur la hiérarchie des textes que sur la précision des repères autour du produit.

▶ Voir le prompt utilisé

Crée un visuel commercial vertical 4:5 présentant un fauteuil de bureau ergonomique et trois de ses bénéfices clients.

Titre exact : « Du réglage au confort quotidien »

Reproduis exactement ces trois associations :

  • « Accoudoirs 4D » — « Soulage les épaules »
  • « Assise réglable en profondeur » — « S’adapte à votre morphologie »
  • « Soutien lombaire ajustable » — « Maintient le bas du dos »

Représente un fauteuil de bureau haut de gamme en vue de trois quarts, sur un fond gris ardoise. Utilise trois lignes de repérage fines pour relier précisément chaque caractéristique à la zone correspondante du fauteuil.

Pour chaque repère, distingue clairement la caractéristique technique du bénéfice associé : la première doit apparaître comme une information produit, la seconde comme sa conséquence concrète pour l’utilisateur.

Adopte une direction artistique de catalogue de mobilier professionnel : rendu 3D réaliste, structure noire mate, textile gris chiné, détails orange brûlé, lumière de studio douce et ombres cohérentes. Organise les informations autour du fauteuil sans masquer le produit.

Tous les textes doivent rester lisibles sur téléphone. N’ajoute aucune caractéristique, aucun chiffre, aucun logo, aucun personnage ni décor de bureau.

ChatGPT Images 2.5 : rendu visuel commercial d’un fauteuil de bureau montrant les bénéfices de ses accoudoirs, de son assise et de son soutien lombaire.

Analyse

Le résultat ressemble à une fiche commerciale crédible : les textes sont justes, la hiérarchie entre caractéristiques et bénéfices fonctionne et les repères des accoudoirs et de l’assise désignent précisément les bonnes zones. Celui du soutien lombaire pointe plutôt vers son mécanisme latéral que vers le bas du dossier, ce qui reste compréhensible mais moins exact. Le fauteuil et ses matières sont convaincants. Cet essai montre surtout que ChatGPT sait organiser plusieurs niveaux d’information autour d’un produit sans sacrifier sa lisibilité.

🟢 6. Adapter un visuel dans une autre langue

L’adaptation d’un support à un autre marché ne devrait modifier que ses textes. Je demande donc une version anglaise du visuel précédent, sans changement du produit, des repères ni de l’identité graphique.

▶ Voir le prompt utilisé

Adapte le visuel joint en anglais.

Remplace uniquement les textes français par les textes anglais suivants :

  • « From adjustment to everyday comfort »
  • « 4D armrests »
  • « Relieves shoulder strain »
  • « Adjustable seat depth »
  • « Adapts to your body shape »
  • « Adjustable lumbar support »
  • « Supports your lower back »

Reproduis exactement ces textes, sans ajout. Tu peux adapter les retours à la ligne pour préserver la lisibilité, mais conserve la position et la hiérarchie de chaque bloc.

Garde strictement inchangés le fauteuil, ses proportions, ses matières, ses couleurs, son éclairage, le fond, les ombres, le cadrage et les trois lignes de repérage. Conserve également la typographie, les tailles relatives, le blanc et l’orange du visuel d’origine.

Ne déplace aucun repère et ne recrée pas le produit. Le seul changement demandé concerne la langue des textes.

Version anglaise d’un visuel commercial présentant les réglages et les bénéfices d’un fauteuil de bureau ergonomique.

Analyse

Tous les textes sont correctement traduits et la version anglaise reste immédiatement cohérente avec l’originale. Le fauteuil, les couleurs, les repères et la hiérarchie paraissent presque inchangés au premier regard. La comparaison précise révèle néanmoins que le modèle a recalculé l’ensemble de l’image et de très légères variations touchent les textures, les ombres et le fond. Le résultat convient à une déclinaison de campagne, mais il ne s’agit pas d’une substitution typographique strictement localisée. Pour une charte exigeant une parfaite superposition entre les langues, un logiciel de mise en page resterait nécessaire.

🟢 7. Simuler une modification précise sur une photo

Cette simulation doit aider un client à se projeter avant des travaux. Pour l’exercice, on demande à ChatGPT de n’intervenir que sur deux éléments de la photo : le mur principal et le pot du cactus. L’architecture, les équipements et le reste de la pièce doivent être conservés.

Photographie d’origine

07 source interieur mur clair

Simulation générée

▶ Voir le prompt utilisé

Sur la photographie jointe, modifie uniquement la couleur du mur principal visible, ainsi que le pot de cactus.

Remplace la couleur actuelle du mur par un bleu pétrole profond et mat. Conserve la texture existante du mur ainsi que les variations naturelles produites par la lumière et les ombres.

Respecte précisément les contours du plafond, des murs adjacents, des plinthes, des prises, des interrupteurs, des fenêtres, des cadres et des meubles. Aucun de ces éléments ne doit être recoloré, déplacé, supprimé ou recréé.

Garde strictement inchangés le cadrage, la perspective, le mobilier, le sol, les ouvertures, l’éclairage et les ombres de la photographie originale.

Concernant le pot de cactus, embellis-le afin qu’il se fonde mieux dans la composition finale. N’ajoute aucun élément décoratif.

Simulation d’un mur intérieur peint en bleu pétrole, avec interrupteurs, ouverture sur la cuisine et pot de cactus conservés.

Analyse

Les deux modifications demandées sont bien comprises. Le mur est recoloré en bleu pétrole sans déborder sur le plafond, le retour blanc, l’ouverture ou les interrupteurs. Le pot en terre cuite est également embelli et s’intègre mieux à la nouvelle palette. La pièce reste immédiatement reconnaissable et aucun élément décoratif n’est ajouté. Pour une simulation destinée à aider un client à se projeter, le niveau de précision est déjà convaincant.

🟢 8. Créer une miniature YouTube à partir d’un portrait

La miniature doit transformer un portrait existant en visuel de vidéo professionnel. Le visage doit rester identifiable et le titre lisible, sans reprendre les codes les plus caricaturaux de YouTube.

Portrait fourni à ChatGPT

Arnaud Anselmet_Photo de profil

Miniature générée

▶ Voir le prompt utilisé

À partir du portrait joint, crée une miniature YouTube professionnelle au format horizontal 16:9.

Texte exact : « CONTENUS IA : 3 ERREURS À ÉVITER »

Conserve fidèlement l’identité de la personne : forme du visage, âge apparent, coiffure, couleur des yeux, lunettes éventuelles et traits distinctifs. Garde une expression naturelle et déterminée, sans grimace ni exagération. Ne modifie pas sa morphologie.

Place la personne dans le tiers gauche, détourée proprement et cadrée à mi-buste. Oriente légèrement son regard vers le titre, placé dans les deux tiers droits. Le texte doit être très lisible en miniature, sur trois lignes maximum, sans masquer le visage.

Crée une direction graphique éditoriale contemporaine : fond bleu pétrole sombre, formes de papier superposées, annotations rouges inspirées des marques de correction et lumière douce autour du portrait. Utilise du blanc cassé pour le titre et réserve le rouge au chiffre « 3 » ainsi qu’à quelques annotations discrètes.

Recherche une composition dynamique mais crédible pour une chaîne professionnelle consacrée au marketing de contenu. Aucun robot, cerveau artificiel, logo, interface logicielle, flèche racoleuse ni emoji. N’ajoute aucun autre texte.

Miniature YouTube générée avec ChatGPT images. Portrait d’Arnaud Anselmet et le titre « Contenus IA : 3 erreurs à éviter ».

Analyse

La miniature est exploitable : le titre est reproduit sans erreur, reste lisible à petite taille et la composition reprend efficacement les codes de YouTube sans tomber dans la grimace ou les effets racoleurs. Mon visage reste reconnaissable, tout comme ma « coiffure », ma barbe et ma tenue, même si les traits et la peau ont été légèrement reconstruits et accentués selon moi. Le principal écart au prompt concerne le regard, toujours dirigé vers l’objectif alors que je demandais de l’orienter vers le titre. La proposition est convaincante pour une première version, avec une identité graphique cohérente et suffisamment professionnelle.

🟢 9. Concevoir et faire évoluer un stand de salon professionnel

Ce dernier essai est le plus ambitieux : transformer deux éléments de marque en un stand de salon professionnel cohérent, réaliste et théoriquement constructible. Pour cela, j’ai passé le logo du blog Conseils Rédaction Web, ainsi qu’un screenshot d’une des pages web du site, pour projection sur le mur du fond du stand.

La visualisation doit permettre d’évaluer une intention avant de solliciter un standiste.

Première proposition

▶ Voir le prompt de génération

À partir du logo et de la capture d’écran joints, crée une visualisation photoréaliste d’un stand pour un salon professionnel consacré au marketing, au SEO et à l’intelligence artificielle.

Le stand mesure environ 6 mètres sur 4 et s’ouvre sur deux côtés. Représente-le en perspective de trois quarts, dans un hall d’exposition contemporain.

Organise précisément quatre éléments :

  • un comptoir d’accueil à l’avant ;
  • un grand écran intégré au mur du fond, affichant fidèlement la capture d’écran fournie ;
  • un espace de discussion avec une table ronde et trois fauteuils ;
  • une enseigne suspendue au-dessus du stand, reprenant fidèlement le logo fourni.

Applique une identité graphique cohérente avec le logo : bleu pétrole dominant, surfaces ivoire, bois clair et accents orange. Utilise des matériaux réalistes, un éclairage architectural soigné et une signalétique bien intégrée aux volumes.

Texte exact à inscrire sur le mur principal :
« ÊTRE VISIBLE DANS GOOGLE ET LES IA »

Texte secondaire exact :
« AUDIT • CONTENU • FORMATION »

Conserve le logo sans le redessiner, le déformer ni modifier ses couleurs. La capture affichée sur l’écran doit rester reconnaissable : respecte sa structure, ses couleurs et ses principaux éléments d’interface.

Le stand doit sembler réellement constructible. Respecte les proportions, les circulations, les points d’appui, les jonctions entre matériaux et la cohérence des sources lumineuses.

N’ajoute aucun autre texte, logo, écran, comptoir ou espace fonctionnel. Aucun personnage, robot, hologramme, effet futuriste ou mobilier flottant.

Visualisation d’un stand de salon Conseils Rédaction Web avant itération d'amélioration avec ChatGPT

Résultat après itération

▶ Voir le prompt d’itération

À partir de cette première proposition, transforme la maquette en une photographie crédible d’un stand réellement installé et utilisé pendant un salon professionnel.

Conserve la structure générale du stand, son cadrage en trois quarts, le comptoir, le grand écran, l’espace de discussion, l’enseigne suspendue, le logo, les textes et la palette actuelle.

Apporte uniquement les évolutions suivantes :

  • réduis l’aspect trop lisse et artificiel du décor : rends plus naturels les textures du bois, des textiles et des panneaux, les jonctions entre les éléments, les reflets sur le sol et l’éclairage du hall ; atténue légèrement les liserés lumineux orange afin qu’ils ressemblent à un éclairage architectural réel ;
  • intègre dans la face avant du comptoir un écran horizontal discret. Il affiche le logo Conseils Rédaction Web et le texte exact « PARLONS DE VOTRE PROJET », sans autre contenu ;
  • ajoute une scène d’accueil naturelle au niveau du comptoir : un consultant se tient derrière celui-ci et échange avec un visiteur placé devant, vu principalement de dos. Leurs attitudes sont professionnelles et sobres. Ils ne doivent masquer ni le texte mural, ni le grand écran, ni l’espace de discussion.

Le résultat doit ressembler à une photographie prise pendant le montage final ou au début d’un salon, et non à une image de catalogue 3D. Conserve une composition lisible et haut de gamme.

Ne modifie pas le nombre de fauteuils, n’ajoute aucun autre mobilier, écran, texte ou personnage et ne recadre pas l’image.

Visualisation d’un stand de salon Conseils Rédaction Web avec deux professionnels au comptoir, un écran de présentation et un espace de discussion.

Analyse

L’itération ajoute correctement une scène d’accueil et un écran intégré au comptoir, ce qui donne davantage d’échelle et de fonction au stand. Le modèle ne se limite toutefois pas aux modifications demandées : il agrandit le comptoir, transforme l’arrière-plan et masque partiellement la signalétique secondaire. Ces changements n’apportent pas le gain de photoréalisme attendu : les matières et l’éclairage restent trop lisses pour donner l’impression d’une véritable photographie professionnelle. Le résultat constitue une bonne visualisation d’intention mais pas un visuel final pouvant être confondu avec la photo d’un stand réellement installé.

En conclusion, quels usages retenir pour vos visuels professionnels ?

ChatGPT Images 2.5 se montre particulièrement convaincant lorsqu’on lui confie un cadre précis : organiser des informations, partir d’une image de référence, retoucher un élément ciblé, décliner un visuel ou matérialiser rapidement une direction créative.

Les résultats deviennent plus incertains lorsque la demande cumule les contraintes : photoréalisme complexe, fidélité absolue à une référence ou nombreuses retouches successives.

Avant publication, trois vérifications restent indispensables : les textes, les éléments qui devaient rester inchangés et le rendu à sa taille réelle d’utilisation.

ChatGPT Images 2.5 peut donc déjà produire certains visuels professionnels finalisés. Mais la génération s’automatise davantage que la validation : le contrôle humain reste nécessaire.